







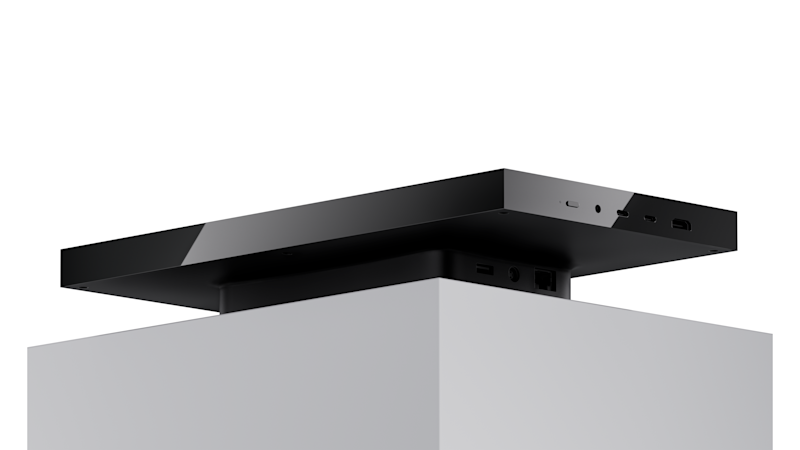
Microsoft a dévoilé lundi la Surface RTX Spark Dev Box, un ordinateur de bureau compact conçu pour permettre aux développeurs de logiciels d’exécuter de grands modèles d’IA sur leur bureau au lieu de payer pour le cloud computing – une décision qui remet directement en question le modèle de tarification par jeton qui a défini l’économie de l’industrie de l’IA depuis le lancement de ChatGPT il y a trois ans et demi.
L’appareil, annoncé lors de Microsoft Build 2026, intègre le nouveau processeur RTX Spark à architecture Blackwell de Nvidia et 128 Go de mémoire unifiée dans un châssis à petit facteur de forme, offrant ce que Nvidia évalue à un pétaflop de calcul d’IA. Concrètement, cela signifie qu’un développeur peut charger, exécuter et interagir avec des modèles d’IA dépassant 120 milliards de paramètres sans envoyer un seul appel API vers le cloud.
«Nous pensons que cette classe d’appareils atteindra environ 100 milliards de paramètres en fonctionnement», a déclaré Pavan Davuluri, vice-président exécutif de Windows et des appareils de Microsoft, lors d’un point de presse précédant l’événement. Il a souligné que la taille brute du modèle n’est qu’une partie de l’équation : « La taille du modèle est une chose, mais pour que le modèle soit efficace, il doit en quelque sorte pouvoir avoir suffisamment de contexte, car un modèle plus grand, vous lui alimentez un contexte plus large. Avec 100 000 jetons de contexte, a-t-il noté, le cache clé-valeur peut à lui seul consommer 40 à 50 Go de mémoire – c’est précisément pourquoi Microsoft et Nvidia ont conçu l’appareil autour d’un pool de mémoire unifié de 128 Go partagé dynamiquement entre le CPU et le GPU.
La machine sera disponible plus tard cette année aux États-Unis, vendue exclusivement via Microsoft.com. L’entreprise n’a pas divulgué les prix.
Pourquoi Microsoft parie que l’avenir de l’IA repose sur des coûts fixes et non sur des compteurs de nuages
La Surface RTX Spark Dev Box arrive à un moment où l’économie du développement de l’IA est devenue une préoccupation au niveau des conseils d’administration. Les entreprises, grandes et petites, sont aux prises avec des factures de GPU cloud qui évoluent de manière imprévisible : chaque opération de réglage fin, chaque appel d’inférence, chaque flux de travail agent qui parcourt un modèle frontière accumule des coûts. Pour un développeur itérant rapidement sur un prototype – exécutant le même modèle des dizaines ou des centaines de fois par jour – ces frais s’accumulent rapidement.
Microsoft présente la Dev Box comme une soupape de décharge pour cette pression. Andrew Hill, vice-président de Surface, a écrit dans le blog d’annonce que l’appareil «change cette équation» en permettant aux développeurs de «réserver les appels du modèle frontière pour les problèmes véritablement frontières et de gérer le reste sur leur propre matériel». L’argument n’est pas que le cloud computing soit obsolète, mais qu’une grande partie du travail actuellement envoyé vers des centres de données distants ne nécessite pas de modèles de pointe et serait mieux servie par un matériel local performant avec des coûts fixes et prévisibles.
Il s’agit d’un changement stratégique important pour Microsoft, une entreprise qui tire des dizaines de milliards de dollars de revenus annuels des services cloud Azure. En vendant du matériel qui réduit explicitement la dépendance des clients au cloud, Microsoft reconnaît une tension qui s’est développée dans l’ensemble du secteur : le coût marginal de l’inférence de l’IA à grande échelle est insoutenable pour de nombreuses équipes, et le marché exige des alternatives. Le pari semble être que les développeurs qui prototypent localement continueront à déployer sur Azure lorsqu’ils auront besoin d’évoluer – et que posséder les deux extrémités de ce flux de travail est plus précieux que de posséder uniquement le cloud.
À l’intérieur de l’architecture de mémoire unifiée de 128 Go qui rend possible l’IA locale
L’architecture technique de la Dev Box reflète un ensemble de choix d’ingénierie délibérés visant des performances soutenues et non optimales – une distinction qui est extrêmement importante pour les charges de travail d’IA qui peuvent s’exécuter pendant des heures.
Au centre se trouve le système sur puce RTX Spark de Nvidia, qui combine un processeur ARM ultra-efficace avec un GPU RTX de génération Blackwell. Dans un PC Windows traditionnel, a expliqué Davuluri lors du briefing, cette configuration nécessiterait quatre composants distincts : un processeur, un GPU discret, une mémoire graphique dédiée et une RAM système. Le RTX Spark regroupe tout cela en une seule puce associée à un seul pool de mémoire unifié.
Cette unification est la décision de conception critique. Les ordinateurs portables de jeu conventionnels équipés de GPU Nvidia haut de gamme atteignent environ 24 Go de mémoire accessible par GPU. Les 128 Go de mémoire unifiée de la Dev Box – accessibles à la fois au CPU et au GPU via ce que Nvidia appelle son architecture d’accès à la mémoire unifiée – permettent de charger des modèles qui nécessiteraient autrement des instances GPU cloud avec des configurations de mémoire spécialisées à large bande passante.
Microsoft a réalisé un travail conséquent au niveau du système d’exploitation pour exploiter cette architecture. La société a mis en œuvre une nouvelle logique de gestion de la mémoire dans Windows qui relève le plafond de la quantité de mémoire système que le GPU peut gérer, introduit une allocation plus intelligente de la taille des pages pour les régions de mémoire partagée et garantit que les lourdes charges de travail du GPU ne privent pas le processeur des ressources dont il a besoin pour le multitâche. Le planificateur Windows a également été optimisé pour la disposition hétérogène des cœurs de RTX Spark, acheminant les charges de travail exigeantes vers les cœurs de performances tout en gardant les cœurs d’efficacité disponibles pour les tâches en arrière-plan.
Comment un châssis en aluminium imprimé en 3D sert également de dissipateur thermique
La conception thermique est également délibérée. La Dev Box fonctionne dans une enveloppe thermique soutenue d’environ 100 watts – modeste par rapport aux normes d’un ordinateur de bureau, mais significative pour un appareil destiné à exécuter des tâches de formation et des charges de travail d’inférence en continu. Le châssis en aluminium lui-même est conçu pour fonctionner comme un dissipateur thermique passif, et la méthode utilisée par Microsoft pour le construire compte parmi les détails les plus frappants de la machine.
Le panneau supérieur est fabriqué par impression 3D métallique, un processus qui permet d’obtenir des géométries internes trop complexes pour l’usinage CNC conventionnel ou le moulage par injection. Les perforations ne sont pas de simples trous traversants ; ils sont inclinés dans plusieurs directions autour du ventilateur interne pour optimiser le flux d’air depuis l’admission d’air froid jusqu’à la dissipation de la chaleur. Lors de la conférence de presse, Harry, un designer industriel de Surface, a expliqué la raison : « La complexité est quelque chose que d’autres fabricants ne seraient pas capables de faire, comme la CNC ou n’importe quel moulage, en raison de la complexité de la forme. »
Lorsqu’on lui a demandé si l’impression 3D limiterait la production de masse, le concepteur a reconnu le défi mais a suggéré que Microsoft avait développé un processus suffisamment robuste pour pouvoir évoluer. Le résultat est une machine qui fonctionne suffisamment silencieusement pour un bureau ouvert tout en supportant le type de charges de travail GPU continues qui limiteraient la plupart des ordinateurs de bureau conventionnels de taille similaire. Pour un appareil que Microsoft s’attend à ce que les développeurs laissent fonctionner du jour au lendemain pour des tâches de réglage précis, des performances silencieuses et soutenues ne sont pas un luxe, c’est une exigence.
Une configuration axée sur les développeurs qui élimine des heures de configuration
Microsoft livre la Dev Box avec Windows 11 Pro préconfiguré au niveau de l’image pour le travail de développement – un détail qui semble mineur mais reflète une reconnaissance croissante du fait que l’expérience prête à l’emploi pour le matériel de développement a toujours été médiocre.
La machine démarre dans un thème sombre avec une barre des tâches simplifiée, les widgets supprimés et Ne pas déranger activé. Le mode développeur est activé. PowerShell 7 est le shell par défaut. WSL 2 – le sous-système Windows pour Linux – est préinstallé avec le relais GPU et la prise en charge CUDA déjà configurés. Visual Studio Code, GitHub Copilot, Git, Python et Node.js sont tous installés et prêts.
«Nous avons dit: ‘Hé, vous savez quoi, nous vous avons, vous voulez aller vite'», a déclaré à VentureBeat un ingénieur Microsoft qui a démontré la configuration lors du briefing. La philosophie, a-t-il expliqué, est que les développeurs allaient installer tous ces outils de toute façon – la friction résidait dans les heures d’installation et de configuration entre le déballage d’une machine et l’écriture de la première ligne de code.
La Dev Box est également livrée avec des points d’intégration dans la pile IA de Microsoft : AI Toolkit for VS Code pour la conversion et le réglage fin du modèle, Windows ML et Windows Copilot Runtime pour l’inférence locale et Microsoft Foundry pour connecter des prototypes locaux aux pipelines de déploiement cloud. Pour les entreprises, l’appareil s’intègre à Entra ID et Intune pour la gestion des identités et des appareils, et comprend une architecture PC à noyau sécurisé, le cryptage BitLocker et Microsoft Defender.
Pourquoi le Mac Mini d’Apple n’est peut-être plus le véritable concurrent
La comparaison concurrentielle la plus évidente est celle du Mac Mini d’Apple, qui a dominé la catégorie des ordinateurs de bureau compacts et a été largement adopté par les développeurs attirés par l’architecture de mémoire unifiée et l’efficacité énergétique d’Apple Silicon.
Davuluri a abordé la comparaison directement lors du briefing, affirmant que la Dev Box est « intentionnellement dans une classe de performances différente de celle des Mac Mini ». Il a refusé de partager des références spécifiques, notant que les spécifications détaillées et les objectifs de performance se rapprocheraient du lancement à l’automne. Mais l’avantage architectural revendiqué par Microsoft est clair : alors que le Mac Mini actuel avec M4 Pro atteint 48 Go de mémoire unifiée et que la configuration M4 Max atteint 128 Go, la RTX Spark Dev Box associe ses 128 Go à un GPU de classe Blackwell qui a un modèle de calcul basé sur CUDA fondamentalement différent – un modèle que la grande majorité des outils de l’écosystème AI/ML (PyTorch, TensorRT, llama.cpp, frameworks Hugging Face) est déjà optimisé pour.
Il est difficile de surestimer cet avantage de l’écosystème CUDA. Bien que le framework Metal d’Apple ait progressé, l’écrasante majorité des frameworks de formation et d’inférence en IA sont d’abord construits et testés sur la pile CUDA de Nvidia. Un développeur exécutant des modèles sur Dev Box peut utiliser le même code, les mêmes bibliothèques et les mêmes flux de travail qu’ils utiliseraient sur une instance GPU cloud – un niveau de portabilité qu’Apple Silicon ne peut actuellement pas égaler.
De l’ordinateur portable au superordinateur : le plan à trois niveaux de Microsoft pour le matériel d’IA local
La Dev Box fait partie d’une stratégie matérielle à trois niveaux présentée par Microsoft lors de Build. Le Surface Laptop Ultra, annoncé quelques jours plus tôt au Computex, intègre le même silicium RTX Spark dans un format d’ordinateur portable de 15 pouces pour les développeurs et les créateurs qui ont besoin de portabilité. À l’autre extrémité du spectre, la DGX Station pour Windows — construite sur la superpuce GB300 Grace Blackwell Ultra de Nvidia — cible les organisations qui ont besoin d’exécuter des modèles pionniers jusqu’à un billion de paramètres sur un système de bureau. Cette machine est attendue pour le quatrième trimestre de cette année.
Les trois appareils correspondent à un modèle informatique à plusieurs niveaux que Microsoft appelle « intelligence illimitée » : de petits modèles de langage intégrés à l’appareil (la nouvelle famille Aion 1.0 de la société) gèrent des tâches légères à un coût marginal nul ; Le matériel de classe RTX Spark exécute localement des modèles de milieu de gamme pour l’essentiel du travail de développement ; et les ressources cloud sont réservées à des problèmes véritablement à l’échelle des frontières.
La CLI GitHub Copilot obtient une implémentation concrète de ce modèle avec une nouvelle fonctionnalité appelée /fleet, qui permet à un agent principal basé sur le cloud de créer un plan, d’évaluer la complexité de chaque tâche et d’acheminer les sous-tâches appropriées vers un modèle local exécuté sur le matériel du développeur. L’agent cloud gère ce qui nécessite des capacités de pointe ; le modèle local gère ce qui ne le fait pas. Le résultat, en théorie, est un coût moindre sans une qualité moindre.
La vraie question est de savoir si l’IA hybride peut passer du mot à la mode au modèle économique.
La réussite du pari de Microsoft dépend de questions auxquelles il faudra des mois pour répondre. Comment la Dev Box fonctionne-t-elle réellement sous des charges de travail soutenues et réelles ? Combien cela coûtera-t-il ? À quelle vitesse l’écosystème de modèles open source continuera-t-il à produire des modèles performants dans la plage de 70 à 120 milliards de paramètres qui s’inscrivent dans son enveloppe de mémoire ? Et peut-être le plus important : les équipes d’approvisionnement des entreprises, formées à considérer l’IA comme un élément de ligne cloud, accepteront-elles une dépense d’investissement en matériel de bureau comme alternative ?
La logique stratégique est cependant difficile à écarter. Pendant trois ans, l’industrie de l’IA a fonctionné sur la base d’une hypothèse implicite : les travaux sérieux en matière d’IA se déroulent dans le cloud, et l’économie de cet arrangement réside simplement dans le coût des affaires. Microsoft, une entreprise qui a tout intérêt à renforcer cette hypothèse, vend désormais une machine qui la mine. Ce n’est pas une contradiction : c’est une reconnaissance du fait que le marché évolue et que l’entreprise qui contrôle l’environnement local du développeur et le cloud sur lequel il déploie dispose d’un avantage plus durable que celle qui contrôle uniquement le cloud.
Chaque dollar qu’un développeur ne dépense pas en inférence cloud est un dollar qui peut financer une autre expérience, une autre itération, un autre prototype. Pendant des années, l’industrie de l’IA a dit aux développeurs qu’ils devaient louer leur intelligence au jeton. Microsoft pose désormais une question différente : et si vous pouviez simplement l’acheter ?


Suscríbete y recibe las historias más importantes del día.
Al suscribirte aceptas nuestros términos y condiciones y política de privacidad.