









Las pilas de datos empresariales se diseñaron para humanos que ejecutan consultas planificadas. A medida que los agentes de IA actúan cada vez más de forma autónoma en nombre de las empresas, las 24 horas del día, esta arquitectura se está desmoronando y los proveedores se apresuran a reconstruirla. La respuesta de Google, anunciada el miércoles en Cloud Next, es Agentic Data Cloud.
La arquitectura se basa en tres pilares:
-
Catálogo de conocimientos. Automatiza la curación semántica de metadatos, infiriendo la lógica empresarial a partir de registros de consultas sin intervención manual del administrador de datos.
-
Lakehouse a través de las nubes. Permite a BigQuery consultar tablas de Iceberg en AWS S3 a través de una red privada sin cargos de salida
-
Kit de agente de datos. Inserta herramientas MCP en VS Code, Claude Code y Gemini CLI para que los ingenieros de datos describan los resultados en lugar de escribir canalizaciones.
«La arquitectura de datos debe cambiar ahora», dijo a VentureBeat Andi Gutmans, vicepresidente y director general de Data Cloud en Google Cloud. «Estamos pasando de la escala humana a la escala de agentes».
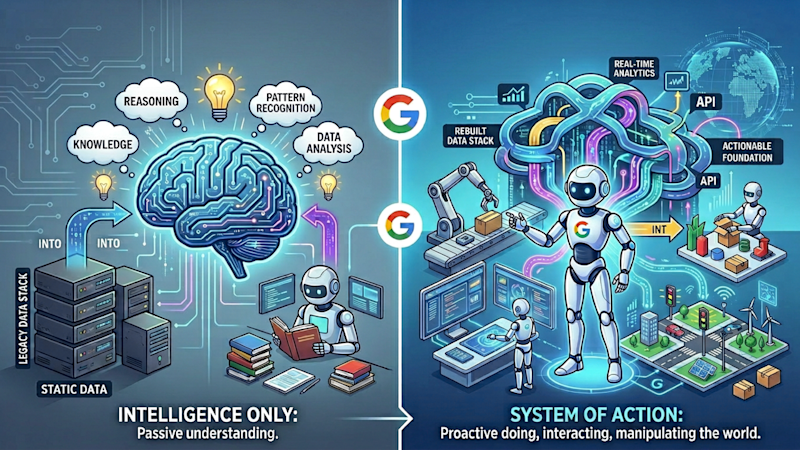
Del sistema de inteligencia al sistema de acción
El principio fundamental detrás de Agentic Data Cloud es que las empresas están pasando de operaciones a escala humana a operaciones a escala de agentes.
Históricamente, las plataformas de datos se han optimizado para generar informes, paneles y algunos pronósticos, lo que Google llama “inteligencia receptiva”. En este modelo, los humanos interpretan los datos y deciden qué hacer.
Hoy en día, a medida que se espera cada vez más que los agentes de IA actúen directamente en nombre de la empresa, Gutmans dice que las plataformas de datos deben evolucionar hacia sistemas de acción. «Necesitamos asegurarnos de que todos los datos empresariales puedan habilitarse con IA, incluidos los datos estructurados y no estructurados», dijo Gutmans. «Necesitamos asegurarnos de que exista un nivel adecuado de confianza, lo que también significa que no se trata sólo de acceder a los datos, sino de comprenderlos».
El Catálogo de conocimientos es la respuesta de Google a este problema. Es una evolución de Dataplex, el producto de gestión de datos existente de Google, con una arquitectura subyacente significativamente diferente. Mientras que los catálogos de datos tradicionales requerían que los administradores de datos etiquetaran tablas manualmente, definieran términos comerciales y crearan glosarios, el Catálogo de conocimientos automatiza este proceso mediante agentes.
La implicación práctica para los equipos de ingeniería de datos es que el catálogo de conocimientos abarca todo el conjunto de datos, no solo el subconjunto seleccionado que un pequeño equipo de administradores de datos puede gestionar manualmente. El catálogo cubre de forma nativa BigQuery, Spanner, AlloyDB y Cloud SQL y se federa con catálogos de terceros, incluidos Collibra, Atlan y Datahub. La federación de copia cero amplía el contexto semántico de las aplicaciones SaaS, incluidas SAP, Salesforce Data360, ServiceNow y Workday, sin requerir movimiento de datos.
Lakehouse de Google va a la nube
Google tenía un lago de datos llamado GrandLac desde 2022. Inicialmente se limitaba solo a los datos de Google, pero en los últimos años ha tenido capacidades de federación limitadas que permiten a las empresas consultar datos encontrados en otras ubicaciones.
Gutmans explicó que la federación anterior trabajaba a través de API de consulta, lo que limitaba las funciones y optimizaciones que BigQuery podía aportar a los datos externos. El nuevo enfoque consiste en compartir almacenamiento a través del formato abierto Apache Iceberg. Esto significa que, según él, da igual si los datos están en Amazon S3 o en Google Cloud. «Realmente significa que podemos llevar toda la calidad y capacidades de la IA a estos conjuntos de datos de terceros», afirmó.
El resultado práctico es que BigQuery puede consultar tablas Iceberg ubicadas en Amazon S3 a través de Cross-Cloud Interconnect de Google, una capa de red privada dedicada, sin tarifas de salida y con una relación precio-rendimiento comparable a los almacenes nativos de AWS, según Google. Todas las funciones de BigQuery AI se ejecutan en estos datos entre nubes sin modificaciones. La federación bidireccional de vista previa se extiende a Databricks Unity Catalog en S3, Snowflake Polaris y AWS Glue Data Catalog mediante el estándar abierto Iceberg REST Catalog.
De escribir pipelines a describir resultados
Knowledge Catalog y Lakehouse entre nubes resuelven problemas de contexto y acceso a datos. El tercer pilar trata de lo que sucede cuando un ingeniero de datos se sienta a crear algo con todo esto.
El kit de agente de datos se envía como un conjunto portátil de habilidades, herramientas MCP y extensiones IDE que se integran en VS Code, Claude Code, Gemini CLI y Codex. No introduce una nueva interfaz.
El cambio arquitectónico que permite es un paso de lo que Gutmans llama una “experiencia de copiloto prescriptiva” a una ingeniería basada en intenciones. En lugar de escribir una canalización de Spark para mover datos del origen A al destino B, un ingeniero de datos describe el resultado (un conjunto de datos limpio y listo para el entrenamiento del modelo, una transformación que aplica una regla de gobernanza) y el agente elige si usar BigQuery, Lightning Engine para Apache Spark o Spanner para ejecutarlo, luego genera código listo para producción.
«Los clientes están cansados de construir sus propios oleoductos», afirmó Gutmans. «En realidad, están más en modo de revisión que en modo de escritura de código».
Donde divergen Google y sus competidores
El principio de que los agentes necesitan un contexto semántico, no sólo acceso a los datos, es compartido en todo el mercado.
Databricks tiene Unity Catalog, que proporciona gobernanza y una capa semántica en su Lakehouse. Snowflake ofrece Cortex, su oferta de capa semántica e inteligencia artificial. Tela de Microsoft incluye una capa de modelo semántico diseñada para inteligencia empresarial y, cada vez más, conexión a tierra de agentes.
El debate no gira en torno a si la semántica importa: todo el mundo está de acuerdo en que sí importa. La disputa es sobre quién los construye y mantiene.
«Nuestro objetivo es simplemente obtener toda la semántica que podamos», explicó, señalando que Google se federará con modelos semánticos de terceros en lugar de exigir a los clientes que empiecen de nuevo.
Google también está posicionando la apertura como un diferenciador, con una federación bidireccional en Databricks Unity Catalog y Snowflake Polaris a través del estándar abierto Iceberg REST Catalog.
Qué significa esto para las empresas
El argumento de Google –y que tiene eco en el mercado de infraestructura de datos– es que las empresas están atrasadas en tres frentes:
El contexto semántico se convierte en una infraestructura. Si su catálogo de datos todavía se selecciona manualmente, no se ampliará con las cargas de trabajo de los agentes, y Gutmans dice que la brecha solo se ampliará a medida que aumenten los volúmenes de consultas de los agentes.
Los costos de salida entre nubes son un impuesto oculto sobre la IA agente. La federación basada en almacenamiento a través de estándares abiertos Iceberg parece ser la respuesta arquitectónica en Google, Databricks y Snowflake. Las empresas atrapadas en enfoques de federación patentados deberían probar estos costos a la escala de los volúmenes de consultas de los agentes.
Gutmans dice que la era de la escritura sobre tuberías está llegando a su fin. Los ingenieros de datos que ahora avanzan hacia la orquestación basada en resultados tendrán una ventaja significativa.


Suscríbete y recibe las historias más importantes del día.
Al suscribirte aceptas nuestros términos y condiciones y política de privacidad.