







En este momento, todos los laboratorios de inteligencia artificial de vanguardia están racionando dos cosas: electricidad y computación. La mayoría compra sus modelos de ordenador para formación al mismo proveedor, con elevados márgenes brutos que han convertido a Nvidia en una de las empresas más valiosas del mundo. Google no hace esto.
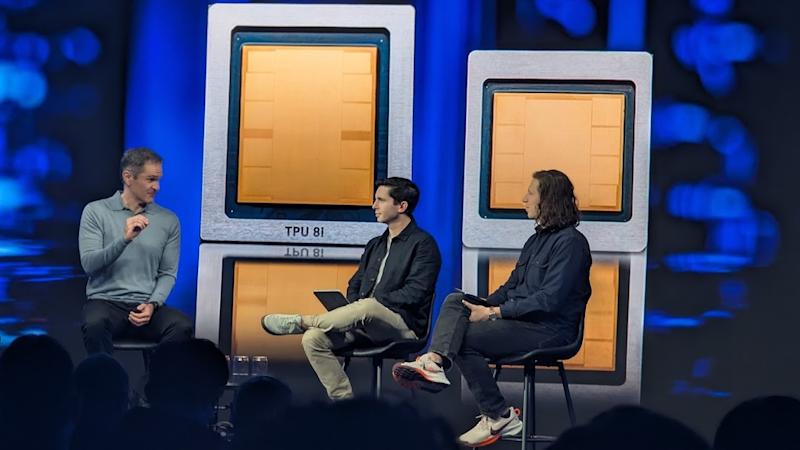
El martes por la noche, en una reunión privada en el F1 Plaza de Las Vegas, Google presentó una vista previa de sus unidades de procesamiento Tensor de octava generación. El argumento: dos diseños de silicio personalizados que se lanzarán a finales de este año, cada uno de ellos diseñado específicamente para una mitad diferente de la carga de trabajo de IA moderna. TPU 8t apunta al entrenamiento para modelos de frontera, y TPU 8i apunta al mundo de la inferencia agente y el muestreo en tiempo real de baja latencia y uso intensivo de memoria.
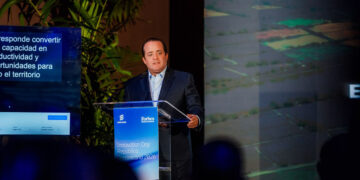
Amin Vahdat, vicepresidente senior de Google y tecnólogo jefe de infraestructura e inteligencia artificial (en la foto arriba a la izquierda), usó su tiempo en el escenario para señalar un punto que importa más a los compradores empresariales que cualquier especificación individual: Google diseña cada capa de su pila de inteligencia artificial de extremo a extremo, y esa integración vertical está comenzando a aparecer en la economía de costo por token que Google dice que sus competidores no pueden igualar.
“Un chip al año no era suficiente”: en la apuesta de Google para 2024 por una hoja de ruta de dos chips
La historia más interesante detrás de v8t y v8i es donde se tomó la decisión de dividir la hoja de ruta. La convocatoria tuvo lugar en 2024, según Vahdat, un año antes de que la industria en su conjunto recurra a modelos de razonamiento, agentes y aprendizaje por refuerzo como carga de trabajo dominante.
En ese momento, estaba leyendo a contracorriente. «Hace dos años nos dimos cuenta de que un chip al año no sería suficiente», dijo Vahdat en la fiesta. «Este es nuestro primer intento de utilizar dos chips especializados de muy alta potencia».
Para los compradores de empresas, las implicaciones son concretas. Clientes que brindan capacitación avanzada o a gran escala en Google Cloud y clientes que atienden a agentes de producción en Cumbre de IA Alquilé los mismos aceleradores y comí ineficiencia. El V8 es la primera generación en la que el propio silicio trata estos problemas como problemas diferentes con dos conjuntos de chips.
TPU 8t: un tejido de entrenamiento que se adapta a un millón de chips
Sobre el papel, el TPU 8t es un paso generacional agresivo. Según Google, 8t ofrece 2,8 veces los EFlops FP4 por módulo (121 frente a 42,5) en comparación con Ironwood, el TPU de séptima generación que se enviará en 2025, duplica el ancho de banda bidireccional a 19,2 Tbps por chip y cuadriplica la red escalable a 400 Gbps por chip. Los tamaños de los pods aumentan ligeramente, de 9.216 a 9.600 chips, mantenidos unidos por la topología 3D Torus de Google.
El número que más importa a los gerentes de TI que evalúan dónde realizar la capacitación a escala fronteriza: los clústeres de 8t (Superpods) pueden escalar más de un millón de chips TPU en una sola tarea de capacitación a través de una nueva interconexión que Google llama Red Virgo.
8t también presenta TPU Direct Storage, que mueve datos desde el nivel de almacenamiento administrado de Google directamente a HBM sin los saltos habituales a través de la CPU. Para sesiones de entrenamiento largas donde el tiempo del reloj de pared es el factor que genera costos, reducir esta ruta de datos reduce la cantidad de horas de pod necesarias para completar cada época.
TPU 8i y Boardfly: reingeniería de redes para agentes
Si 8t es un paso evolutivo, TPU 8i es el chip con mayor interés arquitectónico. Aquí es también donde la historia de los compradores de TI se vuelve más convincente.
Los saltos en las especificaciones de un año a otro son, como dice Vahdat, “asombrosos”. Según Google, 8i ofrece EFlops FP8 de 9,8 veces por módulo (11,6 frente a 1,2), capacidad de HBM 6,8 veces mayor por módulo (331,8 TB frente a 49,2) y un tamaño de módulo que aumenta 4,5 veces de 256 a 1152 chips.
Lo que impulsó estas cifras fue una revisión de la propia red. Vahdat explicó esta idea directamente: la forma predeterminada de Google de conectar chips admitía ancho de banda sobre latencia, lo cual es excelente para mover grandes cantidades de datos, pero no está diseñado para el tiempo mínimo que se necesita para obtener una respuesta. Este perfil sirve para la formación. Para los agentes, este no es el caso. En asociación con Google DeepMind, el equipo de TPU creó lo que Google llama la topología Boardfly específicamente para reducir el diámetro de la red, reduciendo así la cantidad de saltos entre dos chips en un módulo. Combinado con un motor de aceleración colectiva y lo que Google describe como SRAM en chip muy grande, 8i ofrece una latencia 5 veces mejorada para muestreo LLM en tiempo real y aprendizaje por refuerzo.
La brecha de integración vertical: por qué Google no paga el «impuesto Nvidia»
El subtexto de la presentación de Vahdat fue un diagrama de seis capas que Google llama su pila de IA: energía en la base, luego terreno y recintos del centro de datos, hardware de infraestructura de IA, software de infraestructura de IA, modelos (Gemini 3) y servicios en la parte superior. Vahdat señaló que diseñar cada capa de forma aislada requiere encontrar el mínimo común denominador para cada capa. Google los diseña juntos.
Aquí es donde cristaliza la historia competitiva para los compradores y analistas de TI. OpenAI, Anthropic, xAI y Meta dependen en gran medida del silicio de Nvidia para entrenar sus modelos pioneros. Cada GPU H200 y Blackwell que compran genera la ganancia bruta del centro de datos de Nvidia: el «impuesto Nvidia» informal que los analistas de la industria han señalado durante dos años consecutivos como una desventaja de costos estructurales para cualquiera que alquile en lugar de construir. Google cubre los costos de fabricación, embalaje e ingeniería de sus TPU. No paga este margen.

Qué significa v8 para la carrera informática: una nueva lista de verificación de evaluación para líderes de TI
Para los equipos de adquisiciones e infraestructura, TPUv8 reformula la evaluación de la nube 2026-2027 de manera práctica.
Los equipos que entrenan grandes modelos propietarios deben considerar ventanas de tiempo de actividad de 8t, acceso a la red Virgo y buenos SLA, no solo titulares de EFlops. Los equipos que atienden a agentes o cargas de trabajo de razonamiento deben evaluar la disponibilidad de 8i en Vertex AI, los puntos de referencia de latencia independientes a medida que surjan y si el tamaño de HBM por módulo coincide con sus ventanas emergentes. Los equipos que utilizan Gemini a través de Gemini Enterprise deberían heredar el ascensor 8i y deberían esperar que el límite de lo que pueden implementar en producción aumente significativamente hasta 2026.
Las advertencias son reales. La disponibilidad general aún es «más adelante en 2026». La versión 8 es una señal de hoja de ruta, no una decisión de compra actual. Los puntos de referencia de Google son autoinformados; No hay duda de que las cifras independientes provendrán de los primeros clientes de la nube y de evaluadores externos durante los próximos dos trimestres. Y la portabilidad entre JAX/XLA y el ecosistema CUDA/PyTorch sigue siendo un costo de fricción que vale la pena considerar al negociar un compromiso de varios años.
Mirando más allá, Vahdat hizo dos predicciones dignas de mención. En primer lugar, los procesadores de uso general resurgirán dentro de los sistemas de IA, no como aceleradores, sino como computación de orquestación para entornos aislados de agentes, máquinas virtuales y ejecución de herramientas. En segundo lugar, la especialización, enmarcada explícitamente como una predicción de la industria más que como una vista previa de la hoja de ruta de Google, también sigue siendo fuerte. A medida que los procesadores de uso general se estabilicen en un pequeño porcentaje anual, las grandes cargas de trabajo requerirán silicio diseñado específicamente. «Dos chips podrían convertirse en más», dijo Vahdat, sin especificar si «más» significaría futuras variantes de TPU u otras clases de aceleradores especializados.
Solía ser que la carrera informática fronteriza giraba en torno a quién podía comprar la mayor cantidad de H100. Ahora se trata de quién controla la pila. La lista corta de empresas que realmente están haciendo esto es, por el momento, dos: Google y Nvidia.


Suscríbete y recibe las historias más importantes del día.
Al suscribirte aceptas nuestros términos y condiciones y política de privacidad.