






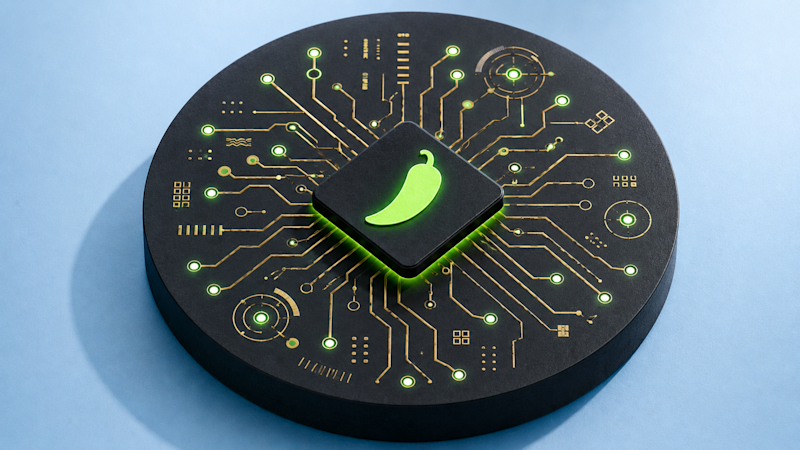
OpenAI et Broadcom ont dévoilé ce matin leur première puce d’accélérateur d’IA personnalisée nommée «Jalapeño», la positionnant comme un processeur spécialement conçu pour l’inférence de grands modèles de langage (LLM), plutôt que les GPU plus généraux proposés par Nvidia ou AMD.
Selon ses créateurs, Jalapeño est conçu pour prendre en charge les charges de travail derrière ChatGPT, Codex, l’API et les futurs produits agentiques, bien que les communiqués de presse d’OpenAI et de Broadcom le positionnent notamment comme un produit qui pourrait également être mis à la disposition des sociétés d’IA externes – » construit à partir de zéro pour les LLM actuels et futurs. dans l’ensemble de l’industrie.» [Emphasis mine.]
Selon Bloomberg, cela réduirait les coûts d’inférence d’environ 50 %. L’inférence de rappel se produit lorsque le modèle d’IA fini est proposé aux utilisateurs finaux, alors que les coûts de formation, de recherche et de développement restent élevés.
Le calendrier d’ingénierie de Jalapeño a établi un rythme effréné pour l’industrie des semi-conducteurs, passant des premiers schémas à la préparation à la fabrication dans un bref délai de neuf mois, alors que les cycles de développement de nouveaux processeurs se mesurent généralement en années. En effet, le partenariat OpenAI et Broadcom lui-même n’a été annoncé publiquement qu’en octobre 2025.
Les entreprises attribuaient cette vitesse à une profonde expertise logicielle et matérielle. processus de co-développement utilisant activement les propres modèles d’OpenAI pour accélérer certaines parties de la conception de la puce. Des sources proches des entreprises ont déclaré à VentureBeat que le processus de développement reposait sur des modèles OpenAI de génération précédente, bien qu’un porte-parole d’OpenAI ait refusé de préciser lesquels lorsque VentureBeat lui a demandé.
Après avoir reçu un premier modèle physique mercredi, OpenAI a présenté son intention de commencer à déployer ces processeurs dans les centres de données actifs d’ici la fin de cette année. OpenAI indique avoir déjà commencé à tester l’exécution d’au moins un de ses modèles de génération précédente, GPT‑5.3‑Codex‑Spark, sur les puces avec une charge de travail de production, mais dans un environnement de test.
Cette version marque une expansion stratégique majeure pour le créateur de ChatGPT, car il tente de créer la pile informatique complète requise pour rendre l’IA avancée plus rapide, plus fiable et plus accessible.
Il reste bien sûr de nombreuses questions en suspens, notamment les performances de la nouvelle puce Jalapeño par rapport à ses concurrents directs, ses coûts et sa viabilité de fabrication. Des sources proches de l’entreprise ont déclaré que la performance initiale elle-même était (ironiquement) : « exceptionnelle ».
Greg Brockman, président et co-fondateur d’OpenAI et de Broadcom est apparu ce matin sur CNBC aux côtés du PDG de Broadcom, Hock Tan, pour discuter de l’actualité, et Brockman a noté dans l’interview que «il s’agit d’une véritable amélioration des performances… en termes de performances par watt et de performances par dollar. » Dans un article séparé sur X, Brockman a écrit que « Perf[ormance] par watt, c’est incroyable.»
Pourquoi OpenAI a construit un ASIC
Pour comprendre pourquoi OpenAI se lance dans la conception de puces, il est utile d’examiner l’architecture. Jalapeño est un circuit intégré spécifique à une application, ou ASIC.
Contrairement à un GPU, qui peut gérer de nombreux types de charges de travail, un ASIC est conçu pour des utilisations plus restreintes, comme le notent les experts du secteur. Cette focalisation plus étroite peut le rendre moins cher et plus efficace pour des tâches d’IA spécifiques, bien que moins adaptable que les GPU de style Nvidia.
Dans le cas de Jalapeño, OpenAI part d’une conception épurée axée sur le service LLM moderne, au lieu d’adapter un accélérateur plus large pour répondre à ses besoins. La société affirme que l’architecture est façonnée par son expérience dans l’exécution de produits d’IA à grande échelle et vise à réduire les mouvements de données inutiles tout en faisant mieux correspondre les ressources de calcul, de mémoire et de réseau.
Broadcom contribue à la mise en œuvre de silicium de base et à la technologie de mise en réseau, notamment le silicium de réseau Tomahawk, tandis que Celestica contribue à l’intégration des cartes, des racks et des systèmes. L’objectif est de rapprocher la puce de son plafond de performances pratique dans des charges de travail réelles, et pas seulement d’améliorer les références théoriques.
Cependant, le tournant d’OpenAI vers du matériel propriétaire n’est pas seulement une quête de suprématie technique : il peut également rendre l’économie de son unité centrale beaucoup plus durable.
Des documents financiers vérifiés publiés récemment par le critique de l’IA et spécialiste des relations publiques en IA, Ed Zitron, ont révélé que même si OpenaAI a généré un chiffre d’affaires impressionnant de 13,07 milliards de dollars tout au long de 2025, ses dépenses opérationnelles totales pour l’année ont grimpé à 34 milliards de dollars, entraînant une perte d’exploitation de près de 20,92 milliards de dollars.
Le principal responsable de cette hémorragie financière concerne les exigences de calcul pures, même si cela est probablement dû davantage à la formation qu’à l’inférence.
Rien qu’en 2025, les coûts de recherche et de développement, largement tributaires de l’infrastructure requise pour former et servir des modèles de langage massifs, représentaient 19,18 milliards de dollars, soit environ 56 % de l’ensemble des dépenses de l’entreprise. En outre, OpenAI aurait payé à Microsoft plus de 10,59 milliards de dollars l’année dernière uniquement pour la R&D et l’infrastructure informatique.
Néanmoins, alors qu’OpenAI prépare le terrain pour une offre publique très attendue en 2026, la puce d’inférence Jalapeño pourrait rassurer les investisseurs privés et les marchés publics sur le fait qu’OpenAI a un plan pour se sortir du gouffre financier et progresser vers la rentabilité. Si cela peut réduire les coûts de l’inférence de l’IA, alors peut-être pourra-t-il récupérer une partie des pertes dépensées en sessions de formation coûteuses.
«En concevant nous-mêmes une plus grande partie de la pile, nous pouvons fournir davantage d’intelligence avec une plus grande efficacité et continuer à pousser l’IA avancée vers un accès plus large», a déclaré Brockman inclus dans le communiqué de Broadcom.
Qu’est-ce que cela signifie pour Nvidia et tous les autres fournisseurs de puces d’OpenAI ?
L’introduction de Jalapeño soulève immédiatement des questions sur le positionnement stratégique d’OpenAI sur le marché extrêmement concurrentiel des semi-conducteurs et des GPU.
Depuis le lancement du boom de l’IA générative fin 2022, OpenAI est resté l’un des plus gros clients des produits haut de gamme du leader du marché des GPU Nvidia, mais a également retiré des milliards de dollars d’investissement à l’entreprise (ce qui a engendré des accusations de « transactions circulaires ») et a élargi sa collaboration avec d’autres fabricants de puces rivaux pour alimenter ses appétits.
-
Nvidia : En février 2026, Nvidia a finalisé un investissement direct de 30 milliards de dollars dans OpenAI dans le cadre d’un cycle de financement massif de 110 milliards de dollars. Cet accord a permis de conclure un accord pour le déploiement de 10 gigawatts de systèmes informatiques, dont 3 gigawatts de capacité d’inférence dédiée et 2 gigawatts de capacité de formation, en utilisant la plateforme Vera Rubin de nouvelle génération de Nvidia. Des sources proches des entreprises affirment que VentureBeat Nvidia restera au cœur d’OpenAI, notamment du côté de la formation et du développement des modèles.
-
Amazon Web Services (AWS) : Dans le cadre du même cycle de financement de février 2026, Amazon a investi 50 milliards de dollars dans OpenAI. Cet accord prévoyait un engagement pour OpenAI de consommer environ deux gigawatts de la capacité informatique exclusive Trainium d’AWS au cours des huit prochaines années.
-
Micro-appareils avancés (AMD) : OpenAI a signé des accords avec le principal rival matériel de Nvidia, AMD, pour l’utilisation par le premier des GPU AMD Instinct™ MI450 Series du second.
-
Cerveau: La société a également conclu un pacte avec Cerebras, un fabricant de puces d’IA qui a réalisé son introduction en bourse en mai 2026.
Des sources ayant connaissance de ces accords ont déclaré qu’à l’heure actuelle, ils restent en vigueur, inchangés.
La course mondiale aux armements en silicium : OpenAI rejoint les poids lourds de l’infrastructure de l’IA
Avant l’introduction de Jalapeño, OpenAI fonctionnait avec un net désavantage structurel par rapport aux empires technologiques mondiaux verticalement intégrés.
Les géants de la technologie comme Google et Amazon utilisent depuis des années leurs propres programmes de silicium personnalisés et matures – GUnités de traitement tensoriel (TPU) de Google et Trainium d’Amazon lignes – pour répondre à des charges de travail de calcul massives avec des marges considérablement inférieures.
Microsoftle principal fournisseur de cloud d’OpenAI et le plus grand bailleur de fonds, est entré de manière agressive sur le marché du silicium sur mesure en lançant l’accélérateur Azure Maia 100 fin 2023.
Microsoft a ensuite intensifié ses efforts en janvier 2026 en introduisant le Maia 200, une centrale d’inférence construite sur le processus de 3 nanomètres de TSMC qui alimente déjà activement les modèles GPT-5.2 d’OpenAI dans les centres de données Azure.
De la même manière, Meta a élargi de manière agressive son portefeuille de Meta Training and Inference Accelerator (MTIA) ces dernières années.lançant les séries MTIA 300, 400, 450 et 500 pour alimenter ses moteurs de recommandation et ses fonctionnalités d’intelligence artificielle générative sans compter uniquement sur Nvidia.
Jalapeño offre à OpenAI la possibilité d’égaler et de compenser l’avantage de l’hyperscaler. En intégrant son architecture logicielle directement dans un processeur propriétaire, OpenAI a la possibilité de reproduire, au moins en partie, le playbook utilisé par Google, Amazon, Microsoft et Meta – passant d’un client cloud captif à un fournisseur d’infrastructure d’IA plus indépendant.
Le moment est venu dans un contexte de course mondiale aux armements en silicium qui s’intensifie rapidement. Poussé en partie par les restrictions à l’exportation des États-Unis, Les poids lourds chinois de la technologie recherchent également davantage leur propre matériel de puce IA personnalisé :
-
En mai, d’Alibaba La division des semi-conducteurs, T-Head, a dévoilé le Zhenwu M890, un processeur exclusif spécialement conçu pour les agents d’IA autonomes qui nécessitent une bande passante mémoire massive et des fenêtres contextuelles de longue durée.
-
Huawei se préparerait à lancer sa nouvelle puce Ascend 950DT le mois prochain
-
ByteDancela société mère de TikTok, aurait entamé des négociations actives avec Qualcomm en juin 2026 pour concevoir des circuits intégrés personnalisés spécifiques à des applications pour ses centres de données afin d’échapper à la dépendance à des tiers.
En finalisant avec succès la conception de Jalapeño, OpenAI cherche à dépasser les limites traditionnelles d’un laboratoire logiciel et à se tenir aux côtés des titans internationaux du cloud et des infrastructures.
L’avenir du gigawatt
Ce réseau tentaculaire d’accords de fournisseurs met en évidence l’ampleur des ambitions infrastructurelles d’OpenAI. L’objectif ultime du partenariat OpenAI et Broadcom consiste à déployer des centres de données à l’échelle du gigawatt avec Microsoft et d’autres partenaires à partir de 2026, c’est-à-dire des centres de données dotés de capacités de calcul nécessitant une énergie comparable à celle des villes.
Pour Broadcom, le partenariat agit comme un énorme catalyseur de réputation. L’entreprise a été l’un des plus grands bénéficiaires du boom de l’IA générative, aidant les hyperscalers et les laboratoires pionniers à concevoir du silicium personnalisé.
Les actions Broadcom reflètent cet élan, démontrant une augmentation de 18 % d’une année sur l’autre au cours de la première partie de 2026 et une multiplication par près de 7 depuis la fin de 2022, selon CNBC.
En fin de compte, Jalapeño confirme qu’OpenAI estime qu’il est prêt à aller au-delà du logiciel et du code pour entrer dans le domaine du matériel personnalisé du monde réel.
En contrôlant la physique de son pipeline d’inférence, tout en exploitant simultanément le capital et le matériel de Nvidia, Amazon, AMD et Cerebras, OpenAI tente de réécrire rapidement la future économie unitaire de l’IA.


Suscríbete y recibe las historias más importantes del día.
Al suscribirte aceptas nuestros términos y condiciones y política de privacidad.