





























Permitir que los LLM adquieran nuevos conocimientos después de la capacitación sigue siendo un obstáculo importante para la IA empresarial: las soluciones actuales son demasiado caras, demasiado lentas o están limitadas por los límites de la ventana de contexto.
Memorándumun marco de investigadores de varias universidades, codifica nuevos conocimientos en un modelo de memoria más pequeño dedicado que opera por separado del LLM principal.
La arquitectura modular funciona con modelos de código abierto y cerrado y evita la complejidad de las canalizaciones RAG y el reentrenamiento completo del modelo.
Los experimentos muestran que MeMo maneja consultas complejas de manera confiable incluso cuando los canales de recuperación son ruidosos. Evita el olvido catastrófico asociado con el ajuste directo y proporciona una vía rentable para actualizaciones continuas de conocimientos.
El desafío de actualizar la memoria LLM
Los modelos de lenguaje grandes se congelan después del entrenamiento y su conocimiento interno permanece estático hasta que se someten a actualizaciones computacionalmente masivas posteriores.
Actualmente, los desarrolladores se basan en tres enfoques principales para integrar el conocimiento externo en un LLM, cada uno con distintos inconvenientes:
Métodos no paramétricoscomo la generación aumentada de recuperación (RAG) y aprendizaje en contextorecupere documentos relevantes de una base de datos externa e insértelos directamente en el mensaje del modelo. Si bien son populares, estos métodos están limitados por el tamaño de las ventanas de contexto.
Como Armando Solar-Lezama, coautor del artículo, le dijo a VentureBeat: «Las bases de datos vectoriales tienen la tarea fundamentalmente difícil de codificar la semántica completa de un fragmento de texto en un solo vector y luego hacer coincidir ese vector con una consulta, incluso cuando la relevancia del fragmento… sólo puede ser aparente en el contexto de otros fragmentos».
Los investigadores señalan que la similitud semántica de las incrustaciones a menudo no se corresponde con lo que realmente requiere la consulta del usuario. El procesamiento de miles de tokens recuperados también genera una importante sobrecarga computacional y latencia de inferencia. Lo más problemático es que los sistemas RAG son muy sensibles al ruido. Los pasajes irrelevantes o mal recuperados a menudo degradan la respuesta final del modelo.
Métodos paramétricosal igual que la capacitación previa continua o el ajuste fino supervisado, intentan internalizar nuevos conocimientos directamente en los pesos del LLM. La actualización de LLM modernos y masivos es prohibitivamente costosa y, por lo general, imposible para los modelos propietarios de código cerrado ocultos detrás de las API. El ajuste fino también es propenso a causar olvido catastrófico. Obligar al modelo a adaptarse a nuevos datos corporativos a menudo erosiona sus capacidades de razonamiento y barreras de seguridad previamente adquiridas.
Métodos de memoria latentecomo la compresión de contexto, ofrecen un término medio. Comprimen el conocimiento en «tokens blandos» compactos o representaciones que se agregan al contexto del modelo durante la inferencia. El error fatal aquí es el «acoplamiento de representaciones». La memoria comprimida está estrictamente ligada a la arquitectura del modelo que la produjo; no se puede transferir una memoria latente entrenada en un modelo de código abierto a uno de código cerrado.
Cómo funciona Memo
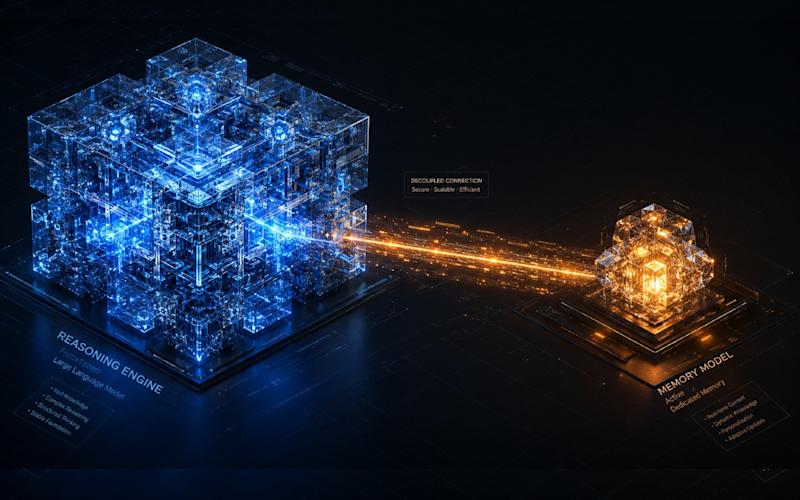
El marco MeMo (Memoria como modelo) presenta una arquitectura modular que presenta dos componentes separados. El modelo MEMORY es un modelo de lenguaje pequeño entrenado específicamente para codificar nuevos conocimientos en sus parámetros. El modelo EXECUTIVE es un LLM congelado y listo para usar que funciona como motor de razonamiento. Cuando un usuario hace una pregunta, el modelo EJECUTIVO trata el modelo MEMORIA como un oráculo externo, emitiendo subconsultas específicas para recopilar hechos y sintetizarlos en una respuesta final.
El principio central de diseño que impulsa a MeMo es el concepto de «reflejos». Las reflexiones son pares de preguntas y respuestas (QA) específicos diseñados para capturar todos los ángulos posibles de un corpus de conocimiento. En lugar de obligar a la IA a procesar un corpus de documentos masivo y no estructurado durante el entrenamiento, MeMo utiliza un modelo GENERADOR para destilar el texto sin formato en miles de pares de control de calidad específicos. Luego, el modelo MEMORY se afina en este conjunto de datos para responder preguntas utilizando solo su conocimiento paramétrico sin la necesidad de leer el contexto recuperado.

En el momento de la inferencia, la interacción entre los dos modelos sigue un protocolo estructurado de tres etapas:
1. El modelo EJECUTIVO descompone la consulta compleja de un usuario en un conjunto de subpreguntas atómicas. El modelo MEMORIA responde a cada uno de forma independiente para establecer los hechos básicos.
2. Utilizando esas pistas iniciales, el modelo EJECUTIVO emite consultas de seguimiento para limitar las entidades candidatas hasta que converja con confianza en un objetivo específico.
3. Finalmente, el modelo EJECUTIVO consulta el modelo MEMORIA en busca de datos de respaldo sobre esa entidad objetivo y sintetiza los fragmentos recuperados en una respuesta coherente.
Esta arquitectura fusiona las fortalezas de los tres paradigmas de memoria de IA existentes y evita sus dificultades. Aprovecha los modelos de frontera disponibles al mantener el almacenamiento de memoria separado del razonamiento, lo que garantiza la compatibilidad con modelos API cerrados y abiertos. Internaliza el conocimiento directamente en parámetros, pero aísla las actualizaciones en un modelo de MEMORIA dedicado más pequeño para proteger el motor de razonamiento. Finalmente, crea un artefacto de memoria consultable que no está vinculado a ningún modelo específico y se puede usar con diferentes familias de LLM.
Manejar actualizaciones continuas de conocimientos.
La gestión de la memoria de una IA requiere actualizaciones continuas a medida que cambian las políticas de la empresa y se publican nuevos informes. Normalmente, actualizar los parámetros de un modelo requiere volver a entrenarlo desde cero con los datos antiguos y nuevos combinados. A medida que crece la base de conocimientos, este costo acumulativo de reentrenamiento se vuelve inmanejable.
Para manejar las actualizaciones continuas de manera eficiente, MeMo se basa en una técnica llamada «fusión de modelos». En lugar de una fase masiva de reentrenamiento conjunto, MeMo entrena un modelo MEMORY nuevo e independiente exclusivamente en los documentos recién agregados. El sistema deriva un «vector de tareas» que representa los cambios de parámetros aprendidos a partir de los datos nuevos. Luego, estas actualizaciones se fusionan matemáticamente en los pesos del modelo de MEMORIA original.
Este enfoque reduce las horas de computación necesarias para mantener el sistema actualizado y al mismo tiempo evita la interferencia que provoca un olvido catastrófico.
Esta eficiencia viene con una compensación: la fusión de modelos genera una caída de precisión del 11% al 19% en comparación con un reentrenamiento completo, según el modelo de razonamiento utilizado.
Memo en acción
Para medir la eficacia en el mundo real, el equipo de investigación evaluó MeMo comparándolo con varios puntos de referencia de la industria que requieren un razonamiento complejo y de múltiples saltos en múltiples documentos.
Los investigadores utilizaron Qwen2.5-32B-Instruct como modelo GENERADOR para destilar texto sin formato en reflejos. Para el modelo de MEMORIA principal, implementaron Qwen2.5-14B-Instruct. También validaron el enfoque en modelos de parámetros más pequeños de 1 a 2 B en diferentes arquitecturas, incluida Gemma3-1B.
Para el modelo de razonamiento EJECUTIVO, probaron tanto el Qwen2.5-32B de peso abierto como el Gemini 3 Flash propiedad de Google.
Compararon MeMo con un límite superior de «Recuperación perfecta» (donde los documentos correctos exactos se proporcionan manualmente) y varios sistemas de recuperación avanzados, incluida la búsqueda tradicional BM25, la recuperación de vectores densos y el RAG basado en gráficos de última generación (HippoRAG2). También probaron «Cartuchos», un método reciente que carga una caché KV entrenado sobre el modelo durante la inferencia.

MeMo dominó el razonamiento de documentos largos. Según los investigadores, en el punto de referencia NarrativeQA, MeMo logró una precisión del 53,58% junto con Gemini 3 Flash. HippoRAG2 alcanzó un máximo del 23,21%.
Los sistemas empresariales con frecuencia necesitan sintetizar respuestas complejas, como atravesar marcos regulatorios superpuestos escritos de forma independiente por diferentes organismos, o consolidar conocimientos a través de una base de código masiva y documentación externa. Los sistemas RAG tradicionales fallan aquí porque alcanzan los límites de la ventana de contexto y no logran conectar conceptos que abarcan cientos de páginas. MeMo tiene éxito porque esas conexiones se asignan e internalizan dentro del modelo MEMORY durante el entrenamiento. Es «como tener un Malcolm Gladwell propio que pueda conectar la historia de los Beatles con la historia de Bill Gates para argumentar sobre la naturaleza de la experiencia», dijo Solar-Lezama.
Los experimentos revelaron otra ventaja importante: actualizar el motor de razonamiento no requiere ningún reentrenamiento. Simplemente cambiar el modelo EXECUTIVE del Qwen de código abierto al Gemini 3 Flash patentado aumentó el rendimiento de MeMo en un 26,73% en NarrativeQA y un 11,90% en el punto de referencia MuSiQue. Para los profesionales, esto significa que pueden entrenar un modelo de MEMORIA de forma segura con sus datos privados y conectarlo instantáneamente a las API comerciales más recientes, actualizando continuamente la inteligencia del sistema sin incurrir en nuevos costos de capacitación.
El equipo de investigación describió la integración como que no requiere configuración adicional: «El LLM base (o ejecutivo) que los equipos ya están usando en RAG se puede configurar para consultar el modelo de memoria directamente. Estas consultas se realizan en lenguaje natural, similar a enviar una solicitud de mensaje a una API, sin necesidad de configuración adicional».
MeMo también maneja excepcionalmente bien los datos ruidosos. Cuando los investigadores inundaron deliberadamente el conjunto de datos con documentos irrelevantes (hasta el doble de información útil), el rendimiento de HippoRAG2 cayó un 11,55%. El rendimiento de MeMo se mantuvo relativamente estable, cayendo menos del 2%. Las bases de conocimiento empresarial suelen ser confusas, llenas de documentos duplicados y políticas obsoletas. Los sistemas RAG estándar luchan con este ruido, incorporando párrafos incorrectos al mensaje y provocando alucinaciones. Debido a que el modelo EXECUTIVE de MeMo interactúa con un oráculo sintetizado en lugar de con fragmentos de documentos sin procesar, sigue siendo muy robusto contra datos corporativos desorganizados.
Limitaciones y compensaciones
Para los equipos de ingeniería que buscan implementar MeMo, existen varias limitaciones clave a considerar.
A diferencia de los sistemas RAG tradicionales que indexan rápidamente documentos sin procesar en una base de datos vectorial, MeMo requiere un costo de capacitación inicial para cada nuevo corpus. El proceso de generación de datos utilizado para sintetizar las reflexiones de entrenamiento es computacionalmente costoso. Por ejemplo, el equipo observó que «generar el conjunto de datos de control de calidad de reflexión completo tomó aproximadamente 240 horas de GPU en NVIDIA H200», mientras que entrenar un modelo de MEMORIA de parámetros 14B «tomó aproximadamente 180 horas de GPU H200». Como dijo Solar-Lezama, «Reducir el coste de la formación es uno de los problemas de investigación abiertos más importantes para hacer de esta técnica un caballo de batalla».
Debido a que el modelo MEMORIA es una red neuronal de tamaño fijo, su capacidad para internalizar conocimiento está limitada por su capacidad de representación. Si bien los investigadores no alcanzaron un límite estricto durante su evaluación comparativa, plantean la hipótesis de que «los corpus suficientemente grandes o densos en información excederán lo que un modelo de MEMORIA de tamaño fijo puede comprimir y representar correctamente».
Finalmente, debido a que MeMo sintetiza respuestas a partir de la memoria paramétrica en lugar de recuperar fragmentos de texto exactos, oscurece la procedencia de la información. Esto dificulta atribuir afirmaciones específicas a documentos originales, lo que plantea un problema de cumplimiento crítico para las aplicaciones empresariales que requieren seguimientos de auditoría estrictos.
Decidir entre MeMo y RAG tradicional se reduce a una heurística de «búsqueda versus síntesis», junto con la volatilidad de los datos. Los investigadores advierten que «se preferiría el RAG tradicional cuando las respuestas se encuentran en un solo documento o cuando hay una fuente bien definida… Se preferiría MeMo cuando la tarea pasa de la búsqueda a la síntesis de una respuesta a partir de información dispersa en múltiples fragmentos». Si su corpus de conocimientos cambia rápidamente (por ejemplo, feeds diarios) y necesita citas de fuentes exactas, RAG sigue siendo la mejor opción debido al costo inicial de capacitación de MeMo. Si su corpus consiste en conocimiento de dominio generalizado que evoluciona lentamente en relación con su volumen, MeMo ofrece un razonamiento muy superior. Los equipos también pueden adoptar una arquitectura de enrutamiento híbrida en producción: enviar consultas de «búsqueda» a una base de datos vectorial estándar y consultas de «síntesis» al modelo MEMORIA.
«Mirando más allá, esperaría que los modelos de memoria se convirtieran en un componente arquitectónico estándar junto con la recuperación», dijo a VentureBeat Daniela Rus, coautora del artículo y directora del Laboratorio de Ciencias de la Computación e Inteligencia Artificial (CSAIL) del MIT, «de la misma manera que el almacenamiento en caché y la indexación son componentes estándar de cualquier sistema de datos serio en la actualidad».

Permitir que los LLM adquieran nuevos conocimientos después de la capacitación sigue siendo un obstáculo importante para la IA empresarial: las soluciones actuales son demasiado caras, demasiado lentas o están limitadas por los límites de la ventana de contexto.
Memorándumun marco de investigadores de varias universidades, codifica nuevos conocimientos en un modelo de memoria más pequeño dedicado que opera por separado del LLM principal.
La arquitectura modular funciona con modelos de código abierto y cerrado y evita la complejidad de las canalizaciones RAG y el reentrenamiento completo del modelo.
Los experimentos muestran que MeMo maneja consultas complejas de manera confiable incluso cuando los canales de recuperación son ruidosos. Evita el olvido catastrófico asociado con el ajuste directo y proporciona una vía rentable para actualizaciones continuas de conocimientos.
El desafío de actualizar la memoria LLM
Los modelos de lenguaje grandes se congelan después del entrenamiento y su conocimiento interno permanece estático hasta que se someten a actualizaciones computacionalmente masivas posteriores.
Actualmente, los desarrolladores se basan en tres enfoques principales para integrar el conocimiento externo en un LLM, cada uno con distintos inconvenientes:
Métodos no paramétricoscomo la generación aumentada de recuperación (RAG) y aprendizaje en contextorecupere documentos relevantes de una base de datos externa e insértelos directamente en el mensaje del modelo. Si bien son populares, estos métodos están limitados por el tamaño de las ventanas de contexto.
Como Armando Solar-Lezama, coautor del artículo, le dijo a VentureBeat: «Las bases de datos vectoriales tienen la tarea fundamentalmente difícil de codificar la semántica completa de un fragmento de texto en un solo vector y luego hacer coincidir ese vector con una consulta, incluso cuando la relevancia del fragmento… sólo puede ser aparente en el contexto de otros fragmentos».
Los investigadores señalan que la similitud semántica de las incrustaciones a menudo no se corresponde con lo que realmente requiere la consulta del usuario. El procesamiento de miles de tokens recuperados también genera una importante sobrecarga computacional y latencia de inferencia. Lo más problemático es que los sistemas RAG son muy sensibles al ruido. Los pasajes irrelevantes o mal recuperados a menudo degradan la respuesta final del modelo.
Métodos paramétricosal igual que la capacitación previa continua o el ajuste fino supervisado, intentan internalizar nuevos conocimientos directamente en los pesos del LLM. La actualización de LLM modernos y masivos es prohibitivamente costosa y, por lo general, imposible para los modelos propietarios de código cerrado ocultos detrás de las API. El ajuste fino también es propenso a causar olvido catastrófico. Obligar al modelo a adaptarse a nuevos datos corporativos a menudo erosiona sus capacidades de razonamiento y barreras de seguridad previamente adquiridas.
Métodos de memoria latentecomo la compresión de contexto, ofrecen un término medio. Comprimen el conocimiento en «tokens blandos» compactos o representaciones que se agregan al contexto del modelo durante la inferencia. El error fatal aquí es el «acoplamiento de representaciones». La memoria comprimida está estrictamente ligada a la arquitectura del modelo que la produjo; no se puede transferir una memoria latente entrenada en un modelo de código abierto a uno de código cerrado.
Cómo funciona Memo
El marco MeMo (Memoria como modelo) presenta una arquitectura modular que presenta dos componentes separados. El modelo MEMORY es un modelo de lenguaje pequeño entrenado específicamente para codificar nuevos conocimientos en sus parámetros. El modelo EXECUTIVE es un LLM congelado y listo para usar que funciona como motor de razonamiento. Cuando un usuario hace una pregunta, el modelo EJECUTIVO trata el modelo MEMORIA como un oráculo externo, emitiendo subconsultas específicas para recopilar hechos y sintetizarlos en una respuesta final.
El principio central de diseño que impulsa a MeMo es el concepto de «reflejos». Las reflexiones son pares de preguntas y respuestas (QA) específicos diseñados para capturar todos los ángulos posibles de un corpus de conocimiento. En lugar de obligar a la IA a procesar un corpus de documentos masivo y no estructurado durante el entrenamiento, MeMo utiliza un modelo GENERADOR para destilar el texto sin formato en miles de pares de control de calidad específicos. Luego, el modelo MEMORY se afina en este conjunto de datos para responder preguntas utilizando solo su conocimiento paramétrico sin la necesidad de leer el contexto recuperado.
En el momento de la inferencia, la interacción entre los dos modelos sigue un protocolo estructurado de tres etapas:
1. El modelo EJECUTIVO descompone la consulta compleja de un usuario en un conjunto de subpreguntas atómicas. El modelo MEMORIA responde a cada uno de forma independiente para establecer los hechos básicos.
2. Utilizando esas pistas iniciales, el modelo EJECUTIVO emite consultas de seguimiento para limitar las entidades candidatas hasta que converja con confianza en un objetivo específico.
3. Finalmente, el modelo EJECUTIVO consulta el modelo MEMORIA en busca de datos de respaldo sobre esa entidad objetivo y sintetiza los fragmentos recuperados en una respuesta coherente.
Esta arquitectura fusiona las fortalezas de los tres paradigmas de memoria de IA existentes y evita sus dificultades. Aprovecha los modelos de frontera disponibles al mantener el almacenamiento de memoria separado del razonamiento, lo que garantiza la compatibilidad con modelos API cerrados y abiertos. Internaliza el conocimiento directamente en parámetros, pero aísla las actualizaciones en un modelo de MEMORIA dedicado más pequeño para proteger el motor de razonamiento. Finalmente, crea un artefacto de memoria consultable que no está vinculado a ningún modelo específico y se puede usar con diferentes familias de LLM.
Manejar actualizaciones continuas de conocimientos.
La gestión de la memoria de una IA requiere actualizaciones continuas a medida que cambian las políticas de la empresa y se publican nuevos informes. Normalmente, actualizar los parámetros de un modelo requiere volver a entrenarlo desde cero con los datos antiguos y nuevos combinados. A medida que crece la base de conocimientos, este costo acumulativo de reentrenamiento se vuelve inmanejable.
Para manejar las actualizaciones continuas de manera eficiente, MeMo se basa en una técnica llamada «fusión de modelos». En lugar de una fase masiva de reentrenamiento conjunto, MeMo entrena un modelo MEMORY nuevo e independiente exclusivamente en los documentos recién agregados. El sistema deriva un «vector de tareas» que representa los cambios de parámetros aprendidos a partir de los datos nuevos. Luego, estas actualizaciones se fusionan matemáticamente en los pesos del modelo de MEMORIA original.
Este enfoque reduce las horas de computación necesarias para mantener el sistema actualizado y al mismo tiempo evita la interferencia que provoca un olvido catastrófico.
Esta eficiencia viene con una compensación: la fusión de modelos genera una caída de precisión del 11% al 19% en comparación con un reentrenamiento completo, según el modelo de razonamiento utilizado.
Memo en acción
Para medir la eficacia en el mundo real, el equipo de investigación evaluó MeMo comparándolo con varios puntos de referencia de la industria que requieren un razonamiento complejo y de múltiples saltos en múltiples documentos.
Los investigadores utilizaron Qwen2.5-32B-Instruct como modelo GENERADOR para destilar texto sin formato en reflejos. Para el modelo de MEMORIA principal, implementaron Qwen2.5-14B-Instruct. También validaron el enfoque en modelos de parámetros más pequeños de 1 a 2 B en diferentes arquitecturas, incluida Gemma3-1B.
Para el modelo de razonamiento EJECUTIVO, probaron tanto el Qwen2.5-32B de peso abierto como el Gemini 3 Flash propiedad de Google.
Compararon MeMo con un límite superior de «Recuperación perfecta» (donde los documentos correctos exactos se proporcionan manualmente) y varios sistemas de recuperación avanzados, incluida la búsqueda tradicional BM25, la recuperación de vectores densos y el RAG basado en gráficos de última generación (HippoRAG2). También probaron «Cartuchos», un método reciente que carga una caché KV entrenado sobre el modelo durante la inferencia.
MeMo dominó el razonamiento de documentos largos. Según los investigadores, en el punto de referencia NarrativeQA, MeMo logró una precisión del 53,58% junto con Gemini 3 Flash. HippoRAG2 alcanzó un máximo del 23,21%.
Los sistemas empresariales con frecuencia necesitan sintetizar respuestas complejas, como atravesar marcos regulatorios superpuestos escritos de forma independiente por diferentes organismos, o consolidar conocimientos a través de una base de código masiva y documentación externa. Los sistemas RAG tradicionales fallan aquí porque alcanzan los límites de la ventana de contexto y no logran conectar conceptos que abarcan cientos de páginas. MeMo tiene éxito porque esas conexiones se asignan e internalizan dentro del modelo MEMORY durante el entrenamiento. Es «como tener un Malcolm Gladwell propio que pueda conectar la historia de los Beatles con la historia de Bill Gates para argumentar sobre la naturaleza de la experiencia», dijo Solar-Lezama.
Los experimentos revelaron otra ventaja importante: actualizar el motor de razonamiento no requiere ningún reentrenamiento. Simplemente cambiar el modelo EXECUTIVE del Qwen de código abierto al Gemini 3 Flash patentado aumentó el rendimiento de MeMo en un 26,73% en NarrativeQA y un 11,90% en el punto de referencia MuSiQue. Para los profesionales, esto significa que pueden entrenar un modelo de MEMORIA de forma segura con sus datos privados y conectarlo instantáneamente a las API comerciales más recientes, actualizando continuamente la inteligencia del sistema sin incurrir en nuevos costos de capacitación.
El equipo de investigación describió la integración como que no requiere configuración adicional: «El LLM base (o ejecutivo) que los equipos ya están usando en RAG se puede configurar para consultar el modelo de memoria directamente. Estas consultas se realizan en lenguaje natural, similar a enviar una solicitud de mensaje a una API, sin necesidad de configuración adicional».
MeMo también maneja excepcionalmente bien los datos ruidosos. Cuando los investigadores inundaron deliberadamente el conjunto de datos con documentos irrelevantes (hasta el doble de información útil), el rendimiento de HippoRAG2 cayó un 11,55%. El rendimiento de MeMo se mantuvo relativamente estable, cayendo menos del 2%. Las bases de conocimiento empresarial suelen ser confusas, llenas de documentos duplicados y políticas obsoletas. Los sistemas RAG estándar luchan con este ruido, incorporando párrafos incorrectos al mensaje y provocando alucinaciones. Debido a que el modelo EXECUTIVE de MeMo interactúa con un oráculo sintetizado en lugar de con fragmentos de documentos sin procesar, sigue siendo muy robusto contra datos corporativos desorganizados.
Limitaciones y compensaciones
Para los equipos de ingeniería que buscan implementar MeMo, existen varias limitaciones clave a considerar.
A diferencia de los sistemas RAG tradicionales que indexan rápidamente documentos sin procesar en una base de datos vectorial, MeMo requiere un costo de capacitación inicial para cada nuevo corpus. El proceso de generación de datos utilizado para sintetizar las reflexiones de entrenamiento es computacionalmente costoso. Por ejemplo, el equipo observó que «generar el conjunto de datos de control de calidad de reflexión completo tomó aproximadamente 240 horas de GPU en NVIDIA H200», mientras que entrenar un modelo de MEMORIA de parámetros 14B «tomó aproximadamente 180 horas de GPU H200». Como dijo Solar-Lezama, «Reducir el coste de la formación es uno de los problemas de investigación abiertos más importantes para hacer de esta técnica un caballo de batalla».
Debido a que el modelo MEMORIA es una red neuronal de tamaño fijo, su capacidad para internalizar conocimiento está limitada por su capacidad de representación. Si bien los investigadores no alcanzaron un límite estricto durante su evaluación comparativa, plantean la hipótesis de que «los corpus suficientemente grandes o densos en información excederán lo que un modelo de MEMORIA de tamaño fijo puede comprimir y representar correctamente».
Finalmente, debido a que MeMo sintetiza respuestas a partir de la memoria paramétrica en lugar de recuperar fragmentos de texto exactos, oscurece la procedencia de la información. Esto dificulta atribuir afirmaciones específicas a documentos originales, lo que plantea un problema de cumplimiento crítico para las aplicaciones empresariales que requieren seguimientos de auditoría estrictos.
Decidir entre MeMo y RAG tradicional se reduce a una heurística de «búsqueda versus síntesis», junto con la volatilidad de los datos. Los investigadores advierten que «se preferiría el RAG tradicional cuando las respuestas se encuentran en un solo documento o cuando hay una fuente bien definida… Se preferiría MeMo cuando la tarea pasa de la búsqueda a la síntesis de una respuesta a partir de información dispersa en múltiples fragmentos». Si su corpus de conocimientos cambia rápidamente (por ejemplo, feeds diarios) y necesita citas de fuentes exactas, RAG sigue siendo la mejor opción debido al costo inicial de capacitación de MeMo. Si su corpus consiste en conocimiento de dominio generalizado que evoluciona lentamente en relación con su volumen, MeMo ofrece un razonamiento muy superior. Los equipos también pueden adoptar una arquitectura de enrutamiento híbrida en producción: enviar consultas de «búsqueda» a una base de datos vectorial estándar y consultas de «síntesis» al modelo MEMORIA.
«Mirando más allá, esperaría que los modelos de memoria se convirtieran en un componente arquitectónico estándar junto con la recuperación», dijo a VentureBeat Daniela Rus, coautora del artículo y directora del Laboratorio de Ciencias de la Computación e Inteligencia Artificial (CSAIL) del MIT, «de la misma manera que el almacenamiento en caché y la indexación son componentes estándar de cualquier sistema de datos serio en la actualidad».

Permitir que los LLM adquieran nuevos conocimientos después de la capacitación sigue siendo un obstáculo importante para la IA empresarial: las soluciones actuales son demasiado caras, demasiado lentas o están limitadas por los límites de la ventana de contexto.
Memorándumun marco de investigadores de varias universidades, codifica nuevos conocimientos en un modelo de memoria más pequeño dedicado que opera por separado del LLM principal.
La arquitectura modular funciona con modelos de código abierto y cerrado y evita la complejidad de las canalizaciones RAG y el reentrenamiento completo del modelo.
Los experimentos muestran que MeMo maneja consultas complejas de manera confiable incluso cuando los canales de recuperación son ruidosos. Evita el olvido catastrófico asociado con el ajuste directo y proporciona una vía rentable para actualizaciones continuas de conocimientos.
El desafío de actualizar la memoria LLM
Los modelos de lenguaje grandes se congelan después del entrenamiento y su conocimiento interno permanece estático hasta que se someten a actualizaciones computacionalmente masivas posteriores.
Actualmente, los desarrolladores se basan en tres enfoques principales para integrar el conocimiento externo en un LLM, cada uno con distintos inconvenientes:
Métodos no paramétricoscomo la generación aumentada de recuperación (RAG) y aprendizaje en contextorecupere documentos relevantes de una base de datos externa e insértelos directamente en el mensaje del modelo. Si bien son populares, estos métodos están limitados por el tamaño de las ventanas de contexto.
Como Armando Solar-Lezama, coautor del artículo, le dijo a VentureBeat: «Las bases de datos vectoriales tienen la tarea fundamentalmente difícil de codificar la semántica completa de un fragmento de texto en un solo vector y luego hacer coincidir ese vector con una consulta, incluso cuando la relevancia del fragmento… sólo puede ser aparente en el contexto de otros fragmentos».
Los investigadores señalan que la similitud semántica de las incrustaciones a menudo no se corresponde con lo que realmente requiere la consulta del usuario. El procesamiento de miles de tokens recuperados también genera una importante sobrecarga computacional y latencia de inferencia. Lo más problemático es que los sistemas RAG son muy sensibles al ruido. Los pasajes irrelevantes o mal recuperados a menudo degradan la respuesta final del modelo.
Métodos paramétricosal igual que la capacitación previa continua o el ajuste fino supervisado, intentan internalizar nuevos conocimientos directamente en los pesos del LLM. La actualización de LLM modernos y masivos es prohibitivamente costosa y, por lo general, imposible para los modelos propietarios de código cerrado ocultos detrás de las API. El ajuste fino también es propenso a causar olvido catastrófico. Obligar al modelo a adaptarse a nuevos datos corporativos a menudo erosiona sus capacidades de razonamiento y barreras de seguridad previamente adquiridas.
Métodos de memoria latentecomo la compresión de contexto, ofrecen un término medio. Comprimen el conocimiento en «tokens blandos» compactos o representaciones que se agregan al contexto del modelo durante la inferencia. El error fatal aquí es el «acoplamiento de representaciones». La memoria comprimida está estrictamente ligada a la arquitectura del modelo que la produjo; no se puede transferir una memoria latente entrenada en un modelo de código abierto a uno de código cerrado.
Cómo funciona Memo
El marco MeMo (Memoria como modelo) presenta una arquitectura modular que presenta dos componentes separados. El modelo MEMORY es un modelo de lenguaje pequeño entrenado específicamente para codificar nuevos conocimientos en sus parámetros. El modelo EXECUTIVE es un LLM congelado y listo para usar que funciona como motor de razonamiento. Cuando un usuario hace una pregunta, el modelo EJECUTIVO trata el modelo MEMORIA como un oráculo externo, emitiendo subconsultas específicas para recopilar hechos y sintetizarlos en una respuesta final.
El principio central de diseño que impulsa a MeMo es el concepto de «reflejos». Las reflexiones son pares de preguntas y respuestas (QA) específicos diseñados para capturar todos los ángulos posibles de un corpus de conocimiento. En lugar de obligar a la IA a procesar un corpus de documentos masivo y no estructurado durante el entrenamiento, MeMo utiliza un modelo GENERADOR para destilar el texto sin formato en miles de pares de control de calidad específicos. Luego, el modelo MEMORY se afina en este conjunto de datos para responder preguntas utilizando solo su conocimiento paramétrico sin la necesidad de leer el contexto recuperado.
En el momento de la inferencia, la interacción entre los dos modelos sigue un protocolo estructurado de tres etapas:
1. El modelo EJECUTIVO descompone la consulta compleja de un usuario en un conjunto de subpreguntas atómicas. El modelo MEMORIA responde a cada uno de forma independiente para establecer los hechos básicos.
2. Utilizando esas pistas iniciales, el modelo EJECUTIVO emite consultas de seguimiento para limitar las entidades candidatas hasta que converja con confianza en un objetivo específico.
3. Finalmente, el modelo EJECUTIVO consulta el modelo MEMORIA en busca de datos de respaldo sobre esa entidad objetivo y sintetiza los fragmentos recuperados en una respuesta coherente.
Esta arquitectura fusiona las fortalezas de los tres paradigmas de memoria de IA existentes y evita sus dificultades. Aprovecha los modelos de frontera disponibles al mantener el almacenamiento de memoria separado del razonamiento, lo que garantiza la compatibilidad con modelos API cerrados y abiertos. Internaliza el conocimiento directamente en parámetros, pero aísla las actualizaciones en un modelo de MEMORIA dedicado más pequeño para proteger el motor de razonamiento. Finalmente, crea un artefacto de memoria consultable que no está vinculado a ningún modelo específico y se puede usar con diferentes familias de LLM.
Manejar actualizaciones continuas de conocimientos.
La gestión de la memoria de una IA requiere actualizaciones continuas a medida que cambian las políticas de la empresa y se publican nuevos informes. Normalmente, actualizar los parámetros de un modelo requiere volver a entrenarlo desde cero con los datos antiguos y nuevos combinados. A medida que crece la base de conocimientos, este costo acumulativo de reentrenamiento se vuelve inmanejable.
Para manejar las actualizaciones continuas de manera eficiente, MeMo se basa en una técnica llamada «fusión de modelos». En lugar de una fase masiva de reentrenamiento conjunto, MeMo entrena un modelo MEMORY nuevo e independiente exclusivamente en los documentos recién agregados. El sistema deriva un «vector de tareas» que representa los cambios de parámetros aprendidos a partir de los datos nuevos. Luego, estas actualizaciones se fusionan matemáticamente en los pesos del modelo de MEMORIA original.
Este enfoque reduce las horas de computación necesarias para mantener el sistema actualizado y al mismo tiempo evita la interferencia que provoca un olvido catastrófico.
Esta eficiencia viene con una compensación: la fusión de modelos genera una caída de precisión del 11% al 19% en comparación con un reentrenamiento completo, según el modelo de razonamiento utilizado.
Memo en acción
Para medir la eficacia en el mundo real, el equipo de investigación evaluó MeMo comparándolo con varios puntos de referencia de la industria que requieren un razonamiento complejo y de múltiples saltos en múltiples documentos.
Los investigadores utilizaron Qwen2.5-32B-Instruct como modelo GENERADOR para destilar texto sin formato en reflejos. Para el modelo de MEMORIA principal, implementaron Qwen2.5-14B-Instruct. También validaron el enfoque en modelos de parámetros más pequeños de 1 a 2 B en diferentes arquitecturas, incluida Gemma3-1B.
Para el modelo de razonamiento EJECUTIVO, probaron tanto el Qwen2.5-32B de peso abierto como el Gemini 3 Flash propiedad de Google.
Compararon MeMo con un límite superior de «Recuperación perfecta» (donde los documentos correctos exactos se proporcionan manualmente) y varios sistemas de recuperación avanzados, incluida la búsqueda tradicional BM25, la recuperación de vectores densos y el RAG basado en gráficos de última generación (HippoRAG2). También probaron «Cartuchos», un método reciente que carga una caché KV entrenado sobre el modelo durante la inferencia.
MeMo dominó el razonamiento de documentos largos. Según los investigadores, en el punto de referencia NarrativeQA, MeMo logró una precisión del 53,58% junto con Gemini 3 Flash. HippoRAG2 alcanzó un máximo del 23,21%.
Los sistemas empresariales con frecuencia necesitan sintetizar respuestas complejas, como atravesar marcos regulatorios superpuestos escritos de forma independiente por diferentes organismos, o consolidar conocimientos a través de una base de código masiva y documentación externa. Los sistemas RAG tradicionales fallan aquí porque alcanzan los límites de la ventana de contexto y no logran conectar conceptos que abarcan cientos de páginas. MeMo tiene éxito porque esas conexiones se asignan e internalizan dentro del modelo MEMORY durante el entrenamiento. Es «como tener un Malcolm Gladwell propio que pueda conectar la historia de los Beatles con la historia de Bill Gates para argumentar sobre la naturaleza de la experiencia», dijo Solar-Lezama.
Los experimentos revelaron otra ventaja importante: actualizar el motor de razonamiento no requiere ningún reentrenamiento. Simplemente cambiar el modelo EXECUTIVE del Qwen de código abierto al Gemini 3 Flash patentado aumentó el rendimiento de MeMo en un 26,73% en NarrativeQA y un 11,90% en el punto de referencia MuSiQue. Para los profesionales, esto significa que pueden entrenar un modelo de MEMORIA de forma segura con sus datos privados y conectarlo instantáneamente a las API comerciales más recientes, actualizando continuamente la inteligencia del sistema sin incurrir en nuevos costos de capacitación.
El equipo de investigación describió la integración como que no requiere configuración adicional: «El LLM base (o ejecutivo) que los equipos ya están usando en RAG se puede configurar para consultar el modelo de memoria directamente. Estas consultas se realizan en lenguaje natural, similar a enviar una solicitud de mensaje a una API, sin necesidad de configuración adicional».
MeMo también maneja excepcionalmente bien los datos ruidosos. Cuando los investigadores inundaron deliberadamente el conjunto de datos con documentos irrelevantes (hasta el doble de información útil), el rendimiento de HippoRAG2 cayó un 11,55%. El rendimiento de MeMo se mantuvo relativamente estable, cayendo menos del 2%. Las bases de conocimiento empresarial suelen ser confusas, llenas de documentos duplicados y políticas obsoletas. Los sistemas RAG estándar luchan con este ruido, incorporando párrafos incorrectos al mensaje y provocando alucinaciones. Debido a que el modelo EXECUTIVE de MeMo interactúa con un oráculo sintetizado en lugar de con fragmentos de documentos sin procesar, sigue siendo muy robusto contra datos corporativos desorganizados.
Limitaciones y compensaciones
Para los equipos de ingeniería que buscan implementar MeMo, existen varias limitaciones clave a considerar.
A diferencia de los sistemas RAG tradicionales que indexan rápidamente documentos sin procesar en una base de datos vectorial, MeMo requiere un costo de capacitación inicial para cada nuevo corpus. El proceso de generación de datos utilizado para sintetizar las reflexiones de entrenamiento es computacionalmente costoso. Por ejemplo, el equipo observó que «generar el conjunto de datos de control de calidad de reflexión completo tomó aproximadamente 240 horas de GPU en NVIDIA H200», mientras que entrenar un modelo de MEMORIA de parámetros 14B «tomó aproximadamente 180 horas de GPU H200». Como dijo Solar-Lezama, «Reducir el coste de la formación es uno de los problemas de investigación abiertos más importantes para hacer de esta técnica un caballo de batalla».
Debido a que el modelo MEMORIA es una red neuronal de tamaño fijo, su capacidad para internalizar conocimiento está limitada por su capacidad de representación. Si bien los investigadores no alcanzaron un límite estricto durante su evaluación comparativa, plantean la hipótesis de que «los corpus suficientemente grandes o densos en información excederán lo que un modelo de MEMORIA de tamaño fijo puede comprimir y representar correctamente».
Finalmente, debido a que MeMo sintetiza respuestas a partir de la memoria paramétrica en lugar de recuperar fragmentos de texto exactos, oscurece la procedencia de la información. Esto dificulta atribuir afirmaciones específicas a documentos originales, lo que plantea un problema de cumplimiento crítico para las aplicaciones empresariales que requieren seguimientos de auditoría estrictos.
Decidir entre MeMo y RAG tradicional se reduce a una heurística de «búsqueda versus síntesis», junto con la volatilidad de los datos. Los investigadores advierten que «se preferiría el RAG tradicional cuando las respuestas se encuentran en un solo documento o cuando hay una fuente bien definida… Se preferiría MeMo cuando la tarea pasa de la búsqueda a la síntesis de una respuesta a partir de información dispersa en múltiples fragmentos». Si su corpus de conocimientos cambia rápidamente (por ejemplo, feeds diarios) y necesita citas de fuentes exactas, RAG sigue siendo la mejor opción debido al costo inicial de capacitación de MeMo. Si su corpus consiste en conocimiento de dominio generalizado que evoluciona lentamente en relación con su volumen, MeMo ofrece un razonamiento muy superior. Los equipos también pueden adoptar una arquitectura de enrutamiento híbrida en producción: enviar consultas de «búsqueda» a una base de datos vectorial estándar y consultas de «síntesis» al modelo MEMORIA.
«Mirando más allá, esperaría que los modelos de memoria se convirtieran en un componente arquitectónico estándar junto con la recuperación», dijo a VentureBeat Daniela Rus, coautora del artículo y directora del Laboratorio de Ciencias de la Computación e Inteligencia Artificial (CSAIL) del MIT, «de la misma manera que el almacenamiento en caché y la indexación son componentes estándar de cualquier sistema de datos serio en la actualidad».
Permitir que los LLM adquieran nuevos conocimientos después de la capacitación sigue siendo un obstáculo importante para la IA empresarial: las soluciones actuales son demasiado caras, demasiado lentas o están limitadas por los límites de la ventana de contexto.
Memorándumun marco de investigadores de varias universidades, codifica nuevos conocimientos en un modelo de memoria más pequeño dedicado que opera por separado del LLM principal.
La arquitectura modular funciona con modelos de código abierto y cerrado y evita la complejidad de las canalizaciones RAG y el reentrenamiento completo del modelo.
Los experimentos muestran que MeMo maneja consultas complejas de manera confiable incluso cuando los canales de recuperación son ruidosos. Evita el olvido catastrófico asociado con el ajuste directo y proporciona una vía rentable para actualizaciones continuas de conocimientos.
El desafío de actualizar la memoria LLM
Los modelos de lenguaje grandes se congelan después del entrenamiento y su conocimiento interno permanece estático hasta que se someten a actualizaciones computacionalmente masivas posteriores.
Actualmente, los desarrolladores se basan en tres enfoques principales para integrar el conocimiento externo en un LLM, cada uno con distintos inconvenientes:
Métodos no paramétricoscomo la generación aumentada de recuperación (RAG) y aprendizaje en contextorecupere documentos relevantes de una base de datos externa e insértelos directamente en el mensaje del modelo. Si bien son populares, estos métodos están limitados por el tamaño de las ventanas de contexto.
Como Armando Solar-Lezama, coautor del artículo, le dijo a VentureBeat: «Las bases de datos vectoriales tienen la tarea fundamentalmente difícil de codificar la semántica completa de un fragmento de texto en un solo vector y luego hacer coincidir ese vector con una consulta, incluso cuando la relevancia del fragmento… sólo puede ser aparente en el contexto de otros fragmentos».
Los investigadores señalan que la similitud semántica de las incrustaciones a menudo no se corresponde con lo que realmente requiere la consulta del usuario. El procesamiento de miles de tokens recuperados también genera una importante sobrecarga computacional y latencia de inferencia. Lo más problemático es que los sistemas RAG son muy sensibles al ruido. Los pasajes irrelevantes o mal recuperados a menudo degradan la respuesta final del modelo.
Métodos paramétricosal igual que la capacitación previa continua o el ajuste fino supervisado, intentan internalizar nuevos conocimientos directamente en los pesos del LLM. La actualización de LLM modernos y masivos es prohibitivamente costosa y, por lo general, imposible para los modelos propietarios de código cerrado ocultos detrás de las API. El ajuste fino también es propenso a causar olvido catastrófico. Obligar al modelo a adaptarse a nuevos datos corporativos a menudo erosiona sus capacidades de razonamiento y barreras de seguridad previamente adquiridas.
Métodos de memoria latentecomo la compresión de contexto, ofrecen un término medio. Comprimen el conocimiento en «tokens blandos» compactos o representaciones que se agregan al contexto del modelo durante la inferencia. El error fatal aquí es el «acoplamiento de representaciones». La memoria comprimida está estrictamente ligada a la arquitectura del modelo que la produjo; no se puede transferir una memoria latente entrenada en un modelo de código abierto a uno de código cerrado.
Cómo funciona Memo
El marco MeMo (Memoria como modelo) presenta una arquitectura modular que presenta dos componentes separados. El modelo MEMORY es un modelo de lenguaje pequeño entrenado específicamente para codificar nuevos conocimientos en sus parámetros. El modelo EXECUTIVE es un LLM congelado y listo para usar que funciona como motor de razonamiento. Cuando un usuario hace una pregunta, el modelo EJECUTIVO trata el modelo MEMORIA como un oráculo externo, emitiendo subconsultas específicas para recopilar hechos y sintetizarlos en una respuesta final.
El principio central de diseño que impulsa a MeMo es el concepto de «reflejos». Las reflexiones son pares de preguntas y respuestas (QA) específicos diseñados para capturar todos los ángulos posibles de un corpus de conocimiento. En lugar de obligar a la IA a procesar un corpus de documentos masivo y no estructurado durante el entrenamiento, MeMo utiliza un modelo GENERADOR para destilar el texto sin formato en miles de pares de control de calidad específicos. Luego, el modelo MEMORY se afina en este conjunto de datos para responder preguntas utilizando solo su conocimiento paramétrico sin la necesidad de leer el contexto recuperado.
En el momento de la inferencia, la interacción entre los dos modelos sigue un protocolo estructurado de tres etapas:
1. El modelo EJECUTIVO descompone la consulta compleja de un usuario en un conjunto de subpreguntas atómicas. El modelo MEMORIA responde a cada uno de forma independiente para establecer los hechos básicos.
2. Utilizando esas pistas iniciales, el modelo EJECUTIVO emite consultas de seguimiento para limitar las entidades candidatas hasta que converja con confianza en un objetivo específico.
3. Finalmente, el modelo EJECUTIVO consulta el modelo MEMORIA en busca de datos de respaldo sobre esa entidad objetivo y sintetiza los fragmentos recuperados en una respuesta coherente.
Esta arquitectura fusiona las fortalezas de los tres paradigmas de memoria de IA existentes y evita sus dificultades. Aprovecha los modelos de frontera disponibles al mantener el almacenamiento de memoria separado del razonamiento, lo que garantiza la compatibilidad con modelos API cerrados y abiertos. Internaliza el conocimiento directamente en parámetros, pero aísla las actualizaciones en un modelo de MEMORIA dedicado más pequeño para proteger el motor de razonamiento. Finalmente, crea un artefacto de memoria consultable que no está vinculado a ningún modelo específico y se puede usar con diferentes familias de LLM.
Manejar actualizaciones continuas de conocimientos.
La gestión de la memoria de una IA requiere actualizaciones continuas a medida que cambian las políticas de la empresa y se publican nuevos informes. Normalmente, actualizar los parámetros de un modelo requiere volver a entrenarlo desde cero con los datos antiguos y nuevos combinados. A medida que crece la base de conocimientos, este costo acumulativo de reentrenamiento se vuelve inmanejable.
Para manejar las actualizaciones continuas de manera eficiente, MeMo se basa en una técnica llamada «fusión de modelos». En lugar de una fase masiva de reentrenamiento conjunto, MeMo entrena un modelo MEMORY nuevo e independiente exclusivamente en los documentos recién agregados. El sistema deriva un «vector de tareas» que representa los cambios de parámetros aprendidos a partir de los datos nuevos. Luego, estas actualizaciones se fusionan matemáticamente en los pesos del modelo de MEMORIA original.
Este enfoque reduce las horas de computación necesarias para mantener el sistema actualizado y al mismo tiempo evita la interferencia que provoca un olvido catastrófico.
Esta eficiencia viene con una compensación: la fusión de modelos genera una caída de precisión del 11% al 19% en comparación con un reentrenamiento completo, según el modelo de razonamiento utilizado.
Memo en acción
Para medir la eficacia en el mundo real, el equipo de investigación evaluó MeMo comparándolo con varios puntos de referencia de la industria que requieren un razonamiento complejo y de múltiples saltos en múltiples documentos.
Los investigadores utilizaron Qwen2.5-32B-Instruct como modelo GENERADOR para destilar texto sin formato en reflejos. Para el modelo de MEMORIA principal, implementaron Qwen2.5-14B-Instruct. También validaron el enfoque en modelos de parámetros más pequeños de 1 a 2 B en diferentes arquitecturas, incluida Gemma3-1B.
Para el modelo de razonamiento EJECUTIVO, probaron tanto el Qwen2.5-32B de peso abierto como el Gemini 3 Flash propiedad de Google.
Compararon MeMo con un límite superior de «Recuperación perfecta» (donde los documentos correctos exactos se proporcionan manualmente) y varios sistemas de recuperación avanzados, incluida la búsqueda tradicional BM25, la recuperación de vectores densos y el RAG basado en gráficos de última generación (HippoRAG2). También probaron «Cartuchos», un método reciente que carga una caché KV entrenado sobre el modelo durante la inferencia.
MeMo dominó el razonamiento de documentos largos. Según los investigadores, en el punto de referencia NarrativeQA, MeMo logró una precisión del 53,58% junto con Gemini 3 Flash. HippoRAG2 alcanzó un máximo del 23,21%.
Los sistemas empresariales con frecuencia necesitan sintetizar respuestas complejas, como atravesar marcos regulatorios superpuestos escritos de forma independiente por diferentes organismos, o consolidar conocimientos a través de una base de código masiva y documentación externa. Los sistemas RAG tradicionales fallan aquí porque alcanzan los límites de la ventana de contexto y no logran conectar conceptos que abarcan cientos de páginas. MeMo tiene éxito porque esas conexiones se asignan e internalizan dentro del modelo MEMORY durante el entrenamiento. Es «como tener un Malcolm Gladwell propio que pueda conectar la historia de los Beatles con la historia de Bill Gates para argumentar sobre la naturaleza de la experiencia», dijo Solar-Lezama.
Los experimentos revelaron otra ventaja importante: actualizar el motor de razonamiento no requiere ningún reentrenamiento. Simplemente cambiar el modelo EXECUTIVE del Qwen de código abierto al Gemini 3 Flash patentado aumentó el rendimiento de MeMo en un 26,73% en NarrativeQA y un 11,90% en el punto de referencia MuSiQue. Para los profesionales, esto significa que pueden entrenar un modelo de MEMORIA de forma segura con sus datos privados y conectarlo instantáneamente a las API comerciales más recientes, actualizando continuamente la inteligencia del sistema sin incurrir en nuevos costos de capacitación.
El equipo de investigación describió la integración como que no requiere configuración adicional: «El LLM base (o ejecutivo) que los equipos ya están usando en RAG se puede configurar para consultar el modelo de memoria directamente. Estas consultas se realizan en lenguaje natural, similar a enviar una solicitud de mensaje a una API, sin necesidad de configuración adicional».
MeMo también maneja excepcionalmente bien los datos ruidosos. Cuando los investigadores inundaron deliberadamente el conjunto de datos con documentos irrelevantes (hasta el doble de información útil), el rendimiento de HippoRAG2 cayó un 11,55%. El rendimiento de MeMo se mantuvo relativamente estable, cayendo menos del 2%. Las bases de conocimiento empresarial suelen ser confusas, llenas de documentos duplicados y políticas obsoletas. Los sistemas RAG estándar luchan con este ruido, incorporando párrafos incorrectos al mensaje y provocando alucinaciones. Debido a que el modelo EXECUTIVE de MeMo interactúa con un oráculo sintetizado en lugar de con fragmentos de documentos sin procesar, sigue siendo muy robusto contra datos corporativos desorganizados.
Limitaciones y compensaciones
Para los equipos de ingeniería que buscan implementar MeMo, existen varias limitaciones clave a considerar.
A diferencia de los sistemas RAG tradicionales que indexan rápidamente documentos sin procesar en una base de datos vectorial, MeMo requiere un costo de capacitación inicial para cada nuevo corpus. El proceso de generación de datos utilizado para sintetizar las reflexiones de entrenamiento es computacionalmente costoso. Por ejemplo, el equipo observó que «generar el conjunto de datos de control de calidad de reflexión completo tomó aproximadamente 240 horas de GPU en NVIDIA H200», mientras que entrenar un modelo de MEMORIA de parámetros 14B «tomó aproximadamente 180 horas de GPU H200». Como dijo Solar-Lezama, «Reducir el coste de la formación es uno de los problemas de investigación abiertos más importantes para hacer de esta técnica un caballo de batalla».
Debido a que el modelo MEMORIA es una red neuronal de tamaño fijo, su capacidad para internalizar conocimiento está limitada por su capacidad de representación. Si bien los investigadores no alcanzaron un límite estricto durante su evaluación comparativa, plantean la hipótesis de que «los corpus suficientemente grandes o densos en información excederán lo que un modelo de MEMORIA de tamaño fijo puede comprimir y representar correctamente».
Finalmente, debido a que MeMo sintetiza respuestas a partir de la memoria paramétrica en lugar de recuperar fragmentos de texto exactos, oscurece la procedencia de la información. Esto dificulta atribuir afirmaciones específicas a documentos originales, lo que plantea un problema de cumplimiento crítico para las aplicaciones empresariales que requieren seguimientos de auditoría estrictos.
Decidir entre MeMo y RAG tradicional se reduce a una heurística de «búsqueda versus síntesis», junto con la volatilidad de los datos. Los investigadores advierten que «se preferiría el RAG tradicional cuando las respuestas se encuentran en un solo documento o cuando hay una fuente bien definida… Se preferiría MeMo cuando la tarea pasa de la búsqueda a la síntesis de una respuesta a partir de información dispersa en múltiples fragmentos». Si su corpus de conocimientos cambia rápidamente (por ejemplo, feeds diarios) y necesita citas de fuentes exactas, RAG sigue siendo la mejor opción debido al costo inicial de capacitación de MeMo. Si su corpus consiste en conocimiento de dominio generalizado que evoluciona lentamente en relación con su volumen, MeMo ofrece un razonamiento muy superior. Los equipos también pueden adoptar una arquitectura de enrutamiento híbrida en producción: enviar consultas de «búsqueda» a una base de datos vectorial estándar y consultas de «síntesis» al modelo MEMORIA.
«Mirando más allá, esperaría que los modelos de memoria se convirtieran en un componente arquitectónico estándar junto con la recuperación», dijo a VentureBeat Daniela Rus, coautora del artículo y directora del Laboratorio de Ciencias de la Computación e Inteligencia Artificial (CSAIL) del MIT, «de la misma manera que el almacenamiento en caché y la indexación son componentes estándar de cualquier sistema de datos serio en la actualidad».
Suscríbete y recibe las historias más importantes del día.
Al suscribirte aceptas nuestros términos y condiciones y política de privacidad.
Permitir que los LLM adquieran nuevos conocimientos después de la capacitación sigue siendo un obstáculo importante para la IA empresarial: las soluciones actuales son demasiado caras, demasiado lentas o están limitadas por los límites de la ventana de contexto.
Memorándumun marco de investigadores de varias universidades, codifica nuevos conocimientos en un modelo de memoria más pequeño dedicado que opera por separado del LLM principal.
La arquitectura modular funciona con modelos de código abierto y cerrado y evita la complejidad de las canalizaciones RAG y el reentrenamiento completo del modelo.
Los experimentos muestran que MeMo maneja consultas complejas de manera confiable incluso cuando los canales de recuperación son ruidosos. Evita el olvido catastrófico asociado con el ajuste directo y proporciona una vía rentable para actualizaciones continuas de conocimientos.
El desafío de actualizar la memoria LLM
Los modelos de lenguaje grandes se congelan después del entrenamiento y su conocimiento interno permanece estático hasta que se someten a actualizaciones computacionalmente masivas posteriores.
Actualmente, los desarrolladores se basan en tres enfoques principales para integrar el conocimiento externo en un LLM, cada uno con distintos inconvenientes:
Métodos no paramétricoscomo la generación aumentada de recuperación (RAG) y aprendizaje en contextorecupere documentos relevantes de una base de datos externa e insértelos directamente en el mensaje del modelo. Si bien son populares, estos métodos están limitados por el tamaño de las ventanas de contexto.
Como Armando Solar-Lezama, coautor del artículo, le dijo a VentureBeat: «Las bases de datos vectoriales tienen la tarea fundamentalmente difícil de codificar la semántica completa de un fragmento de texto en un solo vector y luego hacer coincidir ese vector con una consulta, incluso cuando la relevancia del fragmento… sólo puede ser aparente en el contexto de otros fragmentos».
Los investigadores señalan que la similitud semántica de las incrustaciones a menudo no se corresponde con lo que realmente requiere la consulta del usuario. El procesamiento de miles de tokens recuperados también genera una importante sobrecarga computacional y latencia de inferencia. Lo más problemático es que los sistemas RAG son muy sensibles al ruido. Los pasajes irrelevantes o mal recuperados a menudo degradan la respuesta final del modelo.
Métodos paramétricosal igual que la capacitación previa continua o el ajuste fino supervisado, intentan internalizar nuevos conocimientos directamente en los pesos del LLM. La actualización de LLM modernos y masivos es prohibitivamente costosa y, por lo general, imposible para los modelos propietarios de código cerrado ocultos detrás de las API. El ajuste fino también es propenso a causar olvido catastrófico. Obligar al modelo a adaptarse a nuevos datos corporativos a menudo erosiona sus capacidades de razonamiento y barreras de seguridad previamente adquiridas.
Métodos de memoria latentecomo la compresión de contexto, ofrecen un término medio. Comprimen el conocimiento en «tokens blandos» compactos o representaciones que se agregan al contexto del modelo durante la inferencia. El error fatal aquí es el «acoplamiento de representaciones». La memoria comprimida está estrictamente ligada a la arquitectura del modelo que la produjo; no se puede transferir una memoria latente entrenada en un modelo de código abierto a uno de código cerrado.
Cómo funciona Memo
El marco MeMo (Memoria como modelo) presenta una arquitectura modular que presenta dos componentes separados. El modelo MEMORY es un modelo de lenguaje pequeño entrenado específicamente para codificar nuevos conocimientos en sus parámetros. El modelo EXECUTIVE es un LLM congelado y listo para usar que funciona como motor de razonamiento. Cuando un usuario hace una pregunta, el modelo EJECUTIVO trata el modelo MEMORIA como un oráculo externo, emitiendo subconsultas específicas para recopilar hechos y sintetizarlos en una respuesta final.
El principio central de diseño que impulsa a MeMo es el concepto de «reflejos». Las reflexiones son pares de preguntas y respuestas (QA) específicos diseñados para capturar todos los ángulos posibles de un corpus de conocimiento. En lugar de obligar a la IA a procesar un corpus de documentos masivo y no estructurado durante el entrenamiento, MeMo utiliza un modelo GENERADOR para destilar el texto sin formato en miles de pares de control de calidad específicos. Luego, el modelo MEMORY se afina en este conjunto de datos para responder preguntas utilizando solo su conocimiento paramétrico sin la necesidad de leer el contexto recuperado.
En el momento de la inferencia, la interacción entre los dos modelos sigue un protocolo estructurado de tres etapas:
1. El modelo EJECUTIVO descompone la consulta compleja de un usuario en un conjunto de subpreguntas atómicas. El modelo MEMORIA responde a cada uno de forma independiente para establecer los hechos básicos.
2. Utilizando esas pistas iniciales, el modelo EJECUTIVO emite consultas de seguimiento para limitar las entidades candidatas hasta que converja con confianza en un objetivo específico.
3. Finalmente, el modelo EJECUTIVO consulta el modelo MEMORIA en busca de datos de respaldo sobre esa entidad objetivo y sintetiza los fragmentos recuperados en una respuesta coherente.
Esta arquitectura fusiona las fortalezas de los tres paradigmas de memoria de IA existentes y evita sus dificultades. Aprovecha los modelos de frontera disponibles al mantener el almacenamiento de memoria separado del razonamiento, lo que garantiza la compatibilidad con modelos API cerrados y abiertos. Internaliza el conocimiento directamente en parámetros, pero aísla las actualizaciones en un modelo de MEMORIA dedicado más pequeño para proteger el motor de razonamiento. Finalmente, crea un artefacto de memoria consultable que no está vinculado a ningún modelo específico y se puede usar con diferentes familias de LLM.
Manejar actualizaciones continuas de conocimientos.
La gestión de la memoria de una IA requiere actualizaciones continuas a medida que cambian las políticas de la empresa y se publican nuevos informes. Normalmente, actualizar los parámetros de un modelo requiere volver a entrenarlo desde cero con los datos antiguos y nuevos combinados. A medida que crece la base de conocimientos, este costo acumulativo de reentrenamiento se vuelve inmanejable.
Para manejar las actualizaciones continuas de manera eficiente, MeMo se basa en una técnica llamada «fusión de modelos». En lugar de una fase masiva de reentrenamiento conjunto, MeMo entrena un modelo MEMORY nuevo e independiente exclusivamente en los documentos recién agregados. El sistema deriva un «vector de tareas» que representa los cambios de parámetros aprendidos a partir de los datos nuevos. Luego, estas actualizaciones se fusionan matemáticamente en los pesos del modelo de MEMORIA original.
Este enfoque reduce las horas de computación necesarias para mantener el sistema actualizado y al mismo tiempo evita la interferencia que provoca un olvido catastrófico.
Esta eficiencia viene con una compensación: la fusión de modelos genera una caída de precisión del 11% al 19% en comparación con un reentrenamiento completo, según el modelo de razonamiento utilizado.
Memo en acción
Para medir la eficacia en el mundo real, el equipo de investigación evaluó MeMo comparándolo con varios puntos de referencia de la industria que requieren un razonamiento complejo y de múltiples saltos en múltiples documentos.
Los investigadores utilizaron Qwen2.5-32B-Instruct como modelo GENERADOR para destilar texto sin formato en reflejos. Para el modelo de MEMORIA principal, implementaron Qwen2.5-14B-Instruct. También validaron el enfoque en modelos de parámetros más pequeños de 1 a 2 B en diferentes arquitecturas, incluida Gemma3-1B.
Para el modelo de razonamiento EJECUTIVO, probaron tanto el Qwen2.5-32B de peso abierto como el Gemini 3 Flash propiedad de Google.
Compararon MeMo con un límite superior de «Recuperación perfecta» (donde los documentos correctos exactos se proporcionan manualmente) y varios sistemas de recuperación avanzados, incluida la búsqueda tradicional BM25, la recuperación de vectores densos y el RAG basado en gráficos de última generación (HippoRAG2). También probaron «Cartuchos», un método reciente que carga una caché KV entrenado sobre el modelo durante la inferencia.
MeMo dominó el razonamiento de documentos largos. Según los investigadores, en el punto de referencia NarrativeQA, MeMo logró una precisión del 53,58% junto con Gemini 3 Flash. HippoRAG2 alcanzó un máximo del 23,21%.
Los sistemas empresariales con frecuencia necesitan sintetizar respuestas complejas, como atravesar marcos regulatorios superpuestos escritos de forma independiente por diferentes organismos, o consolidar conocimientos a través de una base de código masiva y documentación externa. Los sistemas RAG tradicionales fallan aquí porque alcanzan los límites de la ventana de contexto y no logran conectar conceptos que abarcan cientos de páginas. MeMo tiene éxito porque esas conexiones se asignan e internalizan dentro del modelo MEMORY durante el entrenamiento. Es «como tener un Malcolm Gladwell propio que pueda conectar la historia de los Beatles con la historia de Bill Gates para argumentar sobre la naturaleza de la experiencia», dijo Solar-Lezama.
Los experimentos revelaron otra ventaja importante: actualizar el motor de razonamiento no requiere ningún reentrenamiento. Simplemente cambiar el modelo EXECUTIVE del Qwen de código abierto al Gemini 3 Flash patentado aumentó el rendimiento de MeMo en un 26,73% en NarrativeQA y un 11,90% en el punto de referencia MuSiQue. Para los profesionales, esto significa que pueden entrenar un modelo de MEMORIA de forma segura con sus datos privados y conectarlo instantáneamente a las API comerciales más recientes, actualizando continuamente la inteligencia del sistema sin incurrir en nuevos costos de capacitación.
El equipo de investigación describió la integración como que no requiere configuración adicional: «El LLM base (o ejecutivo) que los equipos ya están usando en RAG se puede configurar para consultar el modelo de memoria directamente. Estas consultas se realizan en lenguaje natural, similar a enviar una solicitud de mensaje a una API, sin necesidad de configuración adicional».
MeMo también maneja excepcionalmente bien los datos ruidosos. Cuando los investigadores inundaron deliberadamente el conjunto de datos con documentos irrelevantes (hasta el doble de información útil), el rendimiento de HippoRAG2 cayó un 11,55%. El rendimiento de MeMo se mantuvo relativamente estable, cayendo menos del 2%. Las bases de conocimiento empresarial suelen ser confusas, llenas de documentos duplicados y políticas obsoletas. Los sistemas RAG estándar luchan con este ruido, incorporando párrafos incorrectos al mensaje y provocando alucinaciones. Debido a que el modelo EXECUTIVE de MeMo interactúa con un oráculo sintetizado en lugar de con fragmentos de documentos sin procesar, sigue siendo muy robusto contra datos corporativos desorganizados.
Limitaciones y compensaciones
Para los equipos de ingeniería que buscan implementar MeMo, existen varias limitaciones clave a considerar.
A diferencia de los sistemas RAG tradicionales que indexan rápidamente documentos sin procesar en una base de datos vectorial, MeMo requiere un costo de capacitación inicial para cada nuevo corpus. El proceso de generación de datos utilizado para sintetizar las reflexiones de entrenamiento es computacionalmente costoso. Por ejemplo, el equipo observó que «generar el conjunto de datos de control de calidad de reflexión completo tomó aproximadamente 240 horas de GPU en NVIDIA H200», mientras que entrenar un modelo de MEMORIA de parámetros 14B «tomó aproximadamente 180 horas de GPU H200». Como dijo Solar-Lezama, «Reducir el coste de la formación es uno de los problemas de investigación abiertos más importantes para hacer de esta técnica un caballo de batalla».
Debido a que el modelo MEMORIA es una red neuronal de tamaño fijo, su capacidad para internalizar conocimiento está limitada por su capacidad de representación. Si bien los investigadores no alcanzaron un límite estricto durante su evaluación comparativa, plantean la hipótesis de que «los corpus suficientemente grandes o densos en información excederán lo que un modelo de MEMORIA de tamaño fijo puede comprimir y representar correctamente».
Finalmente, debido a que MeMo sintetiza respuestas a partir de la memoria paramétrica en lugar de recuperar fragmentos de texto exactos, oscurece la procedencia de la información. Esto dificulta atribuir afirmaciones específicas a documentos originales, lo que plantea un problema de cumplimiento crítico para las aplicaciones empresariales que requieren seguimientos de auditoría estrictos.
Decidir entre MeMo y RAG tradicional se reduce a una heurística de «búsqueda versus síntesis», junto con la volatilidad de los datos. Los investigadores advierten que «se preferiría el RAG tradicional cuando las respuestas se encuentran en un solo documento o cuando hay una fuente bien definida… Se preferiría MeMo cuando la tarea pasa de la búsqueda a la síntesis de una respuesta a partir de información dispersa en múltiples fragmentos». Si su corpus de conocimientos cambia rápidamente (por ejemplo, feeds diarios) y necesita citas de fuentes exactas, RAG sigue siendo la mejor opción debido al costo inicial de capacitación de MeMo. Si su corpus consiste en conocimiento de dominio generalizado que evoluciona lentamente en relación con su volumen, MeMo ofrece un razonamiento muy superior. Los equipos también pueden adoptar una arquitectura de enrutamiento híbrida en producción: enviar consultas de «búsqueda» a una base de datos vectorial estándar y consultas de «síntesis» al modelo MEMORIA.
«Mirando más allá, esperaría que los modelos de memoria se convirtieran en un componente arquitectónico estándar junto con la recuperación», dijo a VentureBeat Daniela Rus, coautora del artículo y directora del Laboratorio de Ciencias de la Computación e Inteligencia Artificial (CSAIL) del MIT, «de la misma manera que el almacenamiento en caché y la indexación son componentes estándar de cualquier sistema de datos serio en la actualidad».
Permitir que los LLM adquieran nuevos conocimientos después de la capacitación sigue siendo un obstáculo importante para la IA empresarial: las soluciones actuales son demasiado caras, demasiado lentas o están limitadas por los límites de la ventana de contexto.
Memorándumun marco de investigadores de varias universidades, codifica nuevos conocimientos en un modelo de memoria más pequeño dedicado que opera por separado del LLM principal.
La arquitectura modular funciona con modelos de código abierto y cerrado y evita la complejidad de las canalizaciones RAG y el reentrenamiento completo del modelo.
Los experimentos muestran que MeMo maneja consultas complejas de manera confiable incluso cuando los canales de recuperación son ruidosos. Evita el olvido catastrófico asociado con el ajuste directo y proporciona una vía rentable para actualizaciones continuas de conocimientos.
El desafío de actualizar la memoria LLM
Los modelos de lenguaje grandes se congelan después del entrenamiento y su conocimiento interno permanece estático hasta que se someten a actualizaciones computacionalmente masivas posteriores.
Actualmente, los desarrolladores se basan en tres enfoques principales para integrar el conocimiento externo en un LLM, cada uno con distintos inconvenientes:
Métodos no paramétricoscomo la generación aumentada de recuperación (RAG) y aprendizaje en contextorecupere documentos relevantes de una base de datos externa e insértelos directamente en el mensaje del modelo. Si bien son populares, estos métodos están limitados por el tamaño de las ventanas de contexto.
Como Armando Solar-Lezama, coautor del artículo, le dijo a VentureBeat: «Las bases de datos vectoriales tienen la tarea fundamentalmente difícil de codificar la semántica completa de un fragmento de texto en un solo vector y luego hacer coincidir ese vector con una consulta, incluso cuando la relevancia del fragmento… sólo puede ser aparente en el contexto de otros fragmentos».
Los investigadores señalan que la similitud semántica de las incrustaciones a menudo no se corresponde con lo que realmente requiere la consulta del usuario. El procesamiento de miles de tokens recuperados también genera una importante sobrecarga computacional y latencia de inferencia. Lo más problemático es que los sistemas RAG son muy sensibles al ruido. Los pasajes irrelevantes o mal recuperados a menudo degradan la respuesta final del modelo.
Métodos paramétricosal igual que la capacitación previa continua o el ajuste fino supervisado, intentan internalizar nuevos conocimientos directamente en los pesos del LLM. La actualización de LLM modernos y masivos es prohibitivamente costosa y, por lo general, imposible para los modelos propietarios de código cerrado ocultos detrás de las API. El ajuste fino también es propenso a causar olvido catastrófico. Obligar al modelo a adaptarse a nuevos datos corporativos a menudo erosiona sus capacidades de razonamiento y barreras de seguridad previamente adquiridas.
Métodos de memoria latentecomo la compresión de contexto, ofrecen un término medio. Comprimen el conocimiento en «tokens blandos» compactos o representaciones que se agregan al contexto del modelo durante la inferencia. El error fatal aquí es el «acoplamiento de representaciones». La memoria comprimida está estrictamente ligada a la arquitectura del modelo que la produjo; no se puede transferir una memoria latente entrenada en un modelo de código abierto a uno de código cerrado.
Cómo funciona Memo
El marco MeMo (Memoria como modelo) presenta una arquitectura modular que presenta dos componentes separados. El modelo MEMORY es un modelo de lenguaje pequeño entrenado específicamente para codificar nuevos conocimientos en sus parámetros. El modelo EXECUTIVE es un LLM congelado y listo para usar que funciona como motor de razonamiento. Cuando un usuario hace una pregunta, el modelo EJECUTIVO trata el modelo MEMORIA como un oráculo externo, emitiendo subconsultas específicas para recopilar hechos y sintetizarlos en una respuesta final.
El principio central de diseño que impulsa a MeMo es el concepto de «reflejos». Las reflexiones son pares de preguntas y respuestas (QA) específicos diseñados para capturar todos los ángulos posibles de un corpus de conocimiento. En lugar de obligar a la IA a procesar un corpus de documentos masivo y no estructurado durante el entrenamiento, MeMo utiliza un modelo GENERADOR para destilar el texto sin formato en miles de pares de control de calidad específicos. Luego, el modelo MEMORY se afina en este conjunto de datos para responder preguntas utilizando solo su conocimiento paramétrico sin la necesidad de leer el contexto recuperado.
En el momento de la inferencia, la interacción entre los dos modelos sigue un protocolo estructurado de tres etapas:
1. El modelo EJECUTIVO descompone la consulta compleja de un usuario en un conjunto de subpreguntas atómicas. El modelo MEMORIA responde a cada uno de forma independiente para establecer los hechos básicos.
2. Utilizando esas pistas iniciales, el modelo EJECUTIVO emite consultas de seguimiento para limitar las entidades candidatas hasta que converja con confianza en un objetivo específico.
3. Finalmente, el modelo EJECUTIVO consulta el modelo MEMORIA en busca de datos de respaldo sobre esa entidad objetivo y sintetiza los fragmentos recuperados en una respuesta coherente.
Esta arquitectura fusiona las fortalezas de los tres paradigmas de memoria de IA existentes y evita sus dificultades. Aprovecha los modelos de frontera disponibles al mantener el almacenamiento de memoria separado del razonamiento, lo que garantiza la compatibilidad con modelos API cerrados y abiertos. Internaliza el conocimiento directamente en parámetros, pero aísla las actualizaciones en un modelo de MEMORIA dedicado más pequeño para proteger el motor de razonamiento. Finalmente, crea un artefacto de memoria consultable que no está vinculado a ningún modelo específico y se puede usar con diferentes familias de LLM.
Manejar actualizaciones continuas de conocimientos.
La gestión de la memoria de una IA requiere actualizaciones continuas a medida que cambian las políticas de la empresa y se publican nuevos informes. Normalmente, actualizar los parámetros de un modelo requiere volver a entrenarlo desde cero con los datos antiguos y nuevos combinados. A medida que crece la base de conocimientos, este costo acumulativo de reentrenamiento se vuelve inmanejable.
Para manejar las actualizaciones continuas de manera eficiente, MeMo se basa en una técnica llamada «fusión de modelos». En lugar de una fase masiva de reentrenamiento conjunto, MeMo entrena un modelo MEMORY nuevo e independiente exclusivamente en los documentos recién agregados. El sistema deriva un «vector de tareas» que representa los cambios de parámetros aprendidos a partir de los datos nuevos. Luego, estas actualizaciones se fusionan matemáticamente en los pesos del modelo de MEMORIA original.
Este enfoque reduce las horas de computación necesarias para mantener el sistema actualizado y al mismo tiempo evita la interferencia que provoca un olvido catastrófico.
Esta eficiencia viene con una compensación: la fusión de modelos genera una caída de precisión del 11% al 19% en comparación con un reentrenamiento completo, según el modelo de razonamiento utilizado.
Memo en acción
Para medir la eficacia en el mundo real, el equipo de investigación evaluó MeMo comparándolo con varios puntos de referencia de la industria que requieren un razonamiento complejo y de múltiples saltos en múltiples documentos.
Los investigadores utilizaron Qwen2.5-32B-Instruct como modelo GENERADOR para destilar texto sin formato en reflejos. Para el modelo de MEMORIA principal, implementaron Qwen2.5-14B-Instruct. También validaron el enfoque en modelos de parámetros más pequeños de 1 a 2 B en diferentes arquitecturas, incluida Gemma3-1B.
Para el modelo de razonamiento EJECUTIVO, probaron tanto el Qwen2.5-32B de peso abierto como el Gemini 3 Flash propiedad de Google.
Compararon MeMo con un límite superior de «Recuperación perfecta» (donde los documentos correctos exactos se proporcionan manualmente) y varios sistemas de recuperación avanzados, incluida la búsqueda tradicional BM25, la recuperación de vectores densos y el RAG basado en gráficos de última generación (HippoRAG2). También probaron «Cartuchos», un método reciente que carga una caché KV entrenado sobre el modelo durante la inferencia.
MeMo dominó el razonamiento de documentos largos. Según los investigadores, en el punto de referencia NarrativeQA, MeMo logró una precisión del 53,58% junto con Gemini 3 Flash. HippoRAG2 alcanzó un máximo del 23,21%.
Los sistemas empresariales con frecuencia necesitan sintetizar respuestas complejas, como atravesar marcos regulatorios superpuestos escritos de forma independiente por diferentes organismos, o consolidar conocimientos a través de una base de código masiva y documentación externa. Los sistemas RAG tradicionales fallan aquí porque alcanzan los límites de la ventana de contexto y no logran conectar conceptos que abarcan cientos de páginas. MeMo tiene éxito porque esas conexiones se asignan e internalizan dentro del modelo MEMORY durante el entrenamiento. Es «como tener un Malcolm Gladwell propio que pueda conectar la historia de los Beatles con la historia de Bill Gates para argumentar sobre la naturaleza de la experiencia», dijo Solar-Lezama.
Los experimentos revelaron otra ventaja importante: actualizar el motor de razonamiento no requiere ningún reentrenamiento. Simplemente cambiar el modelo EXECUTIVE del Qwen de código abierto al Gemini 3 Flash patentado aumentó el rendimiento de MeMo en un 26,73% en NarrativeQA y un 11,90% en el punto de referencia MuSiQue. Para los profesionales, esto significa que pueden entrenar un modelo de MEMORIA de forma segura con sus datos privados y conectarlo instantáneamente a las API comerciales más recientes, actualizando continuamente la inteligencia del sistema sin incurrir en nuevos costos de capacitación.
El equipo de investigación describió la integración como que no requiere configuración adicional: «El LLM base (o ejecutivo) que los equipos ya están usando en RAG se puede configurar para consultar el modelo de memoria directamente. Estas consultas se realizan en lenguaje natural, similar a enviar una solicitud de mensaje a una API, sin necesidad de configuración adicional».
MeMo también maneja excepcionalmente bien los datos ruidosos. Cuando los investigadores inundaron deliberadamente el conjunto de datos con documentos irrelevantes (hasta el doble de información útil), el rendimiento de HippoRAG2 cayó un 11,55%. El rendimiento de MeMo se mantuvo relativamente estable, cayendo menos del 2%. Las bases de conocimiento empresarial suelen ser confusas, llenas de documentos duplicados y políticas obsoletas. Los sistemas RAG estándar luchan con este ruido, incorporando párrafos incorrectos al mensaje y provocando alucinaciones. Debido a que el modelo EXECUTIVE de MeMo interactúa con un oráculo sintetizado en lugar de con fragmentos de documentos sin procesar, sigue siendo muy robusto contra datos corporativos desorganizados.
Limitaciones y compensaciones
Para los equipos de ingeniería que buscan implementar MeMo, existen varias limitaciones clave a considerar.
A diferencia de los sistemas RAG tradicionales que indexan rápidamente documentos sin procesar en una base de datos vectorial, MeMo requiere un costo de capacitación inicial para cada nuevo corpus. El proceso de generación de datos utilizado para sintetizar las reflexiones de entrenamiento es computacionalmente costoso. Por ejemplo, el equipo observó que «generar el conjunto de datos de control de calidad de reflexión completo tomó aproximadamente 240 horas de GPU en NVIDIA H200», mientras que entrenar un modelo de MEMORIA de parámetros 14B «tomó aproximadamente 180 horas de GPU H200». Como dijo Solar-Lezama, «Reducir el coste de la formación es uno de los problemas de investigación abiertos más importantes para hacer de esta técnica un caballo de batalla».
Debido a que el modelo MEMORIA es una red neuronal de tamaño fijo, su capacidad para internalizar conocimiento está limitada por su capacidad de representación. Si bien los investigadores no alcanzaron un límite estricto durante su evaluación comparativa, plantean la hipótesis de que «los corpus suficientemente grandes o densos en información excederán lo que un modelo de MEMORIA de tamaño fijo puede comprimir y representar correctamente».
Finalmente, debido a que MeMo sintetiza respuestas a partir de la memoria paramétrica en lugar de recuperar fragmentos de texto exactos, oscurece la procedencia de la información. Esto dificulta atribuir afirmaciones específicas a documentos originales, lo que plantea un problema de cumplimiento crítico para las aplicaciones empresariales que requieren seguimientos de auditoría estrictos.
Decidir entre MeMo y RAG tradicional se reduce a una heurística de «búsqueda versus síntesis», junto con la volatilidad de los datos. Los investigadores advierten que «se preferiría el RAG tradicional cuando las respuestas se encuentran en un solo documento o cuando hay una fuente bien definida… Se preferiría MeMo cuando la tarea pasa de la búsqueda a la síntesis de una respuesta a partir de información dispersa en múltiples fragmentos». Si su corpus de conocimientos cambia rápidamente (por ejemplo, feeds diarios) y necesita citas de fuentes exactas, RAG sigue siendo la mejor opción debido al costo inicial de capacitación de MeMo. Si su corpus consiste en conocimiento de dominio generalizado que evoluciona lentamente en relación con su volumen, MeMo ofrece un razonamiento muy superior. Los equipos también pueden adoptar una arquitectura de enrutamiento híbrida en producción: enviar consultas de «búsqueda» a una base de datos vectorial estándar y consultas de «síntesis» al modelo MEMORIA.
«Mirando más allá, esperaría que los modelos de memoria se convirtieran en un componente arquitectónico estándar junto con la recuperación», dijo a VentureBeat Daniela Rus, coautora del artículo y directora del Laboratorio de Ciencias de la Computación e Inteligencia Artificial (CSAIL) del MIT, «de la misma manera que el almacenamiento en caché y la indexación son componentes estándar de cualquier sistema de datos serio en la actualidad».
Permitir que los LLM adquieran nuevos conocimientos después de la capacitación sigue siendo un obstáculo importante para la IA empresarial: las soluciones actuales son demasiado caras, demasiado lentas o están limitadas por los límites de la ventana de contexto.
Memorándumun marco de investigadores de varias universidades, codifica nuevos conocimientos en un modelo de memoria más pequeño dedicado que opera por separado del LLM principal.
La arquitectura modular funciona con modelos de código abierto y cerrado y evita la complejidad de las canalizaciones RAG y el reentrenamiento completo del modelo.
Los experimentos muestran que MeMo maneja consultas complejas de manera confiable incluso cuando los canales de recuperación son ruidosos. Evita el olvido catastrófico asociado con el ajuste directo y proporciona una vía rentable para actualizaciones continuas de conocimientos.
El desafío de actualizar la memoria LLM
Los modelos de lenguaje grandes se congelan después del entrenamiento y su conocimiento interno permanece estático hasta que se someten a actualizaciones computacionalmente masivas posteriores.
Actualmente, los desarrolladores se basan en tres enfoques principales para integrar el conocimiento externo en un LLM, cada uno con distintos inconvenientes:
Métodos no paramétricoscomo la generación aumentada de recuperación (RAG) y aprendizaje en contextorecupere documentos relevantes de una base de datos externa e insértelos directamente en el mensaje del modelo. Si bien son populares, estos métodos están limitados por el tamaño de las ventanas de contexto.
Como Armando Solar-Lezama, coautor del artículo, le dijo a VentureBeat: «Las bases de datos vectoriales tienen la tarea fundamentalmente difícil de codificar la semántica completa de un fragmento de texto en un solo vector y luego hacer coincidir ese vector con una consulta, incluso cuando la relevancia del fragmento… sólo puede ser aparente en el contexto de otros fragmentos».
Los investigadores señalan que la similitud semántica de las incrustaciones a menudo no se corresponde con lo que realmente requiere la consulta del usuario. El procesamiento de miles de tokens recuperados también genera una importante sobrecarga computacional y latencia de inferencia. Lo más problemático es que los sistemas RAG son muy sensibles al ruido. Los pasajes irrelevantes o mal recuperados a menudo degradan la respuesta final del modelo.
Métodos paramétricosal igual que la capacitación previa continua o el ajuste fino supervisado, intentan internalizar nuevos conocimientos directamente en los pesos del LLM. La actualización de LLM modernos y masivos es prohibitivamente costosa y, por lo general, imposible para los modelos propietarios de código cerrado ocultos detrás de las API. El ajuste fino también es propenso a causar olvido catastrófico. Obligar al modelo a adaptarse a nuevos datos corporativos a menudo erosiona sus capacidades de razonamiento y barreras de seguridad previamente adquiridas.
Métodos de memoria latentecomo la compresión de contexto, ofrecen un término medio. Comprimen el conocimiento en «tokens blandos» compactos o representaciones que se agregan al contexto del modelo durante la inferencia. El error fatal aquí es el «acoplamiento de representaciones». La memoria comprimida está estrictamente ligada a la arquitectura del modelo que la produjo; no se puede transferir una memoria latente entrenada en un modelo de código abierto a uno de código cerrado.
Cómo funciona Memo
El marco MeMo (Memoria como modelo) presenta una arquitectura modular que presenta dos componentes separados. El modelo MEMORY es un modelo de lenguaje pequeño entrenado específicamente para codificar nuevos conocimientos en sus parámetros. El modelo EXECUTIVE es un LLM congelado y listo para usar que funciona como motor de razonamiento. Cuando un usuario hace una pregunta, el modelo EJECUTIVO trata el modelo MEMORIA como un oráculo externo, emitiendo subconsultas específicas para recopilar hechos y sintetizarlos en una respuesta final.
El principio central de diseño que impulsa a MeMo es el concepto de «reflejos». Las reflexiones son pares de preguntas y respuestas (QA) específicos diseñados para capturar todos los ángulos posibles de un corpus de conocimiento. En lugar de obligar a la IA a procesar un corpus de documentos masivo y no estructurado durante el entrenamiento, MeMo utiliza un modelo GENERADOR para destilar el texto sin formato en miles de pares de control de calidad específicos. Luego, el modelo MEMORY se afina en este conjunto de datos para responder preguntas utilizando solo su conocimiento paramétrico sin la necesidad de leer el contexto recuperado.
En el momento de la inferencia, la interacción entre los dos modelos sigue un protocolo estructurado de tres etapas:
1. El modelo EJECUTIVO descompone la consulta compleja de un usuario en un conjunto de subpreguntas atómicas. El modelo MEMORIA responde a cada uno de forma independiente para establecer los hechos básicos.
2. Utilizando esas pistas iniciales, el modelo EJECUTIVO emite consultas de seguimiento para limitar las entidades candidatas hasta que converja con confianza en un objetivo específico.
3. Finalmente, el modelo EJECUTIVO consulta el modelo MEMORIA en busca de datos de respaldo sobre esa entidad objetivo y sintetiza los fragmentos recuperados en una respuesta coherente.
Esta arquitectura fusiona las fortalezas de los tres paradigmas de memoria de IA existentes y evita sus dificultades. Aprovecha los modelos de frontera disponibles al mantener el almacenamiento de memoria separado del razonamiento, lo que garantiza la compatibilidad con modelos API cerrados y abiertos. Internaliza el conocimiento directamente en parámetros, pero aísla las actualizaciones en un modelo de MEMORIA dedicado más pequeño para proteger el motor de razonamiento. Finalmente, crea un artefacto de memoria consultable que no está vinculado a ningún modelo específico y se puede usar con diferentes familias de LLM.
Manejar actualizaciones continuas de conocimientos.
La gestión de la memoria de una IA requiere actualizaciones continuas a medida que cambian las políticas de la empresa y se publican nuevos informes. Normalmente, actualizar los parámetros de un modelo requiere volver a entrenarlo desde cero con los datos antiguos y nuevos combinados. A medida que crece la base de conocimientos, este costo acumulativo de reentrenamiento se vuelve inmanejable.
Para manejar las actualizaciones continuas de manera eficiente, MeMo se basa en una técnica llamada «fusión de modelos». En lugar de una fase masiva de reentrenamiento conjunto, MeMo entrena un modelo MEMORY nuevo e independiente exclusivamente en los documentos recién agregados. El sistema deriva un «vector de tareas» que representa los cambios de parámetros aprendidos a partir de los datos nuevos. Luego, estas actualizaciones se fusionan matemáticamente en los pesos del modelo de MEMORIA original.
Este enfoque reduce las horas de computación necesarias para mantener el sistema actualizado y al mismo tiempo evita la interferencia que provoca un olvido catastrófico.
Esta eficiencia viene con una compensación: la fusión de modelos genera una caída de precisión del 11% al 19% en comparación con un reentrenamiento completo, según el modelo de razonamiento utilizado.
Memo en acción
Para medir la eficacia en el mundo real, el equipo de investigación evaluó MeMo comparándolo con varios puntos de referencia de la industria que requieren un razonamiento complejo y de múltiples saltos en múltiples documentos.
Los investigadores utilizaron Qwen2.5-32B-Instruct como modelo GENERADOR para destilar texto sin formato en reflejos. Para el modelo de MEMORIA principal, implementaron Qwen2.5-14B-Instruct. También validaron el enfoque en modelos de parámetros más pequeños de 1 a 2 B en diferentes arquitecturas, incluida Gemma3-1B.
Para el modelo de razonamiento EJECUTIVO, probaron tanto el Qwen2.5-32B de peso abierto como el Gemini 3 Flash propiedad de Google.
Compararon MeMo con un límite superior de «Recuperación perfecta» (donde los documentos correctos exactos se proporcionan manualmente) y varios sistemas de recuperación avanzados, incluida la búsqueda tradicional BM25, la recuperación de vectores densos y el RAG basado en gráficos de última generación (HippoRAG2). También probaron «Cartuchos», un método reciente que carga una caché KV entrenado sobre el modelo durante la inferencia.
MeMo dominó el razonamiento de documentos largos. Según los investigadores, en el punto de referencia NarrativeQA, MeMo logró una precisión del 53,58% junto con Gemini 3 Flash. HippoRAG2 alcanzó un máximo del 23,21%.
Los sistemas empresariales con frecuencia necesitan sintetizar respuestas complejas, como atravesar marcos regulatorios superpuestos escritos de forma independiente por diferentes organismos, o consolidar conocimientos a través de una base de código masiva y documentación externa. Los sistemas RAG tradicionales fallan aquí porque alcanzan los límites de la ventana de contexto y no logran conectar conceptos que abarcan cientos de páginas. MeMo tiene éxito porque esas conexiones se asignan e internalizan dentro del modelo MEMORY durante el entrenamiento. Es «como tener un Malcolm Gladwell propio que pueda conectar la historia de los Beatles con la historia de Bill Gates para argumentar sobre la naturaleza de la experiencia», dijo Solar-Lezama.
Los experimentos revelaron otra ventaja importante: actualizar el motor de razonamiento no requiere ningún reentrenamiento. Simplemente cambiar el modelo EXECUTIVE del Qwen de código abierto al Gemini 3 Flash patentado aumentó el rendimiento de MeMo en un 26,73% en NarrativeQA y un 11,90% en el punto de referencia MuSiQue. Para los profesionales, esto significa que pueden entrenar un modelo de MEMORIA de forma segura con sus datos privados y conectarlo instantáneamente a las API comerciales más recientes, actualizando continuamente la inteligencia del sistema sin incurrir en nuevos costos de capacitación.
El equipo de investigación describió la integración como que no requiere configuración adicional: «El LLM base (o ejecutivo) que los equipos ya están usando en RAG se puede configurar para consultar el modelo de memoria directamente. Estas consultas se realizan en lenguaje natural, similar a enviar una solicitud de mensaje a una API, sin necesidad de configuración adicional».
MeMo también maneja excepcionalmente bien los datos ruidosos. Cuando los investigadores inundaron deliberadamente el conjunto de datos con documentos irrelevantes (hasta el doble de información útil), el rendimiento de HippoRAG2 cayó un 11,55%. El rendimiento de MeMo se mantuvo relativamente estable, cayendo menos del 2%. Las bases de conocimiento empresarial suelen ser confusas, llenas de documentos duplicados y políticas obsoletas. Los sistemas RAG estándar luchan con este ruido, incorporando párrafos incorrectos al mensaje y provocando alucinaciones. Debido a que el modelo EXECUTIVE de MeMo interactúa con un oráculo sintetizado en lugar de con fragmentos de documentos sin procesar, sigue siendo muy robusto contra datos corporativos desorganizados.
Limitaciones y compensaciones
Para los equipos de ingeniería que buscan implementar MeMo, existen varias limitaciones clave a considerar.
A diferencia de los sistemas RAG tradicionales que indexan rápidamente documentos sin procesar en una base de datos vectorial, MeMo requiere un costo de capacitación inicial para cada nuevo corpus. El proceso de generación de datos utilizado para sintetizar las reflexiones de entrenamiento es computacionalmente costoso. Por ejemplo, el equipo observó que «generar el conjunto de datos de control de calidad de reflexión completo tomó aproximadamente 240 horas de GPU en NVIDIA H200», mientras que entrenar un modelo de MEMORIA de parámetros 14B «tomó aproximadamente 180 horas de GPU H200». Como dijo Solar-Lezama, «Reducir el coste de la formación es uno de los problemas de investigación abiertos más importantes para hacer de esta técnica un caballo de batalla».
Debido a que el modelo MEMORIA es una red neuronal de tamaño fijo, su capacidad para internalizar conocimiento está limitada por su capacidad de representación. Si bien los investigadores no alcanzaron un límite estricto durante su evaluación comparativa, plantean la hipótesis de que «los corpus suficientemente grandes o densos en información excederán lo que un modelo de MEMORIA de tamaño fijo puede comprimir y representar correctamente».
Finalmente, debido a que MeMo sintetiza respuestas a partir de la memoria paramétrica en lugar de recuperar fragmentos de texto exactos, oscurece la procedencia de la información. Esto dificulta atribuir afirmaciones específicas a documentos originales, lo que plantea un problema de cumplimiento crítico para las aplicaciones empresariales que requieren seguimientos de auditoría estrictos.
Decidir entre MeMo y RAG tradicional se reduce a una heurística de «búsqueda versus síntesis», junto con la volatilidad de los datos. Los investigadores advierten que «se preferiría el RAG tradicional cuando las respuestas se encuentran en un solo documento o cuando hay una fuente bien definida… Se preferiría MeMo cuando la tarea pasa de la búsqueda a la síntesis de una respuesta a partir de información dispersa en múltiples fragmentos». Si su corpus de conocimientos cambia rápidamente (por ejemplo, feeds diarios) y necesita citas de fuentes exactas, RAG sigue siendo la mejor opción debido al costo inicial de capacitación de MeMo. Si su corpus consiste en conocimiento de dominio generalizado que evoluciona lentamente en relación con su volumen, MeMo ofrece un razonamiento muy superior. Los equipos también pueden adoptar una arquitectura de enrutamiento híbrida en producción: enviar consultas de «búsqueda» a una base de datos vectorial estándar y consultas de «síntesis» al modelo MEMORIA.
«Mirando más allá, esperaría que los modelos de memoria se convirtieran en un componente arquitectónico estándar junto con la recuperación», dijo a VentureBeat Daniela Rus, coautora del artículo y directora del Laboratorio de Ciencias de la Computación e Inteligencia Artificial (CSAIL) del MIT, «de la misma manera que el almacenamiento en caché y la indexación son componentes estándar de cualquier sistema de datos serio en la actualidad».
Permitir que los LLM adquieran nuevos conocimientos después de la capacitación sigue siendo un obstáculo importante para la IA empresarial: las soluciones actuales son demasiado caras, demasiado lentas o están limitadas por los límites de la ventana de contexto.
Memorándumun marco de investigadores de varias universidades, codifica nuevos conocimientos en un modelo de memoria más pequeño dedicado que opera por separado del LLM principal.
La arquitectura modular funciona con modelos de código abierto y cerrado y evita la complejidad de las canalizaciones RAG y el reentrenamiento completo del modelo.
Los experimentos muestran que MeMo maneja consultas complejas de manera confiable incluso cuando los canales de recuperación son ruidosos. Evita el olvido catastrófico asociado con el ajuste directo y proporciona una vía rentable para actualizaciones continuas de conocimientos.
El desafío de actualizar la memoria LLM
Los modelos de lenguaje grandes se congelan después del entrenamiento y su conocimiento interno permanece estático hasta que se someten a actualizaciones computacionalmente masivas posteriores.
Actualmente, los desarrolladores se basan en tres enfoques principales para integrar el conocimiento externo en un LLM, cada uno con distintos inconvenientes:
Métodos no paramétricoscomo la generación aumentada de recuperación (RAG) y aprendizaje en contextorecupere documentos relevantes de una base de datos externa e insértelos directamente en el mensaje del modelo. Si bien son populares, estos métodos están limitados por el tamaño de las ventanas de contexto.
Como Armando Solar-Lezama, coautor del artículo, le dijo a VentureBeat: «Las bases de datos vectoriales tienen la tarea fundamentalmente difícil de codificar la semántica completa de un fragmento de texto en un solo vector y luego hacer coincidir ese vector con una consulta, incluso cuando la relevancia del fragmento… sólo puede ser aparente en el contexto de otros fragmentos».
Los investigadores señalan que la similitud semántica de las incrustaciones a menudo no se corresponde con lo que realmente requiere la consulta del usuario. El procesamiento de miles de tokens recuperados también genera una importante sobrecarga computacional y latencia de inferencia. Lo más problemático es que los sistemas RAG son muy sensibles al ruido. Los pasajes irrelevantes o mal recuperados a menudo degradan la respuesta final del modelo.
Métodos paramétricosal igual que la capacitación previa continua o el ajuste fino supervisado, intentan internalizar nuevos conocimientos directamente en los pesos del LLM. La actualización de LLM modernos y masivos es prohibitivamente costosa y, por lo general, imposible para los modelos propietarios de código cerrado ocultos detrás de las API. El ajuste fino también es propenso a causar olvido catastrófico. Obligar al modelo a adaptarse a nuevos datos corporativos a menudo erosiona sus capacidades de razonamiento y barreras de seguridad previamente adquiridas.
Métodos de memoria latentecomo la compresión de contexto, ofrecen un término medio. Comprimen el conocimiento en «tokens blandos» compactos o representaciones que se agregan al contexto del modelo durante la inferencia. El error fatal aquí es el «acoplamiento de representaciones». La memoria comprimida está estrictamente ligada a la arquitectura del modelo que la produjo; no se puede transferir una memoria latente entrenada en un modelo de código abierto a uno de código cerrado.
Cómo funciona Memo
El marco MeMo (Memoria como modelo) presenta una arquitectura modular que presenta dos componentes separados. El modelo MEMORY es un modelo de lenguaje pequeño entrenado específicamente para codificar nuevos conocimientos en sus parámetros. El modelo EXECUTIVE es un LLM congelado y listo para usar que funciona como motor de razonamiento. Cuando un usuario hace una pregunta, el modelo EJECUTIVO trata el modelo MEMORIA como un oráculo externo, emitiendo subconsultas específicas para recopilar hechos y sintetizarlos en una respuesta final.
El principio central de diseño que impulsa a MeMo es el concepto de «reflejos». Las reflexiones son pares de preguntas y respuestas (QA) específicos diseñados para capturar todos los ángulos posibles de un corpus de conocimiento. En lugar de obligar a la IA a procesar un corpus de documentos masivo y no estructurado durante el entrenamiento, MeMo utiliza un modelo GENERADOR para destilar el texto sin formato en miles de pares de control de calidad específicos. Luego, el modelo MEMORY se afina en este conjunto de datos para responder preguntas utilizando solo su conocimiento paramétrico sin la necesidad de leer el contexto recuperado.
En el momento de la inferencia, la interacción entre los dos modelos sigue un protocolo estructurado de tres etapas:
1. El modelo EJECUTIVO descompone la consulta compleja de un usuario en un conjunto de subpreguntas atómicas. El modelo MEMORIA responde a cada uno de forma independiente para establecer los hechos básicos.
2. Utilizando esas pistas iniciales, el modelo EJECUTIVO emite consultas de seguimiento para limitar las entidades candidatas hasta que converja con confianza en un objetivo específico.
3. Finalmente, el modelo EJECUTIVO consulta el modelo MEMORIA en busca de datos de respaldo sobre esa entidad objetivo y sintetiza los fragmentos recuperados en una respuesta coherente.
Esta arquitectura fusiona las fortalezas de los tres paradigmas de memoria de IA existentes y evita sus dificultades. Aprovecha los modelos de frontera disponibles al mantener el almacenamiento de memoria separado del razonamiento, lo que garantiza la compatibilidad con modelos API cerrados y abiertos. Internaliza el conocimiento directamente en parámetros, pero aísla las actualizaciones en un modelo de MEMORIA dedicado más pequeño para proteger el motor de razonamiento. Finalmente, crea un artefacto de memoria consultable que no está vinculado a ningún modelo específico y se puede usar con diferentes familias de LLM.
Manejar actualizaciones continuas de conocimientos.
La gestión de la memoria de una IA requiere actualizaciones continuas a medida que cambian las políticas de la empresa y se publican nuevos informes. Normalmente, actualizar los parámetros de un modelo requiere volver a entrenarlo desde cero con los datos antiguos y nuevos combinados. A medida que crece la base de conocimientos, este costo acumulativo de reentrenamiento se vuelve inmanejable.
Para manejar las actualizaciones continuas de manera eficiente, MeMo se basa en una técnica llamada «fusión de modelos». En lugar de una fase masiva de reentrenamiento conjunto, MeMo entrena un modelo MEMORY nuevo e independiente exclusivamente en los documentos recién agregados. El sistema deriva un «vector de tareas» que representa los cambios de parámetros aprendidos a partir de los datos nuevos. Luego, estas actualizaciones se fusionan matemáticamente en los pesos del modelo de MEMORIA original.
Este enfoque reduce las horas de computación necesarias para mantener el sistema actualizado y al mismo tiempo evita la interferencia que provoca un olvido catastrófico.
Esta eficiencia viene con una compensación: la fusión de modelos genera una caída de precisión del 11% al 19% en comparación con un reentrenamiento completo, según el modelo de razonamiento utilizado.
Memo en acción
Para medir la eficacia en el mundo real, el equipo de investigación evaluó MeMo comparándolo con varios puntos de referencia de la industria que requieren un razonamiento complejo y de múltiples saltos en múltiples documentos.
Los investigadores utilizaron Qwen2.5-32B-Instruct como modelo GENERADOR para destilar texto sin formato en reflejos. Para el modelo de MEMORIA principal, implementaron Qwen2.5-14B-Instruct. También validaron el enfoque en modelos de parámetros más pequeños de 1 a 2 B en diferentes arquitecturas, incluida Gemma3-1B.
Para el modelo de razonamiento EJECUTIVO, probaron tanto el Qwen2.5-32B de peso abierto como el Gemini 3 Flash propiedad de Google.
Compararon MeMo con un límite superior de «Recuperación perfecta» (donde los documentos correctos exactos se proporcionan manualmente) y varios sistemas de recuperación avanzados, incluida la búsqueda tradicional BM25, la recuperación de vectores densos y el RAG basado en gráficos de última generación (HippoRAG2). También probaron «Cartuchos», un método reciente que carga una caché KV entrenado sobre el modelo durante la inferencia.
MeMo dominó el razonamiento de documentos largos. Según los investigadores, en el punto de referencia NarrativeQA, MeMo logró una precisión del 53,58% junto con Gemini 3 Flash. HippoRAG2 alcanzó un máximo del 23,21%.
Los sistemas empresariales con frecuencia necesitan sintetizar respuestas complejas, como atravesar marcos regulatorios superpuestos escritos de forma independiente por diferentes organismos, o consolidar conocimientos a través de una base de código masiva y documentación externa. Los sistemas RAG tradicionales fallan aquí porque alcanzan los límites de la ventana de contexto y no logran conectar conceptos que abarcan cientos de páginas. MeMo tiene éxito porque esas conexiones se asignan e internalizan dentro del modelo MEMORY durante el entrenamiento. Es «como tener un Malcolm Gladwell propio que pueda conectar la historia de los Beatles con la historia de Bill Gates para argumentar sobre la naturaleza de la experiencia», dijo Solar-Lezama.
Los experimentos revelaron otra ventaja importante: actualizar el motor de razonamiento no requiere ningún reentrenamiento. Simplemente cambiar el modelo EXECUTIVE del Qwen de código abierto al Gemini 3 Flash patentado aumentó el rendimiento de MeMo en un 26,73% en NarrativeQA y un 11,90% en el punto de referencia MuSiQue. Para los profesionales, esto significa que pueden entrenar un modelo de MEMORIA de forma segura con sus datos privados y conectarlo instantáneamente a las API comerciales más recientes, actualizando continuamente la inteligencia del sistema sin incurrir en nuevos costos de capacitación.
El equipo de investigación describió la integración como que no requiere configuración adicional: «El LLM base (o ejecutivo) que los equipos ya están usando en RAG se puede configurar para consultar el modelo de memoria directamente. Estas consultas se realizan en lenguaje natural, similar a enviar una solicitud de mensaje a una API, sin necesidad de configuración adicional».
MeMo también maneja excepcionalmente bien los datos ruidosos. Cuando los investigadores inundaron deliberadamente el conjunto de datos con documentos irrelevantes (hasta el doble de información útil), el rendimiento de HippoRAG2 cayó un 11,55%. El rendimiento de MeMo se mantuvo relativamente estable, cayendo menos del 2%. Las bases de conocimiento empresarial suelen ser confusas, llenas de documentos duplicados y políticas obsoletas. Los sistemas RAG estándar luchan con este ruido, incorporando párrafos incorrectos al mensaje y provocando alucinaciones. Debido a que el modelo EXECUTIVE de MeMo interactúa con un oráculo sintetizado en lugar de con fragmentos de documentos sin procesar, sigue siendo muy robusto contra datos corporativos desorganizados.
Limitaciones y compensaciones
Para los equipos de ingeniería que buscan implementar MeMo, existen varias limitaciones clave a considerar.
A diferencia de los sistemas RAG tradicionales que indexan rápidamente documentos sin procesar en una base de datos vectorial, MeMo requiere un costo de capacitación inicial para cada nuevo corpus. El proceso de generación de datos utilizado para sintetizar las reflexiones de entrenamiento es computacionalmente costoso. Por ejemplo, el equipo observó que «generar el conjunto de datos de control de calidad de reflexión completo tomó aproximadamente 240 horas de GPU en NVIDIA H200», mientras que entrenar un modelo de MEMORIA de parámetros 14B «tomó aproximadamente 180 horas de GPU H200». Como dijo Solar-Lezama, «Reducir el coste de la formación es uno de los problemas de investigación abiertos más importantes para hacer de esta técnica un caballo de batalla».
Debido a que el modelo MEMORIA es una red neuronal de tamaño fijo, su capacidad para internalizar conocimiento está limitada por su capacidad de representación. Si bien los investigadores no alcanzaron un límite estricto durante su evaluación comparativa, plantean la hipótesis de que «los corpus suficientemente grandes o densos en información excederán lo que un modelo de MEMORIA de tamaño fijo puede comprimir y representar correctamente».
Finalmente, debido a que MeMo sintetiza respuestas a partir de la memoria paramétrica en lugar de recuperar fragmentos de texto exactos, oscurece la procedencia de la información. Esto dificulta atribuir afirmaciones específicas a documentos originales, lo que plantea un problema de cumplimiento crítico para las aplicaciones empresariales que requieren seguimientos de auditoría estrictos.
Decidir entre MeMo y RAG tradicional se reduce a una heurística de «búsqueda versus síntesis», junto con la volatilidad de los datos. Los investigadores advierten que «se preferiría el RAG tradicional cuando las respuestas se encuentran en un solo documento o cuando hay una fuente bien definida… Se preferiría MeMo cuando la tarea pasa de la búsqueda a la síntesis de una respuesta a partir de información dispersa en múltiples fragmentos». Si su corpus de conocimientos cambia rápidamente (por ejemplo, feeds diarios) y necesita citas de fuentes exactas, RAG sigue siendo la mejor opción debido al costo inicial de capacitación de MeMo. Si su corpus consiste en conocimiento de dominio generalizado que evoluciona lentamente en relación con su volumen, MeMo ofrece un razonamiento muy superior. Los equipos también pueden adoptar una arquitectura de enrutamiento híbrida en producción: enviar consultas de «búsqueda» a una base de datos vectorial estándar y consultas de «síntesis» al modelo MEMORIA.
«Mirando más allá, esperaría que los modelos de memoria se convirtieran en un componente arquitectónico estándar junto con la recuperación», dijo a VentureBeat Daniela Rus, coautora del artículo y directora del Laboratorio de Ciencias de la Computación e Inteligencia Artificial (CSAIL) del MIT, «de la misma manera que el almacenamiento en caché y la indexación son componentes estándar de cualquier sistema de datos serio en la actualidad».