








La catégorie des bases de données vectorielles subit une évolution en réponse aux besoins de l’IA agentique.
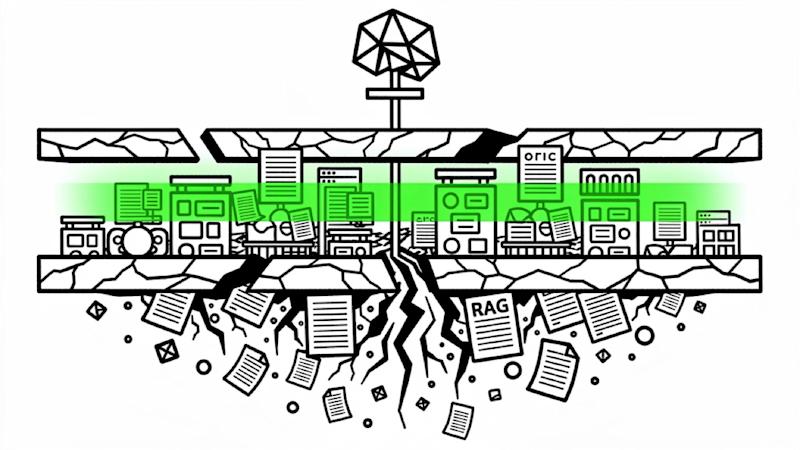
Le pipeline de base de données de génération augmentée de récupération (RAG) vers vecteur ne suffit plus ; L’IA agentique nécessite une approche différente qui intègre le contexte. Pulse du premier trimestre 2026 de VentureBeat L’enquête souligne cette tendance : chaque base de données vectorielle autonome perd sa part d’adoption, tandis que l’intention de récupération hybride a triplé pour atteindre 33,3 %, la position stratégique qui connaît la croissance la plus rapide dans l’ensemble de données.
Pinecone, pionnier des bases de données vectorielles, le reconnaît et s’adapte pour répondre aux besoins spécifiques de l’IA agentique.
La société a annoncé aujourd’hui Nexus, qu’elle positionne comme un moteur de connaissances plutôt que comme une amélioration de la récupération. Nexus introduit un compilateur de contexte qui convertit les données brutes de l’entreprise en artefacts de connaissances persistants et spécifiques à une tâche avant que les agents ne les interrogent, ainsi qu’un récupérateur composable qui sert ces artefacts avec des citations au niveau du champ et une résolution déterministe des conflits.
Aux côtés de Nexus, Pinecone publie KnowQL, un langage de requête déclaratif qui donne aux agents un vocabulaire pour spécifier la forme de sortie, les exigences de confiance et les budgets de latence. Dans le benchmark interne de Pinecone, une tâche d’analyse financière qui consommait auparavant 2,8 millions de jetons a été réalisée par Nexus avec seulement 4 000. Cela représente une réduction de 98 %, même si l’entreprise ne l’a pas encore validé dans les déploiements en production des clients. Nexus est en accès anticipé à partir d’aujourd’hui.
«RAG a été conçu pour les utilisateurs humains», a déclaré Ash Ashutosh, PDG de Pinecone, à VentureBeat. «Nexus a été conçu pour les utilisateurs agents, car leur langage est très différent. Les réponses qu’ils attendent sont très différentes. La tâche assignée à un agent est très différente de celle qu’un chatbot est censé faire.»
Pourquoi RAG n’a jamais été conçu pour ce que font réellement les agents
RAG comprend une requête, une réponse et une personne impliquée dans la boucle pour interpréter le résultat. Mais les agents travaillent différemment. Des tâches leur sont assignées, pas des questions – et pour les réaliser, il faut rassembler le contexte à partir de plusieurs sources, résoudre les conflits, suivre ce qui a déjà été récupéré et décider quoi interroger ensuite.
La distinction compte. Un pipeline RAG récupère les documents et les transmet à un modèle au moment de l’inférence. Chaque session d’agent démarre à froid, sans aucune compréhension compilée du patrimoine de données de l’entreprise : quelles tables se rapportent à lesquelles, quelles sources font autorité pour quelles questions et quels formats un agent en aval pourra réellement consommer. Chaque séance redécouvre cela à partir de zéro.
«Au cœur de tout cela se trouvait un problème très simple», a déclaré Ashutosh. «Vous demandez à des agents, des machines, de travailler sur des systèmes et des données conçus pour les humains.»
Pinecone estime que 85 % des efforts de calcul des agents sont consacrés au cycle de redécouverte plutôt qu’à l’achèvement des tâches. Les effets en aval s’aggravent : latence imprévisible, coûts de jetons incontrôlables et résultats non déterministes. Exécutez deux fois la même tâche avec les mêmes données, et un agent peut renvoyer des réponses différentes sans aucune trace des sources qui ont conduit à l’un ou l’autre résultat. Pour les entreprises où l’auditabilité est une exigence de conformité, il s’agit d’une disqualification structurelle et non d’un problème de réglage.
Qu’est-ce que Nexus et comment il fonctionne
Nexus déplace le travail de raisonnement du temps d’inférence au temps de compilation. Dans un pipeline RAG conventionnel, le raisonnement requis pour interpréter, contextualiser et structurer les connaissances se produit au moment où un agent interroge – à chaque session, à chaque fois, brûlant des jetons sur un travail qui aurait pu être effectué à l’avance. Mais Nexus raisonne une seule fois au cours d’une étape de compilation qui s’exécute avant toute requête d’agent, puis stocke le résultat en tant qu’artefact de connaissances réutilisable. L’agent reçoit un contexte structuré et prêt pour la tâche plutôt que des documents bruts à interpréter à la volée.
L’architecture fournie par Pinecone comporte trois composants distincts, chacun abordant une couche différente du problème de récupération d’agent.
-
Compilateur de contexte. Nexus utilise des données sources brutes et une spécification de tâche et crée des artefacts de connaissances spécialisés : des représentations structurées et optimisées pour les tâches que les agents consomment directement sans surcharge d’interprétation. Le même ensemble de données sous-jacentes produit différents artefacts pour différents agents : un agent commercial obtient un contexte de transaction synthétisé à partir du CRM et des enregistrements d’appels, un agent financier obtient un contexte de revenus liant les contrats aux calendriers de facturation. Les artefacts sont persistants et réutilisés entre les sessions de l’agent, et ne sont pas régénérés au moment de l’inférence.
-
Récupérateur composable. Les artefacts compilés sont servis au moment de la requête avec des champs saisis, des citations par champ avec des niveaux de confiance et une résolution déterministe des conflits. La sortie est mise en forme pour correspondre au format spécifié par l’agent plutôt que d’être renvoyée sous forme de texte brut que l’agent doit réanalyser.
-
Connaître QL. Pinecone le décrit comme le premier langage de requête déclaratif conçu pour les agents plutôt que pour les humains. Six primitives (intention, filtre, provenance, forme de sortie, confiance et budget) permettent aux agents de spécifier des réponses structurées et des enveloppes de mise à la terre et de latence des sources dans une seule interface. Ashutosh a comparé le vide structurel comblé par KnowQL à ce que SQL faisait pour les bases de données relationnelles : avant qu’une interface standard n’existe, chaque application construisait sa propre couche d’accès aux données à partir de zéro.
La relation entre Nexus et la base de données vectorielles sous-jacente de Pinecone est additive. Le compilateur de contexte produit des artefacts de connaissances qui sont indexés et stockés dans la base de données vectorielles ; la couche de compilation façonne et sert la connaissance ; la couche vectorielle gère le stockage, la vitesse de récupération et l’échelle.
«Les vecteurs sont toujours stockés et gérés par la base de données de vecteurs Pinecone», a déclaré Ashutosh.
Ce que pensent les analystes de la revendication architecturale
Déplacer le raisonnement en amont de l’inférence jusqu’à une étape de compilation n’est pas un concept nouveau : les ontologies, les catalogues de données et les couches sémantiques en ont suivi des versions pendant des années. Ce qui a changé, c’est la possibilité de le faire à grande échelle sans équipes d’ingénierie dédiées à chaque domaine. C’est l’argument spécifique avancé par Nexus, et c’est là que les analystes voient la véritable avancée.
Stephanie Walter, responsable de la pratique pour la pile d’IA chez HyperFRAME Research, a déclaré à VentureBeat que Nexus est important sur le plan directionnel car il déplace le travail de connaissances du chaos d’exécution vers une structure précompilée. Elle a toutefois souligné qu’il s’agit d’une évolution de l’architecture RAG et non d’une réinvention complète.
«La véritable innovation n’est pas l’idée elle-même, mais la production de la compilation des connaissances en tant que couche d’infrastructure de premier ordre», a déclaré Walter. «Si Pinecone peut opérationnaliser cela de manière fiable, cela deviendra une infrastructure significative, et pas seulement une autre astuce de réglage RAG.»
Le mécanisme technique derrière cette affirmation est ce que l’éminent analyste vice-président de Gartner, Arun Chandrasekaran, a appelé la distinction architecturale significative. «Contrairement au RAG traditionnel, qui repose sur une recherche sémantique pure au moment de l’exécution, la compilation architecturale intègre une logique structurelle dans la couche de métadonnées, ce qui peut accélérer le temps de réponse et fournir un meilleur raisonnement», a déclaré Chandrasekaran à VentureBeat. «Il s’agit d’un pas important entre la simple récupération et le raisonnement amélioré, permettant aux agents de naviguer dans les schémas d’entreprise et d’acquérir une meilleure mémoire pour la contextualisation.»
Le paysage concurrentiel
Plusieurs fournisseurs reconnaissent qu’une base de données vectorielle et un RAG traditionnel ne suffisent pas pour l’IA agentique.
Microsoft a étendu son Technologie FabricIQ pour fournir un contexte sémantique pour l’IA agentique. Google a récemment annoncé son Cloud de données agent comme une approche pour aider à résoudre les mêmes problèmes. Il existe également des technologies de mémoire contextuelle autonomes, comme sagesse rétrospectivequi offrent encore une autre option aux utilisateurs.
Mais unLes analystes se concentrent moins sur la comparaison des fonctionnalités que sur ce que les acheteurs devraient réellement évaluer. « La pile d’IA agentique se fragmente en des dizaines de fonctionnalités, mais les acheteurs d’entreprise ne devraient pas courir après les fonctionnalités », a déclaré Walter. «Ils devraient rechercher le contrôle : contrôle des coûts, contrôle de la gouvernance et contrôle de la sécurité.»
Selon elle, la plupart des échecs d’entreprise en matière d’IA agentique ne seront pas d’ordre technique. Ils seront opérationnels – liés aux dépassements de coûts, aux lacunes en matière de gouvernance et à la discipline en matière de sécurité.
La barre de capacités va au-delà de la vitesse de récupération. «Le véritable différenciateur est l’ancrage déterministe», a déclaré Chandrasekaran, en soulignant des techniques telles que les graphiques de connaissances qui garantissent que les agents comprennent les relations structurelles au sein des données d’entreprise plutôt que de renvoyer des correspondances au niveau de la surface. L’interopérabilité est une considération connexe : des normes telles que le protocole de contexte de modèle (MCP) sont importantes pour connecter les agents aux sources de données existantes sans créer de nouvelles dépendances.
Ce que cela signifie pour les entreprises
Les bases de données RAG et vectorielles autonomes ont été créées pour une époque différente. Les charges de travail agents exposent les limites des deux.
Le problème du coût de récupération est architectural
Les équipes exécutant des charges de travail agents complexes sur des pipelines RAG conventionnels brûlent des jetons au moment de l’inférence sur un travail qui pourrait être effectué à l’avance : interpréter, contextualiser et structurer les connaissances, à chaque session, à partir de zéro. C’est un problème de conception. Le réglage de la couche de récupération ne résoudra pas le problème. La question pour les équipes d’ingénierie de données est de savoir si leur pile actuelle est structurellement capable de précompiler des connaissances pour des tâches d’agent spécifiques, ou si elle a été conçue pour un utilisateur humain qui n’a jamais eu besoin de cette capacité.
La gouvernance est ce qui sépare un projet pilote d’un déploiement de production
Les fonctionnalités qui déterminent si l’IA agentique est approuvée pour une utilisation en entreprise ne sont pas des mesures de performances.
« La véritable proposition de valeur de l’entreprise ne réside pas seulement dans une récupération plus rapide, mais dans des pipelines de connaissances gouvernés », a déclaré Walter. «Ce sont ces capacités qui transforment l’IA agentique d’une expérience en quelque chose que les équipes financières et de gestion des risques approuveront réellement.»
Le budget a changé
Les données Pulse du premier trimestre de VentureBeat montrent que les investissements dans l’optimisation de la récupération ont atteint 28,9 % en mars, dépassant les dépenses d’évaluation pour la première fois au cours du trimestre. Les entreprises ont fini de mesurer leurs problèmes de récupération. Ils dépensent maintenant pour les réparer.
«L’avenir de l’IA agentique ne sera pas décidé par celui qui dispose de la plus longue fenêtre contextuelle», a déclaré Walter. «Il appartiendra à celui qui pourra opérationnaliser des connaissances fiables à grande échelle sans faire exploser les coûts ou la gouvernance.»


Suscríbete y recibe las historias más importantes del día.
Al suscribirte aceptas nuestros términos y condiciones y política de privacidad.