



























Imaginez que votre équipe d’ingénierie vient de déployer un agent IA pour rechercher dans les documents internes de l’entreprise et répondre aux questions des employés. Cela fonctionne parfaitement en développement, mais en production, il hallucine systématiquement ou manque des contraintes clés. Résoudre ce problème est rarement un simple correctif. Cela nécessite un processus fastidieux d’essais et d’erreurs pour peaufiner simultanément les stratégies de regroupement, les méthodes de récupération et les invites du système. Parce que ces ajustements sont intriqués, il devient presque impossible de déterminer quel ajustement spécifique a réellement résolu le problème.
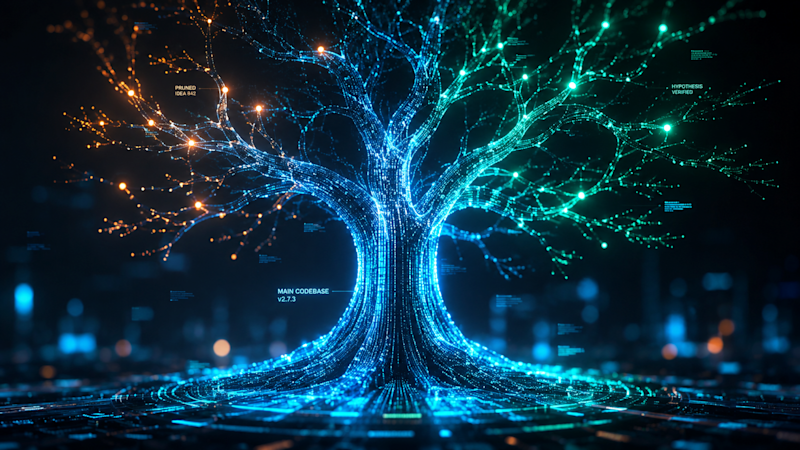
Pour relever ce défi, des chercheurs de l’Université Renmin de Chine et de Microsoft Research ont introduit Arbour, un cadre qui met à niveau la recherche et l’optimisation basées sur l’IA, passant d’une séquence d’essais et d’erreurs à un processus d’apprentissage cumulatif. Arbour organise des hypothèses, des expériences et des informations dans un arbre qui aide le système à tirer les leçons des échecs antérieurs pour apporter des améliorations plus intelligentes et vérifiées au fil du temps.
Lors de tests pratiques, Arbor a généré des gains de performances vérifiables plus de 2,5 fois supérieurs à ceux des agents de codage d’IA standard dans des tâches d’ingénierie réelles, tout en fonctionnant avec le même budget de ressources.
Pour l’IA d’entreprise, cette technique se traduit directement par l’automatisation de l’amélioration continue de systèmes d’ingénierie complexes et réels.
Comprendre le goulot d’étranglement de l’optimisation autonome
À mesure que les grands modèles de langage et les systèmes d’IA deviennent plus performants, ils devraient effectuer des opérations plus complexes telles que l’optimisation autonome (AO) de systèmes logiciels tels que les harnais d’agents ou les algorithmes de formation de modèles.
AO capture la boucle fondamentale de la recherche autonome. Un agent IA commence par un artefact mutable initial, tel qu’une base de code d’apprentissage automatique ou un pipeline de données, et un objectif spécifique. L’objectif de l’agent est d’améliorer cet artefact de manière itérative grâce à un retour d’expérience sans supervision humaine étape par étape.
Le principal défi de l’AO est souvent mal compris. De nombreuses équipes d’ingénierie estiment que le simple fait de donner plus de temps ou de calcul à un agent de codage pour optimiser une base de code ne conduit pas à de meilleurs résultats. «L’automatisation peut faire fonctionner une IA pendant très longtemps, mais une boucle n’est pas la même chose qu’un progrès», a déclaré Jiajie Jin, co-auteur de l’article, à VentureBeat. «Si l’objectif est vague ou si la métrique est facile à pirater, l’automatisation de longue durée ne fait souvent que produire des «améliorations» plus rapides que personne ne souhaite réellement.»
Jin explique que les tâches complexes nécessitent de nombreuses tentatives pour être réussies et que les architectures d’agents standard ne disposent pas de la structure de données critique pour maintenir l’état. « Comment pouvez-vous vous assurer que les connaissances et l’expérience de chaque tentative s’accumulent réellement, au lieu de se perdre dans un tampon de défilement ? » dit-il. Sans cette structure, les agents répètent simplement les mêmes erreurs.
Les systèmes d’agents actuels peuvent exécuter des expériences pendant plusieurs heures sur des objectifs bien spécifiés : modifier du code, appeler des outils, exécuter des tests de manière autonome. Mais ils traitent chaque tentative de manière isolée, manquant les mécanismes structurels qui leur permettraient d’accumuler et d’agir sur la base de ce qu’ils ont appris.
Ils n’ont pas la capacité de maintenir et de comparer simultanément plusieurs directions de recherche concurrentes. Sans cela, ils ne peuvent pas interpréter à la fois les succès et les échecs pour remodeler leur exploration future, qui est le mécanisme central qui rend la recherche humaine cumulative.
Les agents de codage général s’appuient généralement sur les transcriptions des conversations pour leur mémoire. Étant donné que les tâches AO s’étendent sur des centaines de tours et dépassent facilement les limites de la fenêtre contextuelle, ces agents ont du mal à préserver et à réutiliser les preuves factuelles sur de longues périodes. En conséquence, ils perdent la structure globale du processus de recherche et ont tendance à stagner en cas d’échecs précoces ou à courir après des oscillations d’évaluation bruyantes. Le système a besoin d’une mémoire structurée et durable qui enregistre les orientations essayées, les preuves factuelles produites et la manière dont chaque résultat modifie l’espace des hypothèses futures.
Les frameworks existants sont également susceptibles de récompenser le piratage et le surajustement des métriques de développement. Cela leur donne l’illusion d’un progrès sans produire d’améliorations transférables aux performances du monde réel.
Enfin, les agents de codage à usage général enchaînent généralement leurs appels d’outils sur une seule arborescence de travail partagée. Cette limitation architecturale les empêche de tester des hypothèses parallèles dans des environnements isolés sans corrompre la base de code principale ni masquer quelle hypothèse a provoqué un résultat spécifique.
Le cadre Arbour
Arbour résout les défis de l’AO avec un cadre qui automatise la boucle à long terme d’exploration, d’expérimentation et d’abstraction qui caractérise la recherche humaine. Arbour sépare l’orientation stratégique de la recherche des tâches de codage au niveau du terrain avec deux éléments clés :
Le coordinateur : Un agent d’IA de longue durée qui agit comme un enquêteur principal. Il ne modifie jamais directement la base de code cible. Au lieu de cela, il possède l’état général de la recherche d’optimisation, observe les preuves accumulées, propose de nouvelles hypothèses et directions à explorer et décide quoi faire des résultats des expériences.
Exécuteurs testamentaires : Agents d’IA éphémères et hautement ciblés. Lorsque le coordinateur souhaite tester une idée, il lance un exécuteur et le place dans un environnement isolé, essentiellement un nouvel arbre de travail git. Chaque exécuteur se voit remettre une hypothèse. Il met en œuvre l’idée assignée, exécute des évaluations, débogue les erreurs et rend compte au coordinateur avec les résultats et les artefacts créés.

Ces deux composants collaborent via un mécanisme que les chercheurs appellent « Hypothesis Tree Refinement » (HTR). HTR représente l’ensemble du processus de recherche comme un arbre persistant et ramifié où chaque nœud relie quatre éléments : une hypothèse, l’artefact exécutable, les preuves factuelles produites et un aperçu distillé. Cela signifie que le coordinateur peut explorer plusieurs directions concurrentes en même temps sans perdre sa place.
Le coordinateur construit l’arbre en plaçant les idées générales près de la racine, tandis que les améliorations concrètes se ramifient sous forme de feuilles. Cela permet à Arbour d’explorer simultanément et en toute sécurité plusieurs hypothèses concurrentes. Si l’expérience d’un exécuteur échoue, l’arbre enregistre la raison de son échec sous forme de contrainte négative, garantissant ainsi que le système ne répète pas sans cesse la même erreur.
Pour comprendre pourquoi l’isolement d’Arbor est important, envisagez un scénario d’entreprise courant : l’optimisation d’un pipeline de génération augmentée par récupération (RAG) pour un assistant d’IA interne. «Lorsque vous demandez à un seul agent comme Claude Code ou Codex d'»améliorer la précision», cela change généralement un tas de choses en un seul passage : le regroupement, l’invite, la méthode de récupération», a déclaré Jin. Cela enchevêtre les changements, ce qui rend impossible de déterminer lequel a réellement aidé. Il mute également directement le référentiel sans isolation.
Arbour résout ce problème en traitant chaque levier comme une hypothèse distincte. Le découpage devient une branche, la récupération une autre et l’invite une autre – chacune étant implémentée et évaluée dans son propre arbre de travail git isolé. «Vous obtenez donc une attribution claire : ‘la décomposition des contraintes du côté de la récupération a donné +X ; la recherche en largeur d’abord a fait mal'», a déclaré Jin.
Lorsqu’un exécuteur renvoie un rapport, le coordinateur écrit les preuves dans l’arborescence et rétropropage les informations vers le haut vers les nœuds parents. Cela signifie qu’une observation locale devient une contrainte généralisée qui façonne la future génération d’idées du coordinateur.
Pour empêcher le piratage des récompenses ou le surajustement des données de développement, HTR applique une « porte de fusion » stricte. Même si un exécuteur rapporte un score de développement fantastique, le coordinateur lancera un arbre de travail isolé pour tester le candidat par rapport à un évaluateur de test retenu. L’artefact n’est fusionné dans le meilleur tronc actuel que s’il améliore manifestement le score du test, vérifiant ainsi que les progrès sont réels.
Arbor relève généralement du concept d’« ingénierie de boucle », popularisé par des personnalités de l’industrie comme le créateur d’OpenClaw, Peter Steinberger, et le responsable de Claude Code, Boris Cherny. L’idée est d’aller au-delà des simples invites pour concevoir des cycles itératifs (observer, raisonner, agir, vérifier) qui pilotent les agents autonomes. Cependant, comme le souligne Jin, « une boucle peut se remplir de tentatives désordonnées et introuvables, et vous vous retrouvez sans rien à montrer ni aucun moyen de reconstruire ce qui a changé. »
Tonnelle en action
Les chercheurs ont évalué Arbor sur une suite de tâches d’optimisation autonome construite à partir de paramètres de recherche réels et du benchmark d’ingénierie d’apprentissage automatique MLE-Bench Lite. La suite AO présentait des tâches provenant de différents domaines du développement de l’IA, notamment la formation de modèles, l’ingénierie des harnais et la synthèse de données.
Les chercheurs ont utilisé différents modèles de base pour les agents coordonnateurs et exécuteurs, notamment Claude Opus 4.6, GPT-5.5 et Gemini-3-Flash. Ils ont testé Arbor contre les agents de codage les plus puissants, Codex et Claude Code. Arbor et les lignes de base ont reçu les mêmes ressources. Pour les tâches MLE-Bench Lite, Arbour a également été comparé à des systèmes de recherche agentique de premier plan tels que AI-Scientist, ML-Master et AIDE.
Arbour a constamment surperformé les lignes de base. Il a obtenu le meilleur résultat de test de tenue sur toutes les tâches, atteignant plus de 2,5 fois le gain relatif moyen du Codex et de Claude Code. Dans le cadre de la tâche BrowseComp, qui consiste à optimiser un agent de recherche, Arbour a amélioré la précision du système, passant d’une base de référence de 45,33 % à 67,67 %. Pendant ce temps, Codex et Claude Code stagnent respectivement à 50 % et 53,33 %. Sur MLE-Bench Lite, lorsqu’il est équipé de GPT-5.5, Arbor a obtenu le meilleur résultat parmi tous les systèmes de référence.

Arbor s’est avéré résistant au surajustement. Par exemple, lors des expériences de tâches Terminal-Bench 2.0, Claude Code a obtenu un score de développement élevé de 75, mais son score est tombé à 71 sur les données retenues. Arbour a obtenu un score de développement inférieur de 72,22, mais a obtenu le score le plus élevé de 77,36, garantissant ainsi le transfert de ses résultats vers des applications du monde réel.
Arbour a également montré une généralisation dans une expérience de transfert entre tâches. Une fois qu’Arbor a fini d’optimiser le faisceau de recherche pour la tâche BrowseComp, les chercheurs ont pris la base de code optimisée et l’ont testée sur deux tâches d’agent de recherche non liées, HLE et DeepSearchQA. La base de code optimisée d’Arbor a également amélioré considérablement les performances sur ces tâches invisibles.
Déploiement d’Arbor : points forts et coûts cachés
Pour les responsables de l’ingénierie qui cherchent à intégrer Arbor dans leur pile technologique existante, le cadre est conçu pour s’ajouter aux flux de travail Git existants plutôt que de les remplacer. «Sa sortie est une branche git ordinaire que votre révision de code existante, votre CI et votre révision humaine peuvent inspecter directement», a déclaré Jin. Seuls les gains vérifiés sont fusionnés dans un tronc par exécution, laissant le référentiel principal intact jusqu’à ce qu’un développeur choisisse manuellement de promouvoir le code.
Cependant, le déploiement d’Arbor s’accompagne de compromis spécifiques. Jin souligne que le plus gros problème est le coût symbolique, car le maintien d’un coordinateur de longue durée qui gère en permanence l’arbre et envoie des exécuteurs testamentaires constitue la dépense dominante. L’exécution simultanée de plusieurs arbres de travail isolés nécessite également de véritables ressources de calcul et de disque pour traiter des expériences réelles.
Alors, où est le point idéal d’Arbour ? Selon Jin, il excelle dans les tâches avec une métrique claire et fiable, une tolérance sur un horizon temporel long et un véritable espace de recherche avec plusieurs directions plausibles, telles que l’optimisation du pipeline, la qualité de la synthèse des données et le réglage des recettes de formation des modèles.
À l’inverse, les équipes doivent explicitement éviter d’utiliser Arbor pour des tâches de latence en temps réel, des correctifs évidents sur une seule ligne ou lorsque la métrique d’évaluation sous-jacente est défectueuse. Le plafond de qualité de l’ensemble du parcours est strictement limité par la qualité de l’évaluateur. «Si la métrique n’est pas fiable, Arbour optimisera simplement plus rapidement vers un résultat non fiable», a déclaré Jin.
Jin voit la prochaine évolution aller au-delà des mesures scalaires uniques. «Une évolution naturelle consiste à ce que l’artefact de chaque nœud porte un vecteur – précision, latence, coût – au lieu d’un score unique», a déclaré Jin. «Passer d’une recherche Pareto unique à une recherche Pareto multi-objectifs est une extension très naturelle du cadre.»

Imaginez que votre équipe d’ingénierie vient de déployer un agent IA pour rechercher dans les documents internes de l’entreprise et répondre aux questions des employés. Cela fonctionne parfaitement en développement, mais en production, il hallucine systématiquement ou manque des contraintes clés. Résoudre ce problème est rarement un simple correctif. Cela nécessite un processus fastidieux d’essais et d’erreurs pour peaufiner simultanément les stratégies de regroupement, les méthodes de récupération et les invites du système. Parce que ces ajustements sont intriqués, il devient presque impossible de déterminer quel ajustement spécifique a réellement résolu le problème.
Pour relever ce défi, des chercheurs de l’Université Renmin de Chine et de Microsoft Research ont introduit Arbour, un cadre qui met à niveau la recherche et l’optimisation basées sur l’IA, passant d’une séquence d’essais et d’erreurs à un processus d’apprentissage cumulatif. Arbour organise des hypothèses, des expériences et des informations dans un arbre qui aide le système à tirer les leçons des échecs antérieurs pour apporter des améliorations plus intelligentes et vérifiées au fil du temps.
Lors de tests pratiques, Arbor a généré des gains de performances vérifiables plus de 2,5 fois supérieurs à ceux des agents de codage d’IA standard dans des tâches d’ingénierie réelles, tout en fonctionnant avec le même budget de ressources.
Pour l’IA d’entreprise, cette technique se traduit directement par l’automatisation de l’amélioration continue de systèmes d’ingénierie complexes et réels.
Comprendre le goulot d’étranglement de l’optimisation autonome
À mesure que les grands modèles de langage et les systèmes d’IA deviennent plus performants, ils devraient effectuer des opérations plus complexes telles que l’optimisation autonome (AO) de systèmes logiciels tels que les harnais d’agents ou les algorithmes de formation de modèles.
AO capture la boucle fondamentale de la recherche autonome. Un agent IA commence par un artefact mutable initial, tel qu’une base de code d’apprentissage automatique ou un pipeline de données, et un objectif spécifique. L’objectif de l’agent est d’améliorer cet artefact de manière itérative grâce à un retour d’expérience sans supervision humaine étape par étape.
Le principal défi de l’AO est souvent mal compris. De nombreuses équipes d’ingénierie estiment que le simple fait de donner plus de temps ou de calcul à un agent de codage pour optimiser une base de code ne conduit pas à de meilleurs résultats. «L’automatisation peut faire fonctionner une IA pendant très longtemps, mais une boucle n’est pas la même chose qu’un progrès», a déclaré Jiajie Jin, co-auteur de l’article, à VentureBeat. «Si l’objectif est vague ou si la métrique est facile à pirater, l’automatisation de longue durée ne fait souvent que produire des «améliorations» plus rapides que personne ne souhaite réellement.»
Jin explique que les tâches complexes nécessitent de nombreuses tentatives pour être réussies et que les architectures d’agents standard ne disposent pas de la structure de données critique pour maintenir l’état. « Comment pouvez-vous vous assurer que les connaissances et l’expérience de chaque tentative s’accumulent réellement, au lieu de se perdre dans un tampon de défilement ? » dit-il. Sans cette structure, les agents répètent simplement les mêmes erreurs.
Les systèmes d’agents actuels peuvent exécuter des expériences pendant plusieurs heures sur des objectifs bien spécifiés : modifier du code, appeler des outils, exécuter des tests de manière autonome. Mais ils traitent chaque tentative de manière isolée, manquant les mécanismes structurels qui leur permettraient d’accumuler et d’agir sur la base de ce qu’ils ont appris.
Ils n’ont pas la capacité de maintenir et de comparer simultanément plusieurs directions de recherche concurrentes. Sans cela, ils ne peuvent pas interpréter à la fois les succès et les échecs pour remodeler leur exploration future, qui est le mécanisme central qui rend la recherche humaine cumulative.
Les agents de codage général s’appuient généralement sur les transcriptions des conversations pour leur mémoire. Étant donné que les tâches AO s’étendent sur des centaines de tours et dépassent facilement les limites de la fenêtre contextuelle, ces agents ont du mal à préserver et à réutiliser les preuves factuelles sur de longues périodes. En conséquence, ils perdent la structure globale du processus de recherche et ont tendance à stagner en cas d’échecs précoces ou à courir après des oscillations d’évaluation bruyantes. Le système a besoin d’une mémoire structurée et durable qui enregistre les orientations essayées, les preuves factuelles produites et la manière dont chaque résultat modifie l’espace des hypothèses futures.
Les frameworks existants sont également susceptibles de récompenser le piratage et le surajustement des métriques de développement. Cela leur donne l’illusion d’un progrès sans produire d’améliorations transférables aux performances du monde réel.
Enfin, les agents de codage à usage général enchaînent généralement leurs appels d’outils sur une seule arborescence de travail partagée. Cette limitation architecturale les empêche de tester des hypothèses parallèles dans des environnements isolés sans corrompre la base de code principale ni masquer quelle hypothèse a provoqué un résultat spécifique.
Le cadre Arbour
Arbour résout les défis de l’AO avec un cadre qui automatise la boucle à long terme d’exploration, d’expérimentation et d’abstraction qui caractérise la recherche humaine. Arbour sépare l’orientation stratégique de la recherche des tâches de codage au niveau du terrain avec deux éléments clés :
Le coordinateur : Un agent d’IA de longue durée qui agit comme un enquêteur principal. Il ne modifie jamais directement la base de code cible. Au lieu de cela, il possède l’état général de la recherche d’optimisation, observe les preuves accumulées, propose de nouvelles hypothèses et directions à explorer et décide quoi faire des résultats des expériences.
Exécuteurs testamentaires : Agents d’IA éphémères et hautement ciblés. Lorsque le coordinateur souhaite tester une idée, il lance un exécuteur et le place dans un environnement isolé, essentiellement un nouvel arbre de travail git. Chaque exécuteur se voit remettre une hypothèse. Il met en œuvre l’idée assignée, exécute des évaluations, débogue les erreurs et rend compte au coordinateur avec les résultats et les artefacts créés.
Ces deux composants collaborent via un mécanisme que les chercheurs appellent « Hypothesis Tree Refinement » (HTR). HTR représente l’ensemble du processus de recherche comme un arbre persistant et ramifié où chaque nœud relie quatre éléments : une hypothèse, l’artefact exécutable, les preuves factuelles produites et un aperçu distillé. Cela signifie que le coordinateur peut explorer plusieurs directions concurrentes en même temps sans perdre sa place.
Le coordinateur construit l’arbre en plaçant les idées générales près de la racine, tandis que les améliorations concrètes se ramifient sous forme de feuilles. Cela permet à Arbour d’explorer simultanément et en toute sécurité plusieurs hypothèses concurrentes. Si l’expérience d’un exécuteur échoue, l’arbre enregistre la raison de son échec sous forme de contrainte négative, garantissant ainsi que le système ne répète pas sans cesse la même erreur.
Pour comprendre pourquoi l’isolement d’Arbor est important, envisagez un scénario d’entreprise courant : l’optimisation d’un pipeline de génération augmentée par récupération (RAG) pour un assistant d’IA interne. «Lorsque vous demandez à un seul agent comme Claude Code ou Codex d'»améliorer la précision», cela change généralement un tas de choses en un seul passage : le regroupement, l’invite, la méthode de récupération», a déclaré Jin. Cela enchevêtre les changements, ce qui rend impossible de déterminer lequel a réellement aidé. Il mute également directement le référentiel sans isolation.
Arbour résout ce problème en traitant chaque levier comme une hypothèse distincte. Le découpage devient une branche, la récupération une autre et l’invite une autre – chacune étant implémentée et évaluée dans son propre arbre de travail git isolé. «Vous obtenez donc une attribution claire : ‘la décomposition des contraintes du côté de la récupération a donné +X ; la recherche en largeur d’abord a fait mal'», a déclaré Jin.
Lorsqu’un exécuteur renvoie un rapport, le coordinateur écrit les preuves dans l’arborescence et rétropropage les informations vers le haut vers les nœuds parents. Cela signifie qu’une observation locale devient une contrainte généralisée qui façonne la future génération d’idées du coordinateur.
Pour empêcher le piratage des récompenses ou le surajustement des données de développement, HTR applique une « porte de fusion » stricte. Même si un exécuteur rapporte un score de développement fantastique, le coordinateur lancera un arbre de travail isolé pour tester le candidat par rapport à un évaluateur de test retenu. L’artefact n’est fusionné dans le meilleur tronc actuel que s’il améliore manifestement le score du test, vérifiant ainsi que les progrès sont réels.
Arbor relève généralement du concept d’« ingénierie de boucle », popularisé par des personnalités de l’industrie comme le créateur d’OpenClaw, Peter Steinberger, et le responsable de Claude Code, Boris Cherny. L’idée est d’aller au-delà des simples invites pour concevoir des cycles itératifs (observer, raisonner, agir, vérifier) qui pilotent les agents autonomes. Cependant, comme le souligne Jin, « une boucle peut se remplir de tentatives désordonnées et introuvables, et vous vous retrouvez sans rien à montrer ni aucun moyen de reconstruire ce qui a changé. »
Tonnelle en action
Les chercheurs ont évalué Arbor sur une suite de tâches d’optimisation autonome construite à partir de paramètres de recherche réels et du benchmark d’ingénierie d’apprentissage automatique MLE-Bench Lite. La suite AO présentait des tâches provenant de différents domaines du développement de l’IA, notamment la formation de modèles, l’ingénierie des harnais et la synthèse de données.
Les chercheurs ont utilisé différents modèles de base pour les agents coordonnateurs et exécuteurs, notamment Claude Opus 4.6, GPT-5.5 et Gemini-3-Flash. Ils ont testé Arbor contre les agents de codage les plus puissants, Codex et Claude Code. Arbor et les lignes de base ont reçu les mêmes ressources. Pour les tâches MLE-Bench Lite, Arbour a également été comparé à des systèmes de recherche agentique de premier plan tels que AI-Scientist, ML-Master et AIDE.
Arbour a constamment surperformé les lignes de base. Il a obtenu le meilleur résultat de test de tenue sur toutes les tâches, atteignant plus de 2,5 fois le gain relatif moyen du Codex et de Claude Code. Dans le cadre de la tâche BrowseComp, qui consiste à optimiser un agent de recherche, Arbour a amélioré la précision du système, passant d’une base de référence de 45,33 % à 67,67 %. Pendant ce temps, Codex et Claude Code stagnent respectivement à 50 % et 53,33 %. Sur MLE-Bench Lite, lorsqu’il est équipé de GPT-5.5, Arbor a obtenu le meilleur résultat parmi tous les systèmes de référence.
Arbor s’est avéré résistant au surajustement. Par exemple, lors des expériences de tâches Terminal-Bench 2.0, Claude Code a obtenu un score de développement élevé de 75, mais son score est tombé à 71 sur les données retenues. Arbour a obtenu un score de développement inférieur de 72,22, mais a obtenu le score le plus élevé de 77,36, garantissant ainsi le transfert de ses résultats vers des applications du monde réel.
Arbour a également montré une généralisation dans une expérience de transfert entre tâches. Une fois qu’Arbor a fini d’optimiser le faisceau de recherche pour la tâche BrowseComp, les chercheurs ont pris la base de code optimisée et l’ont testée sur deux tâches d’agent de recherche non liées, HLE et DeepSearchQA. La base de code optimisée d’Arbor a également amélioré considérablement les performances sur ces tâches invisibles.
Déploiement d’Arbor : points forts et coûts cachés
Pour les responsables de l’ingénierie qui cherchent à intégrer Arbor dans leur pile technologique existante, le cadre est conçu pour s’ajouter aux flux de travail Git existants plutôt que de les remplacer. «Sa sortie est une branche git ordinaire que votre révision de code existante, votre CI et votre révision humaine peuvent inspecter directement», a déclaré Jin. Seuls les gains vérifiés sont fusionnés dans un tronc par exécution, laissant le référentiel principal intact jusqu’à ce qu’un développeur choisisse manuellement de promouvoir le code.
Cependant, le déploiement d’Arbor s’accompagne de compromis spécifiques. Jin souligne que le plus gros problème est le coût symbolique, car le maintien d’un coordinateur de longue durée qui gère en permanence l’arbre et envoie des exécuteurs testamentaires constitue la dépense dominante. L’exécution simultanée de plusieurs arbres de travail isolés nécessite également de véritables ressources de calcul et de disque pour traiter des expériences réelles.
Alors, où est le point idéal d’Arbour ? Selon Jin, il excelle dans les tâches avec une métrique claire et fiable, une tolérance sur un horizon temporel long et un véritable espace de recherche avec plusieurs directions plausibles, telles que l’optimisation du pipeline, la qualité de la synthèse des données et le réglage des recettes de formation des modèles.
À l’inverse, les équipes doivent explicitement éviter d’utiliser Arbor pour des tâches de latence en temps réel, des correctifs évidents sur une seule ligne ou lorsque la métrique d’évaluation sous-jacente est défectueuse. Le plafond de qualité de l’ensemble du parcours est strictement limité par la qualité de l’évaluateur. «Si la métrique n’est pas fiable, Arbour optimisera simplement plus rapidement vers un résultat non fiable», a déclaré Jin.
Jin voit la prochaine évolution aller au-delà des mesures scalaires uniques. «Une évolution naturelle consiste à ce que l’artefact de chaque nœud porte un vecteur – précision, latence, coût – au lieu d’un score unique», a déclaré Jin. «Passer d’une recherche Pareto unique à une recherche Pareto multi-objectifs est une extension très naturelle du cadre.»

Imaginez que votre équipe d’ingénierie vient de déployer un agent IA pour rechercher dans les documents internes de l’entreprise et répondre aux questions des employés. Cela fonctionne parfaitement en développement, mais en production, il hallucine systématiquement ou manque des contraintes clés. Résoudre ce problème est rarement un simple correctif. Cela nécessite un processus fastidieux d’essais et d’erreurs pour peaufiner simultanément les stratégies de regroupement, les méthodes de récupération et les invites du système. Parce que ces ajustements sont intriqués, il devient presque impossible de déterminer quel ajustement spécifique a réellement résolu le problème.
Pour relever ce défi, des chercheurs de l’Université Renmin de Chine et de Microsoft Research ont introduit Arbour, un cadre qui met à niveau la recherche et l’optimisation basées sur l’IA, passant d’une séquence d’essais et d’erreurs à un processus d’apprentissage cumulatif. Arbour organise des hypothèses, des expériences et des informations dans un arbre qui aide le système à tirer les leçons des échecs antérieurs pour apporter des améliorations plus intelligentes et vérifiées au fil du temps.
Lors de tests pratiques, Arbor a généré des gains de performances vérifiables plus de 2,5 fois supérieurs à ceux des agents de codage d’IA standard dans des tâches d’ingénierie réelles, tout en fonctionnant avec le même budget de ressources.
Pour l’IA d’entreprise, cette technique se traduit directement par l’automatisation de l’amélioration continue de systèmes d’ingénierie complexes et réels.
Comprendre le goulot d’étranglement de l’optimisation autonome
À mesure que les grands modèles de langage et les systèmes d’IA deviennent plus performants, ils devraient effectuer des opérations plus complexes telles que l’optimisation autonome (AO) de systèmes logiciels tels que les harnais d’agents ou les algorithmes de formation de modèles.
AO capture la boucle fondamentale de la recherche autonome. Un agent IA commence par un artefact mutable initial, tel qu’une base de code d’apprentissage automatique ou un pipeline de données, et un objectif spécifique. L’objectif de l’agent est d’améliorer cet artefact de manière itérative grâce à un retour d’expérience sans supervision humaine étape par étape.
Le principal défi de l’AO est souvent mal compris. De nombreuses équipes d’ingénierie estiment que le simple fait de donner plus de temps ou de calcul à un agent de codage pour optimiser une base de code ne conduit pas à de meilleurs résultats. «L’automatisation peut faire fonctionner une IA pendant très longtemps, mais une boucle n’est pas la même chose qu’un progrès», a déclaré Jiajie Jin, co-auteur de l’article, à VentureBeat. «Si l’objectif est vague ou si la métrique est facile à pirater, l’automatisation de longue durée ne fait souvent que produire des «améliorations» plus rapides que personne ne souhaite réellement.»
Jin explique que les tâches complexes nécessitent de nombreuses tentatives pour être réussies et que les architectures d’agents standard ne disposent pas de la structure de données critique pour maintenir l’état. « Comment pouvez-vous vous assurer que les connaissances et l’expérience de chaque tentative s’accumulent réellement, au lieu de se perdre dans un tampon de défilement ? » dit-il. Sans cette structure, les agents répètent simplement les mêmes erreurs.
Les systèmes d’agents actuels peuvent exécuter des expériences pendant plusieurs heures sur des objectifs bien spécifiés : modifier du code, appeler des outils, exécuter des tests de manière autonome. Mais ils traitent chaque tentative de manière isolée, manquant les mécanismes structurels qui leur permettraient d’accumuler et d’agir sur la base de ce qu’ils ont appris.
Ils n’ont pas la capacité de maintenir et de comparer simultanément plusieurs directions de recherche concurrentes. Sans cela, ils ne peuvent pas interpréter à la fois les succès et les échecs pour remodeler leur exploration future, qui est le mécanisme central qui rend la recherche humaine cumulative.
Les agents de codage général s’appuient généralement sur les transcriptions des conversations pour leur mémoire. Étant donné que les tâches AO s’étendent sur des centaines de tours et dépassent facilement les limites de la fenêtre contextuelle, ces agents ont du mal à préserver et à réutiliser les preuves factuelles sur de longues périodes. En conséquence, ils perdent la structure globale du processus de recherche et ont tendance à stagner en cas d’échecs précoces ou à courir après des oscillations d’évaluation bruyantes. Le système a besoin d’une mémoire structurée et durable qui enregistre les orientations essayées, les preuves factuelles produites et la manière dont chaque résultat modifie l’espace des hypothèses futures.
Les frameworks existants sont également susceptibles de récompenser le piratage et le surajustement des métriques de développement. Cela leur donne l’illusion d’un progrès sans produire d’améliorations transférables aux performances du monde réel.
Enfin, les agents de codage à usage général enchaînent généralement leurs appels d’outils sur une seule arborescence de travail partagée. Cette limitation architecturale les empêche de tester des hypothèses parallèles dans des environnements isolés sans corrompre la base de code principale ni masquer quelle hypothèse a provoqué un résultat spécifique.
Le cadre Arbour
Arbour résout les défis de l’AO avec un cadre qui automatise la boucle à long terme d’exploration, d’expérimentation et d’abstraction qui caractérise la recherche humaine. Arbour sépare l’orientation stratégique de la recherche des tâches de codage au niveau du terrain avec deux éléments clés :
Le coordinateur : Un agent d’IA de longue durée qui agit comme un enquêteur principal. Il ne modifie jamais directement la base de code cible. Au lieu de cela, il possède l’état général de la recherche d’optimisation, observe les preuves accumulées, propose de nouvelles hypothèses et directions à explorer et décide quoi faire des résultats des expériences.
Exécuteurs testamentaires : Agents d’IA éphémères et hautement ciblés. Lorsque le coordinateur souhaite tester une idée, il lance un exécuteur et le place dans un environnement isolé, essentiellement un nouvel arbre de travail git. Chaque exécuteur se voit remettre une hypothèse. Il met en œuvre l’idée assignée, exécute des évaluations, débogue les erreurs et rend compte au coordinateur avec les résultats et les artefacts créés.
Ces deux composants collaborent via un mécanisme que les chercheurs appellent « Hypothesis Tree Refinement » (HTR). HTR représente l’ensemble du processus de recherche comme un arbre persistant et ramifié où chaque nœud relie quatre éléments : une hypothèse, l’artefact exécutable, les preuves factuelles produites et un aperçu distillé. Cela signifie que le coordinateur peut explorer plusieurs directions concurrentes en même temps sans perdre sa place.
Le coordinateur construit l’arbre en plaçant les idées générales près de la racine, tandis que les améliorations concrètes se ramifient sous forme de feuilles. Cela permet à Arbour d’explorer simultanément et en toute sécurité plusieurs hypothèses concurrentes. Si l’expérience d’un exécuteur échoue, l’arbre enregistre la raison de son échec sous forme de contrainte négative, garantissant ainsi que le système ne répète pas sans cesse la même erreur.
Pour comprendre pourquoi l’isolement d’Arbor est important, envisagez un scénario d’entreprise courant : l’optimisation d’un pipeline de génération augmentée par récupération (RAG) pour un assistant d’IA interne. «Lorsque vous demandez à un seul agent comme Claude Code ou Codex d'»améliorer la précision», cela change généralement un tas de choses en un seul passage : le regroupement, l’invite, la méthode de récupération», a déclaré Jin. Cela enchevêtre les changements, ce qui rend impossible de déterminer lequel a réellement aidé. Il mute également directement le référentiel sans isolation.
Arbour résout ce problème en traitant chaque levier comme une hypothèse distincte. Le découpage devient une branche, la récupération une autre et l’invite une autre – chacune étant implémentée et évaluée dans son propre arbre de travail git isolé. «Vous obtenez donc une attribution claire : ‘la décomposition des contraintes du côté de la récupération a donné +X ; la recherche en largeur d’abord a fait mal'», a déclaré Jin.
Lorsqu’un exécuteur renvoie un rapport, le coordinateur écrit les preuves dans l’arborescence et rétropropage les informations vers le haut vers les nœuds parents. Cela signifie qu’une observation locale devient une contrainte généralisée qui façonne la future génération d’idées du coordinateur.
Pour empêcher le piratage des récompenses ou le surajustement des données de développement, HTR applique une « porte de fusion » stricte. Même si un exécuteur rapporte un score de développement fantastique, le coordinateur lancera un arbre de travail isolé pour tester le candidat par rapport à un évaluateur de test retenu. L’artefact n’est fusionné dans le meilleur tronc actuel que s’il améliore manifestement le score du test, vérifiant ainsi que les progrès sont réels.
Arbor relève généralement du concept d’« ingénierie de boucle », popularisé par des personnalités de l’industrie comme le créateur d’OpenClaw, Peter Steinberger, et le responsable de Claude Code, Boris Cherny. L’idée est d’aller au-delà des simples invites pour concevoir des cycles itératifs (observer, raisonner, agir, vérifier) qui pilotent les agents autonomes. Cependant, comme le souligne Jin, « une boucle peut se remplir de tentatives désordonnées et introuvables, et vous vous retrouvez sans rien à montrer ni aucun moyen de reconstruire ce qui a changé. »
Tonnelle en action
Les chercheurs ont évalué Arbor sur une suite de tâches d’optimisation autonome construite à partir de paramètres de recherche réels et du benchmark d’ingénierie d’apprentissage automatique MLE-Bench Lite. La suite AO présentait des tâches provenant de différents domaines du développement de l’IA, notamment la formation de modèles, l’ingénierie des harnais et la synthèse de données.
Les chercheurs ont utilisé différents modèles de base pour les agents coordonnateurs et exécuteurs, notamment Claude Opus 4.6, GPT-5.5 et Gemini-3-Flash. Ils ont testé Arbor contre les agents de codage les plus puissants, Codex et Claude Code. Arbor et les lignes de base ont reçu les mêmes ressources. Pour les tâches MLE-Bench Lite, Arbour a également été comparé à des systèmes de recherche agentique de premier plan tels que AI-Scientist, ML-Master et AIDE.
Arbour a constamment surperformé les lignes de base. Il a obtenu le meilleur résultat de test de tenue sur toutes les tâches, atteignant plus de 2,5 fois le gain relatif moyen du Codex et de Claude Code. Dans le cadre de la tâche BrowseComp, qui consiste à optimiser un agent de recherche, Arbour a amélioré la précision du système, passant d’une base de référence de 45,33 % à 67,67 %. Pendant ce temps, Codex et Claude Code stagnent respectivement à 50 % et 53,33 %. Sur MLE-Bench Lite, lorsqu’il est équipé de GPT-5.5, Arbor a obtenu le meilleur résultat parmi tous les systèmes de référence.
Arbor s’est avéré résistant au surajustement. Par exemple, lors des expériences de tâches Terminal-Bench 2.0, Claude Code a obtenu un score de développement élevé de 75, mais son score est tombé à 71 sur les données retenues. Arbour a obtenu un score de développement inférieur de 72,22, mais a obtenu le score le plus élevé de 77,36, garantissant ainsi le transfert de ses résultats vers des applications du monde réel.
Arbour a également montré une généralisation dans une expérience de transfert entre tâches. Une fois qu’Arbor a fini d’optimiser le faisceau de recherche pour la tâche BrowseComp, les chercheurs ont pris la base de code optimisée et l’ont testée sur deux tâches d’agent de recherche non liées, HLE et DeepSearchQA. La base de code optimisée d’Arbor a également amélioré considérablement les performances sur ces tâches invisibles.
Déploiement d’Arbor : points forts et coûts cachés
Pour les responsables de l’ingénierie qui cherchent à intégrer Arbor dans leur pile technologique existante, le cadre est conçu pour s’ajouter aux flux de travail Git existants plutôt que de les remplacer. «Sa sortie est une branche git ordinaire que votre révision de code existante, votre CI et votre révision humaine peuvent inspecter directement», a déclaré Jin. Seuls les gains vérifiés sont fusionnés dans un tronc par exécution, laissant le référentiel principal intact jusqu’à ce qu’un développeur choisisse manuellement de promouvoir le code.
Cependant, le déploiement d’Arbor s’accompagne de compromis spécifiques. Jin souligne que le plus gros problème est le coût symbolique, car le maintien d’un coordinateur de longue durée qui gère en permanence l’arbre et envoie des exécuteurs testamentaires constitue la dépense dominante. L’exécution simultanée de plusieurs arbres de travail isolés nécessite également de véritables ressources de calcul et de disque pour traiter des expériences réelles.
Alors, où est le point idéal d’Arbour ? Selon Jin, il excelle dans les tâches avec une métrique claire et fiable, une tolérance sur un horizon temporel long et un véritable espace de recherche avec plusieurs directions plausibles, telles que l’optimisation du pipeline, la qualité de la synthèse des données et le réglage des recettes de formation des modèles.
À l’inverse, les équipes doivent explicitement éviter d’utiliser Arbor pour des tâches de latence en temps réel, des correctifs évidents sur une seule ligne ou lorsque la métrique d’évaluation sous-jacente est défectueuse. Le plafond de qualité de l’ensemble du parcours est strictement limité par la qualité de l’évaluateur. «Si la métrique n’est pas fiable, Arbour optimisera simplement plus rapidement vers un résultat non fiable», a déclaré Jin.
Jin voit la prochaine évolution aller au-delà des mesures scalaires uniques. «Une évolution naturelle consiste à ce que l’artefact de chaque nœud porte un vecteur – précision, latence, coût – au lieu d’un score unique», a déclaré Jin. «Passer d’une recherche Pareto unique à une recherche Pareto multi-objectifs est une extension très naturelle du cadre.»
Imaginez que votre équipe d’ingénierie vient de déployer un agent IA pour rechercher dans les documents internes de l’entreprise et répondre aux questions des employés. Cela fonctionne parfaitement en développement, mais en production, il hallucine systématiquement ou manque des contraintes clés. Résoudre ce problème est rarement un simple correctif. Cela nécessite un processus fastidieux d’essais et d’erreurs pour peaufiner simultanément les stratégies de regroupement, les méthodes de récupération et les invites du système. Parce que ces ajustements sont intriqués, il devient presque impossible de déterminer quel ajustement spécifique a réellement résolu le problème.
Pour relever ce défi, des chercheurs de l’Université Renmin de Chine et de Microsoft Research ont introduit Arbour, un cadre qui met à niveau la recherche et l’optimisation basées sur l’IA, passant d’une séquence d’essais et d’erreurs à un processus d’apprentissage cumulatif. Arbour organise des hypothèses, des expériences et des informations dans un arbre qui aide le système à tirer les leçons des échecs antérieurs pour apporter des améliorations plus intelligentes et vérifiées au fil du temps.
Lors de tests pratiques, Arbor a généré des gains de performances vérifiables plus de 2,5 fois supérieurs à ceux des agents de codage d’IA standard dans des tâches d’ingénierie réelles, tout en fonctionnant avec le même budget de ressources.
Pour l’IA d’entreprise, cette technique se traduit directement par l’automatisation de l’amélioration continue de systèmes d’ingénierie complexes et réels.
Comprendre le goulot d’étranglement de l’optimisation autonome
À mesure que les grands modèles de langage et les systèmes d’IA deviennent plus performants, ils devraient effectuer des opérations plus complexes telles que l’optimisation autonome (AO) de systèmes logiciels tels que les harnais d’agents ou les algorithmes de formation de modèles.
AO capture la boucle fondamentale de la recherche autonome. Un agent IA commence par un artefact mutable initial, tel qu’une base de code d’apprentissage automatique ou un pipeline de données, et un objectif spécifique. L’objectif de l’agent est d’améliorer cet artefact de manière itérative grâce à un retour d’expérience sans supervision humaine étape par étape.
Le principal défi de l’AO est souvent mal compris. De nombreuses équipes d’ingénierie estiment que le simple fait de donner plus de temps ou de calcul à un agent de codage pour optimiser une base de code ne conduit pas à de meilleurs résultats. «L’automatisation peut faire fonctionner une IA pendant très longtemps, mais une boucle n’est pas la même chose qu’un progrès», a déclaré Jiajie Jin, co-auteur de l’article, à VentureBeat. «Si l’objectif est vague ou si la métrique est facile à pirater, l’automatisation de longue durée ne fait souvent que produire des «améliorations» plus rapides que personne ne souhaite réellement.»
Jin explique que les tâches complexes nécessitent de nombreuses tentatives pour être réussies et que les architectures d’agents standard ne disposent pas de la structure de données critique pour maintenir l’état. « Comment pouvez-vous vous assurer que les connaissances et l’expérience de chaque tentative s’accumulent réellement, au lieu de se perdre dans un tampon de défilement ? » dit-il. Sans cette structure, les agents répètent simplement les mêmes erreurs.
Les systèmes d’agents actuels peuvent exécuter des expériences pendant plusieurs heures sur des objectifs bien spécifiés : modifier du code, appeler des outils, exécuter des tests de manière autonome. Mais ils traitent chaque tentative de manière isolée, manquant les mécanismes structurels qui leur permettraient d’accumuler et d’agir sur la base de ce qu’ils ont appris.
Ils n’ont pas la capacité de maintenir et de comparer simultanément plusieurs directions de recherche concurrentes. Sans cela, ils ne peuvent pas interpréter à la fois les succès et les échecs pour remodeler leur exploration future, qui est le mécanisme central qui rend la recherche humaine cumulative.
Les agents de codage général s’appuient généralement sur les transcriptions des conversations pour leur mémoire. Étant donné que les tâches AO s’étendent sur des centaines de tours et dépassent facilement les limites de la fenêtre contextuelle, ces agents ont du mal à préserver et à réutiliser les preuves factuelles sur de longues périodes. En conséquence, ils perdent la structure globale du processus de recherche et ont tendance à stagner en cas d’échecs précoces ou à courir après des oscillations d’évaluation bruyantes. Le système a besoin d’une mémoire structurée et durable qui enregistre les orientations essayées, les preuves factuelles produites et la manière dont chaque résultat modifie l’espace des hypothèses futures.
Les frameworks existants sont également susceptibles de récompenser le piratage et le surajustement des métriques de développement. Cela leur donne l’illusion d’un progrès sans produire d’améliorations transférables aux performances du monde réel.
Enfin, les agents de codage à usage général enchaînent généralement leurs appels d’outils sur une seule arborescence de travail partagée. Cette limitation architecturale les empêche de tester des hypothèses parallèles dans des environnements isolés sans corrompre la base de code principale ni masquer quelle hypothèse a provoqué un résultat spécifique.
Le cadre Arbour
Arbour résout les défis de l’AO avec un cadre qui automatise la boucle à long terme d’exploration, d’expérimentation et d’abstraction qui caractérise la recherche humaine. Arbour sépare l’orientation stratégique de la recherche des tâches de codage au niveau du terrain avec deux éléments clés :
Le coordinateur : Un agent d’IA de longue durée qui agit comme un enquêteur principal. Il ne modifie jamais directement la base de code cible. Au lieu de cela, il possède l’état général de la recherche d’optimisation, observe les preuves accumulées, propose de nouvelles hypothèses et directions à explorer et décide quoi faire des résultats des expériences.
Exécuteurs testamentaires : Agents d’IA éphémères et hautement ciblés. Lorsque le coordinateur souhaite tester une idée, il lance un exécuteur et le place dans un environnement isolé, essentiellement un nouvel arbre de travail git. Chaque exécuteur se voit remettre une hypothèse. Il met en œuvre l’idée assignée, exécute des évaluations, débogue les erreurs et rend compte au coordinateur avec les résultats et les artefacts créés.
Ces deux composants collaborent via un mécanisme que les chercheurs appellent « Hypothesis Tree Refinement » (HTR). HTR représente l’ensemble du processus de recherche comme un arbre persistant et ramifié où chaque nœud relie quatre éléments : une hypothèse, l’artefact exécutable, les preuves factuelles produites et un aperçu distillé. Cela signifie que le coordinateur peut explorer plusieurs directions concurrentes en même temps sans perdre sa place.
Le coordinateur construit l’arbre en plaçant les idées générales près de la racine, tandis que les améliorations concrètes se ramifient sous forme de feuilles. Cela permet à Arbour d’explorer simultanément et en toute sécurité plusieurs hypothèses concurrentes. Si l’expérience d’un exécuteur échoue, l’arbre enregistre la raison de son échec sous forme de contrainte négative, garantissant ainsi que le système ne répète pas sans cesse la même erreur.
Pour comprendre pourquoi l’isolement d’Arbor est important, envisagez un scénario d’entreprise courant : l’optimisation d’un pipeline de génération augmentée par récupération (RAG) pour un assistant d’IA interne. «Lorsque vous demandez à un seul agent comme Claude Code ou Codex d'»améliorer la précision», cela change généralement un tas de choses en un seul passage : le regroupement, l’invite, la méthode de récupération», a déclaré Jin. Cela enchevêtre les changements, ce qui rend impossible de déterminer lequel a réellement aidé. Il mute également directement le référentiel sans isolation.
Arbour résout ce problème en traitant chaque levier comme une hypothèse distincte. Le découpage devient une branche, la récupération une autre et l’invite une autre – chacune étant implémentée et évaluée dans son propre arbre de travail git isolé. «Vous obtenez donc une attribution claire : ‘la décomposition des contraintes du côté de la récupération a donné +X ; la recherche en largeur d’abord a fait mal'», a déclaré Jin.
Lorsqu’un exécuteur renvoie un rapport, le coordinateur écrit les preuves dans l’arborescence et rétropropage les informations vers le haut vers les nœuds parents. Cela signifie qu’une observation locale devient une contrainte généralisée qui façonne la future génération d’idées du coordinateur.
Pour empêcher le piratage des récompenses ou le surajustement des données de développement, HTR applique une « porte de fusion » stricte. Même si un exécuteur rapporte un score de développement fantastique, le coordinateur lancera un arbre de travail isolé pour tester le candidat par rapport à un évaluateur de test retenu. L’artefact n’est fusionné dans le meilleur tronc actuel que s’il améliore manifestement le score du test, vérifiant ainsi que les progrès sont réels.
Arbor relève généralement du concept d’« ingénierie de boucle », popularisé par des personnalités de l’industrie comme le créateur d’OpenClaw, Peter Steinberger, et le responsable de Claude Code, Boris Cherny. L’idée est d’aller au-delà des simples invites pour concevoir des cycles itératifs (observer, raisonner, agir, vérifier) qui pilotent les agents autonomes. Cependant, comme le souligne Jin, « une boucle peut se remplir de tentatives désordonnées et introuvables, et vous vous retrouvez sans rien à montrer ni aucun moyen de reconstruire ce qui a changé. »
Tonnelle en action
Les chercheurs ont évalué Arbor sur une suite de tâches d’optimisation autonome construite à partir de paramètres de recherche réels et du benchmark d’ingénierie d’apprentissage automatique MLE-Bench Lite. La suite AO présentait des tâches provenant de différents domaines du développement de l’IA, notamment la formation de modèles, l’ingénierie des harnais et la synthèse de données.
Les chercheurs ont utilisé différents modèles de base pour les agents coordonnateurs et exécuteurs, notamment Claude Opus 4.6, GPT-5.5 et Gemini-3-Flash. Ils ont testé Arbor contre les agents de codage les plus puissants, Codex et Claude Code. Arbor et les lignes de base ont reçu les mêmes ressources. Pour les tâches MLE-Bench Lite, Arbour a également été comparé à des systèmes de recherche agentique de premier plan tels que AI-Scientist, ML-Master et AIDE.
Arbour a constamment surperformé les lignes de base. Il a obtenu le meilleur résultat de test de tenue sur toutes les tâches, atteignant plus de 2,5 fois le gain relatif moyen du Codex et de Claude Code. Dans le cadre de la tâche BrowseComp, qui consiste à optimiser un agent de recherche, Arbour a amélioré la précision du système, passant d’une base de référence de 45,33 % à 67,67 %. Pendant ce temps, Codex et Claude Code stagnent respectivement à 50 % et 53,33 %. Sur MLE-Bench Lite, lorsqu’il est équipé de GPT-5.5, Arbor a obtenu le meilleur résultat parmi tous les systèmes de référence.
Arbor s’est avéré résistant au surajustement. Par exemple, lors des expériences de tâches Terminal-Bench 2.0, Claude Code a obtenu un score de développement élevé de 75, mais son score est tombé à 71 sur les données retenues. Arbour a obtenu un score de développement inférieur de 72,22, mais a obtenu le score le plus élevé de 77,36, garantissant ainsi le transfert de ses résultats vers des applications du monde réel.
Arbour a également montré une généralisation dans une expérience de transfert entre tâches. Une fois qu’Arbor a fini d’optimiser le faisceau de recherche pour la tâche BrowseComp, les chercheurs ont pris la base de code optimisée et l’ont testée sur deux tâches d’agent de recherche non liées, HLE et DeepSearchQA. La base de code optimisée d’Arbor a également amélioré considérablement les performances sur ces tâches invisibles.
Déploiement d’Arbor : points forts et coûts cachés
Pour les responsables de l’ingénierie qui cherchent à intégrer Arbor dans leur pile technologique existante, le cadre est conçu pour s’ajouter aux flux de travail Git existants plutôt que de les remplacer. «Sa sortie est une branche git ordinaire que votre révision de code existante, votre CI et votre révision humaine peuvent inspecter directement», a déclaré Jin. Seuls les gains vérifiés sont fusionnés dans un tronc par exécution, laissant le référentiel principal intact jusqu’à ce qu’un développeur choisisse manuellement de promouvoir le code.
Cependant, le déploiement d’Arbor s’accompagne de compromis spécifiques. Jin souligne que le plus gros problème est le coût symbolique, car le maintien d’un coordinateur de longue durée qui gère en permanence l’arbre et envoie des exécuteurs testamentaires constitue la dépense dominante. L’exécution simultanée de plusieurs arbres de travail isolés nécessite également de véritables ressources de calcul et de disque pour traiter des expériences réelles.
Alors, où est le point idéal d’Arbour ? Selon Jin, il excelle dans les tâches avec une métrique claire et fiable, une tolérance sur un horizon temporel long et un véritable espace de recherche avec plusieurs directions plausibles, telles que l’optimisation du pipeline, la qualité de la synthèse des données et le réglage des recettes de formation des modèles.
À l’inverse, les équipes doivent explicitement éviter d’utiliser Arbor pour des tâches de latence en temps réel, des correctifs évidents sur une seule ligne ou lorsque la métrique d’évaluation sous-jacente est défectueuse. Le plafond de qualité de l’ensemble du parcours est strictement limité par la qualité de l’évaluateur. «Si la métrique n’est pas fiable, Arbour optimisera simplement plus rapidement vers un résultat non fiable», a déclaré Jin.
Jin voit la prochaine évolution aller au-delà des mesures scalaires uniques. «Une évolution naturelle consiste à ce que l’artefact de chaque nœud porte un vecteur – précision, latence, coût – au lieu d’un score unique», a déclaré Jin. «Passer d’une recherche Pareto unique à une recherche Pareto multi-objectifs est une extension très naturelle du cadre.»
Suscríbete y recibe las historias más importantes del día.
Al suscribirte aceptas nuestros términos y condiciones y política de privacidad.
Imaginez que votre équipe d’ingénierie vient de déployer un agent IA pour rechercher dans les documents internes de l’entreprise et répondre aux questions des employés. Cela fonctionne parfaitement en développement, mais en production, il hallucine systématiquement ou manque des contraintes clés. Résoudre ce problème est rarement un simple correctif. Cela nécessite un processus fastidieux d’essais et d’erreurs pour peaufiner simultanément les stratégies de regroupement, les méthodes de récupération et les invites du système. Parce que ces ajustements sont intriqués, il devient presque impossible de déterminer quel ajustement spécifique a réellement résolu le problème.
Pour relever ce défi, des chercheurs de l’Université Renmin de Chine et de Microsoft Research ont introduit Arbour, un cadre qui met à niveau la recherche et l’optimisation basées sur l’IA, passant d’une séquence d’essais et d’erreurs à un processus d’apprentissage cumulatif. Arbour organise des hypothèses, des expériences et des informations dans un arbre qui aide le système à tirer les leçons des échecs antérieurs pour apporter des améliorations plus intelligentes et vérifiées au fil du temps.
Lors de tests pratiques, Arbor a généré des gains de performances vérifiables plus de 2,5 fois supérieurs à ceux des agents de codage d’IA standard dans des tâches d’ingénierie réelles, tout en fonctionnant avec le même budget de ressources.
Pour l’IA d’entreprise, cette technique se traduit directement par l’automatisation de l’amélioration continue de systèmes d’ingénierie complexes et réels.
Comprendre le goulot d’étranglement de l’optimisation autonome
À mesure que les grands modèles de langage et les systèmes d’IA deviennent plus performants, ils devraient effectuer des opérations plus complexes telles que l’optimisation autonome (AO) de systèmes logiciels tels que les harnais d’agents ou les algorithmes de formation de modèles.
AO capture la boucle fondamentale de la recherche autonome. Un agent IA commence par un artefact mutable initial, tel qu’une base de code d’apprentissage automatique ou un pipeline de données, et un objectif spécifique. L’objectif de l’agent est d’améliorer cet artefact de manière itérative grâce à un retour d’expérience sans supervision humaine étape par étape.
Le principal défi de l’AO est souvent mal compris. De nombreuses équipes d’ingénierie estiment que le simple fait de donner plus de temps ou de calcul à un agent de codage pour optimiser une base de code ne conduit pas à de meilleurs résultats. «L’automatisation peut faire fonctionner une IA pendant très longtemps, mais une boucle n’est pas la même chose qu’un progrès», a déclaré Jiajie Jin, co-auteur de l’article, à VentureBeat. «Si l’objectif est vague ou si la métrique est facile à pirater, l’automatisation de longue durée ne fait souvent que produire des «améliorations» plus rapides que personne ne souhaite réellement.»
Jin explique que les tâches complexes nécessitent de nombreuses tentatives pour être réussies et que les architectures d’agents standard ne disposent pas de la structure de données critique pour maintenir l’état. « Comment pouvez-vous vous assurer que les connaissances et l’expérience de chaque tentative s’accumulent réellement, au lieu de se perdre dans un tampon de défilement ? » dit-il. Sans cette structure, les agents répètent simplement les mêmes erreurs.
Les systèmes d’agents actuels peuvent exécuter des expériences pendant plusieurs heures sur des objectifs bien spécifiés : modifier du code, appeler des outils, exécuter des tests de manière autonome. Mais ils traitent chaque tentative de manière isolée, manquant les mécanismes structurels qui leur permettraient d’accumuler et d’agir sur la base de ce qu’ils ont appris.
Ils n’ont pas la capacité de maintenir et de comparer simultanément plusieurs directions de recherche concurrentes. Sans cela, ils ne peuvent pas interpréter à la fois les succès et les échecs pour remodeler leur exploration future, qui est le mécanisme central qui rend la recherche humaine cumulative.
Les agents de codage général s’appuient généralement sur les transcriptions des conversations pour leur mémoire. Étant donné que les tâches AO s’étendent sur des centaines de tours et dépassent facilement les limites de la fenêtre contextuelle, ces agents ont du mal à préserver et à réutiliser les preuves factuelles sur de longues périodes. En conséquence, ils perdent la structure globale du processus de recherche et ont tendance à stagner en cas d’échecs précoces ou à courir après des oscillations d’évaluation bruyantes. Le système a besoin d’une mémoire structurée et durable qui enregistre les orientations essayées, les preuves factuelles produites et la manière dont chaque résultat modifie l’espace des hypothèses futures.
Les frameworks existants sont également susceptibles de récompenser le piratage et le surajustement des métriques de développement. Cela leur donne l’illusion d’un progrès sans produire d’améliorations transférables aux performances du monde réel.
Enfin, les agents de codage à usage général enchaînent généralement leurs appels d’outils sur une seule arborescence de travail partagée. Cette limitation architecturale les empêche de tester des hypothèses parallèles dans des environnements isolés sans corrompre la base de code principale ni masquer quelle hypothèse a provoqué un résultat spécifique.
Le cadre Arbour
Arbour résout les défis de l’AO avec un cadre qui automatise la boucle à long terme d’exploration, d’expérimentation et d’abstraction qui caractérise la recherche humaine. Arbour sépare l’orientation stratégique de la recherche des tâches de codage au niveau du terrain avec deux éléments clés :
Le coordinateur : Un agent d’IA de longue durée qui agit comme un enquêteur principal. Il ne modifie jamais directement la base de code cible. Au lieu de cela, il possède l’état général de la recherche d’optimisation, observe les preuves accumulées, propose de nouvelles hypothèses et directions à explorer et décide quoi faire des résultats des expériences.
Exécuteurs testamentaires : Agents d’IA éphémères et hautement ciblés. Lorsque le coordinateur souhaite tester une idée, il lance un exécuteur et le place dans un environnement isolé, essentiellement un nouvel arbre de travail git. Chaque exécuteur se voit remettre une hypothèse. Il met en œuvre l’idée assignée, exécute des évaluations, débogue les erreurs et rend compte au coordinateur avec les résultats et les artefacts créés.
Ces deux composants collaborent via un mécanisme que les chercheurs appellent « Hypothesis Tree Refinement » (HTR). HTR représente l’ensemble du processus de recherche comme un arbre persistant et ramifié où chaque nœud relie quatre éléments : une hypothèse, l’artefact exécutable, les preuves factuelles produites et un aperçu distillé. Cela signifie que le coordinateur peut explorer plusieurs directions concurrentes en même temps sans perdre sa place.
Le coordinateur construit l’arbre en plaçant les idées générales près de la racine, tandis que les améliorations concrètes se ramifient sous forme de feuilles. Cela permet à Arbour d’explorer simultanément et en toute sécurité plusieurs hypothèses concurrentes. Si l’expérience d’un exécuteur échoue, l’arbre enregistre la raison de son échec sous forme de contrainte négative, garantissant ainsi que le système ne répète pas sans cesse la même erreur.
Pour comprendre pourquoi l’isolement d’Arbor est important, envisagez un scénario d’entreprise courant : l’optimisation d’un pipeline de génération augmentée par récupération (RAG) pour un assistant d’IA interne. «Lorsque vous demandez à un seul agent comme Claude Code ou Codex d'»améliorer la précision», cela change généralement un tas de choses en un seul passage : le regroupement, l’invite, la méthode de récupération», a déclaré Jin. Cela enchevêtre les changements, ce qui rend impossible de déterminer lequel a réellement aidé. Il mute également directement le référentiel sans isolation.
Arbour résout ce problème en traitant chaque levier comme une hypothèse distincte. Le découpage devient une branche, la récupération une autre et l’invite une autre – chacune étant implémentée et évaluée dans son propre arbre de travail git isolé. «Vous obtenez donc une attribution claire : ‘la décomposition des contraintes du côté de la récupération a donné +X ; la recherche en largeur d’abord a fait mal'», a déclaré Jin.
Lorsqu’un exécuteur renvoie un rapport, le coordinateur écrit les preuves dans l’arborescence et rétropropage les informations vers le haut vers les nœuds parents. Cela signifie qu’une observation locale devient une contrainte généralisée qui façonne la future génération d’idées du coordinateur.
Pour empêcher le piratage des récompenses ou le surajustement des données de développement, HTR applique une « porte de fusion » stricte. Même si un exécuteur rapporte un score de développement fantastique, le coordinateur lancera un arbre de travail isolé pour tester le candidat par rapport à un évaluateur de test retenu. L’artefact n’est fusionné dans le meilleur tronc actuel que s’il améliore manifestement le score du test, vérifiant ainsi que les progrès sont réels.
Arbor relève généralement du concept d’« ingénierie de boucle », popularisé par des personnalités de l’industrie comme le créateur d’OpenClaw, Peter Steinberger, et le responsable de Claude Code, Boris Cherny. L’idée est d’aller au-delà des simples invites pour concevoir des cycles itératifs (observer, raisonner, agir, vérifier) qui pilotent les agents autonomes. Cependant, comme le souligne Jin, « une boucle peut se remplir de tentatives désordonnées et introuvables, et vous vous retrouvez sans rien à montrer ni aucun moyen de reconstruire ce qui a changé. »
Tonnelle en action
Les chercheurs ont évalué Arbor sur une suite de tâches d’optimisation autonome construite à partir de paramètres de recherche réels et du benchmark d’ingénierie d’apprentissage automatique MLE-Bench Lite. La suite AO présentait des tâches provenant de différents domaines du développement de l’IA, notamment la formation de modèles, l’ingénierie des harnais et la synthèse de données.
Les chercheurs ont utilisé différents modèles de base pour les agents coordonnateurs et exécuteurs, notamment Claude Opus 4.6, GPT-5.5 et Gemini-3-Flash. Ils ont testé Arbor contre les agents de codage les plus puissants, Codex et Claude Code. Arbor et les lignes de base ont reçu les mêmes ressources. Pour les tâches MLE-Bench Lite, Arbour a également été comparé à des systèmes de recherche agentique de premier plan tels que AI-Scientist, ML-Master et AIDE.
Arbour a constamment surperformé les lignes de base. Il a obtenu le meilleur résultat de test de tenue sur toutes les tâches, atteignant plus de 2,5 fois le gain relatif moyen du Codex et de Claude Code. Dans le cadre de la tâche BrowseComp, qui consiste à optimiser un agent de recherche, Arbour a amélioré la précision du système, passant d’une base de référence de 45,33 % à 67,67 %. Pendant ce temps, Codex et Claude Code stagnent respectivement à 50 % et 53,33 %. Sur MLE-Bench Lite, lorsqu’il est équipé de GPT-5.5, Arbor a obtenu le meilleur résultat parmi tous les systèmes de référence.
Arbor s’est avéré résistant au surajustement. Par exemple, lors des expériences de tâches Terminal-Bench 2.0, Claude Code a obtenu un score de développement élevé de 75, mais son score est tombé à 71 sur les données retenues. Arbour a obtenu un score de développement inférieur de 72,22, mais a obtenu le score le plus élevé de 77,36, garantissant ainsi le transfert de ses résultats vers des applications du monde réel.
Arbour a également montré une généralisation dans une expérience de transfert entre tâches. Une fois qu’Arbor a fini d’optimiser le faisceau de recherche pour la tâche BrowseComp, les chercheurs ont pris la base de code optimisée et l’ont testée sur deux tâches d’agent de recherche non liées, HLE et DeepSearchQA. La base de code optimisée d’Arbor a également amélioré considérablement les performances sur ces tâches invisibles.
Déploiement d’Arbor : points forts et coûts cachés
Pour les responsables de l’ingénierie qui cherchent à intégrer Arbor dans leur pile technologique existante, le cadre est conçu pour s’ajouter aux flux de travail Git existants plutôt que de les remplacer. «Sa sortie est une branche git ordinaire que votre révision de code existante, votre CI et votre révision humaine peuvent inspecter directement», a déclaré Jin. Seuls les gains vérifiés sont fusionnés dans un tronc par exécution, laissant le référentiel principal intact jusqu’à ce qu’un développeur choisisse manuellement de promouvoir le code.
Cependant, le déploiement d’Arbor s’accompagne de compromis spécifiques. Jin souligne que le plus gros problème est le coût symbolique, car le maintien d’un coordinateur de longue durée qui gère en permanence l’arbre et envoie des exécuteurs testamentaires constitue la dépense dominante. L’exécution simultanée de plusieurs arbres de travail isolés nécessite également de véritables ressources de calcul et de disque pour traiter des expériences réelles.
Alors, où est le point idéal d’Arbour ? Selon Jin, il excelle dans les tâches avec une métrique claire et fiable, une tolérance sur un horizon temporel long et un véritable espace de recherche avec plusieurs directions plausibles, telles que l’optimisation du pipeline, la qualité de la synthèse des données et le réglage des recettes de formation des modèles.
À l’inverse, les équipes doivent explicitement éviter d’utiliser Arbor pour des tâches de latence en temps réel, des correctifs évidents sur une seule ligne ou lorsque la métrique d’évaluation sous-jacente est défectueuse. Le plafond de qualité de l’ensemble du parcours est strictement limité par la qualité de l’évaluateur. «Si la métrique n’est pas fiable, Arbour optimisera simplement plus rapidement vers un résultat non fiable», a déclaré Jin.
Jin voit la prochaine évolution aller au-delà des mesures scalaires uniques. «Une évolution naturelle consiste à ce que l’artefact de chaque nœud porte un vecteur – précision, latence, coût – au lieu d’un score unique», a déclaré Jin. «Passer d’une recherche Pareto unique à une recherche Pareto multi-objectifs est une extension très naturelle du cadre.»
Imaginez que votre équipe d’ingénierie vient de déployer un agent IA pour rechercher dans les documents internes de l’entreprise et répondre aux questions des employés. Cela fonctionne parfaitement en développement, mais en production, il hallucine systématiquement ou manque des contraintes clés. Résoudre ce problème est rarement un simple correctif. Cela nécessite un processus fastidieux d’essais et d’erreurs pour peaufiner simultanément les stratégies de regroupement, les méthodes de récupération et les invites du système. Parce que ces ajustements sont intriqués, il devient presque impossible de déterminer quel ajustement spécifique a réellement résolu le problème.
Pour relever ce défi, des chercheurs de l’Université Renmin de Chine et de Microsoft Research ont introduit Arbour, un cadre qui met à niveau la recherche et l’optimisation basées sur l’IA, passant d’une séquence d’essais et d’erreurs à un processus d’apprentissage cumulatif. Arbour organise des hypothèses, des expériences et des informations dans un arbre qui aide le système à tirer les leçons des échecs antérieurs pour apporter des améliorations plus intelligentes et vérifiées au fil du temps.
Lors de tests pratiques, Arbor a généré des gains de performances vérifiables plus de 2,5 fois supérieurs à ceux des agents de codage d’IA standard dans des tâches d’ingénierie réelles, tout en fonctionnant avec le même budget de ressources.
Pour l’IA d’entreprise, cette technique se traduit directement par l’automatisation de l’amélioration continue de systèmes d’ingénierie complexes et réels.
Comprendre le goulot d’étranglement de l’optimisation autonome
À mesure que les grands modèles de langage et les systèmes d’IA deviennent plus performants, ils devraient effectuer des opérations plus complexes telles que l’optimisation autonome (AO) de systèmes logiciels tels que les harnais d’agents ou les algorithmes de formation de modèles.
AO capture la boucle fondamentale de la recherche autonome. Un agent IA commence par un artefact mutable initial, tel qu’une base de code d’apprentissage automatique ou un pipeline de données, et un objectif spécifique. L’objectif de l’agent est d’améliorer cet artefact de manière itérative grâce à un retour d’expérience sans supervision humaine étape par étape.
Le principal défi de l’AO est souvent mal compris. De nombreuses équipes d’ingénierie estiment que le simple fait de donner plus de temps ou de calcul à un agent de codage pour optimiser une base de code ne conduit pas à de meilleurs résultats. «L’automatisation peut faire fonctionner une IA pendant très longtemps, mais une boucle n’est pas la même chose qu’un progrès», a déclaré Jiajie Jin, co-auteur de l’article, à VentureBeat. «Si l’objectif est vague ou si la métrique est facile à pirater, l’automatisation de longue durée ne fait souvent que produire des «améliorations» plus rapides que personne ne souhaite réellement.»
Jin explique que les tâches complexes nécessitent de nombreuses tentatives pour être réussies et que les architectures d’agents standard ne disposent pas de la structure de données critique pour maintenir l’état. « Comment pouvez-vous vous assurer que les connaissances et l’expérience de chaque tentative s’accumulent réellement, au lieu de se perdre dans un tampon de défilement ? » dit-il. Sans cette structure, les agents répètent simplement les mêmes erreurs.
Les systèmes d’agents actuels peuvent exécuter des expériences pendant plusieurs heures sur des objectifs bien spécifiés : modifier du code, appeler des outils, exécuter des tests de manière autonome. Mais ils traitent chaque tentative de manière isolée, manquant les mécanismes structurels qui leur permettraient d’accumuler et d’agir sur la base de ce qu’ils ont appris.
Ils n’ont pas la capacité de maintenir et de comparer simultanément plusieurs directions de recherche concurrentes. Sans cela, ils ne peuvent pas interpréter à la fois les succès et les échecs pour remodeler leur exploration future, qui est le mécanisme central qui rend la recherche humaine cumulative.
Les agents de codage général s’appuient généralement sur les transcriptions des conversations pour leur mémoire. Étant donné que les tâches AO s’étendent sur des centaines de tours et dépassent facilement les limites de la fenêtre contextuelle, ces agents ont du mal à préserver et à réutiliser les preuves factuelles sur de longues périodes. En conséquence, ils perdent la structure globale du processus de recherche et ont tendance à stagner en cas d’échecs précoces ou à courir après des oscillations d’évaluation bruyantes. Le système a besoin d’une mémoire structurée et durable qui enregistre les orientations essayées, les preuves factuelles produites et la manière dont chaque résultat modifie l’espace des hypothèses futures.
Les frameworks existants sont également susceptibles de récompenser le piratage et le surajustement des métriques de développement. Cela leur donne l’illusion d’un progrès sans produire d’améliorations transférables aux performances du monde réel.
Enfin, les agents de codage à usage général enchaînent généralement leurs appels d’outils sur une seule arborescence de travail partagée. Cette limitation architecturale les empêche de tester des hypothèses parallèles dans des environnements isolés sans corrompre la base de code principale ni masquer quelle hypothèse a provoqué un résultat spécifique.
Le cadre Arbour
Arbour résout les défis de l’AO avec un cadre qui automatise la boucle à long terme d’exploration, d’expérimentation et d’abstraction qui caractérise la recherche humaine. Arbour sépare l’orientation stratégique de la recherche des tâches de codage au niveau du terrain avec deux éléments clés :
Le coordinateur : Un agent d’IA de longue durée qui agit comme un enquêteur principal. Il ne modifie jamais directement la base de code cible. Au lieu de cela, il possède l’état général de la recherche d’optimisation, observe les preuves accumulées, propose de nouvelles hypothèses et directions à explorer et décide quoi faire des résultats des expériences.
Exécuteurs testamentaires : Agents d’IA éphémères et hautement ciblés. Lorsque le coordinateur souhaite tester une idée, il lance un exécuteur et le place dans un environnement isolé, essentiellement un nouvel arbre de travail git. Chaque exécuteur se voit remettre une hypothèse. Il met en œuvre l’idée assignée, exécute des évaluations, débogue les erreurs et rend compte au coordinateur avec les résultats et les artefacts créés.
Ces deux composants collaborent via un mécanisme que les chercheurs appellent « Hypothesis Tree Refinement » (HTR). HTR représente l’ensemble du processus de recherche comme un arbre persistant et ramifié où chaque nœud relie quatre éléments : une hypothèse, l’artefact exécutable, les preuves factuelles produites et un aperçu distillé. Cela signifie que le coordinateur peut explorer plusieurs directions concurrentes en même temps sans perdre sa place.
Le coordinateur construit l’arbre en plaçant les idées générales près de la racine, tandis que les améliorations concrètes se ramifient sous forme de feuilles. Cela permet à Arbour d’explorer simultanément et en toute sécurité plusieurs hypothèses concurrentes. Si l’expérience d’un exécuteur échoue, l’arbre enregistre la raison de son échec sous forme de contrainte négative, garantissant ainsi que le système ne répète pas sans cesse la même erreur.
Pour comprendre pourquoi l’isolement d’Arbor est important, envisagez un scénario d’entreprise courant : l’optimisation d’un pipeline de génération augmentée par récupération (RAG) pour un assistant d’IA interne. «Lorsque vous demandez à un seul agent comme Claude Code ou Codex d'»améliorer la précision», cela change généralement un tas de choses en un seul passage : le regroupement, l’invite, la méthode de récupération», a déclaré Jin. Cela enchevêtre les changements, ce qui rend impossible de déterminer lequel a réellement aidé. Il mute également directement le référentiel sans isolation.
Arbour résout ce problème en traitant chaque levier comme une hypothèse distincte. Le découpage devient une branche, la récupération une autre et l’invite une autre – chacune étant implémentée et évaluée dans son propre arbre de travail git isolé. «Vous obtenez donc une attribution claire : ‘la décomposition des contraintes du côté de la récupération a donné +X ; la recherche en largeur d’abord a fait mal'», a déclaré Jin.
Lorsqu’un exécuteur renvoie un rapport, le coordinateur écrit les preuves dans l’arborescence et rétropropage les informations vers le haut vers les nœuds parents. Cela signifie qu’une observation locale devient une contrainte généralisée qui façonne la future génération d’idées du coordinateur.
Pour empêcher le piratage des récompenses ou le surajustement des données de développement, HTR applique une « porte de fusion » stricte. Même si un exécuteur rapporte un score de développement fantastique, le coordinateur lancera un arbre de travail isolé pour tester le candidat par rapport à un évaluateur de test retenu. L’artefact n’est fusionné dans le meilleur tronc actuel que s’il améliore manifestement le score du test, vérifiant ainsi que les progrès sont réels.
Arbor relève généralement du concept d’« ingénierie de boucle », popularisé par des personnalités de l’industrie comme le créateur d’OpenClaw, Peter Steinberger, et le responsable de Claude Code, Boris Cherny. L’idée est d’aller au-delà des simples invites pour concevoir des cycles itératifs (observer, raisonner, agir, vérifier) qui pilotent les agents autonomes. Cependant, comme le souligne Jin, « une boucle peut se remplir de tentatives désordonnées et introuvables, et vous vous retrouvez sans rien à montrer ni aucun moyen de reconstruire ce qui a changé. »
Tonnelle en action
Les chercheurs ont évalué Arbor sur une suite de tâches d’optimisation autonome construite à partir de paramètres de recherche réels et du benchmark d’ingénierie d’apprentissage automatique MLE-Bench Lite. La suite AO présentait des tâches provenant de différents domaines du développement de l’IA, notamment la formation de modèles, l’ingénierie des harnais et la synthèse de données.
Les chercheurs ont utilisé différents modèles de base pour les agents coordonnateurs et exécuteurs, notamment Claude Opus 4.6, GPT-5.5 et Gemini-3-Flash. Ils ont testé Arbor contre les agents de codage les plus puissants, Codex et Claude Code. Arbor et les lignes de base ont reçu les mêmes ressources. Pour les tâches MLE-Bench Lite, Arbour a également été comparé à des systèmes de recherche agentique de premier plan tels que AI-Scientist, ML-Master et AIDE.
Arbour a constamment surperformé les lignes de base. Il a obtenu le meilleur résultat de test de tenue sur toutes les tâches, atteignant plus de 2,5 fois le gain relatif moyen du Codex et de Claude Code. Dans le cadre de la tâche BrowseComp, qui consiste à optimiser un agent de recherche, Arbour a amélioré la précision du système, passant d’une base de référence de 45,33 % à 67,67 %. Pendant ce temps, Codex et Claude Code stagnent respectivement à 50 % et 53,33 %. Sur MLE-Bench Lite, lorsqu’il est équipé de GPT-5.5, Arbor a obtenu le meilleur résultat parmi tous les systèmes de référence.
Arbor s’est avéré résistant au surajustement. Par exemple, lors des expériences de tâches Terminal-Bench 2.0, Claude Code a obtenu un score de développement élevé de 75, mais son score est tombé à 71 sur les données retenues. Arbour a obtenu un score de développement inférieur de 72,22, mais a obtenu le score le plus élevé de 77,36, garantissant ainsi le transfert de ses résultats vers des applications du monde réel.
Arbour a également montré une généralisation dans une expérience de transfert entre tâches. Une fois qu’Arbor a fini d’optimiser le faisceau de recherche pour la tâche BrowseComp, les chercheurs ont pris la base de code optimisée et l’ont testée sur deux tâches d’agent de recherche non liées, HLE et DeepSearchQA. La base de code optimisée d’Arbor a également amélioré considérablement les performances sur ces tâches invisibles.
Déploiement d’Arbor : points forts et coûts cachés
Pour les responsables de l’ingénierie qui cherchent à intégrer Arbor dans leur pile technologique existante, le cadre est conçu pour s’ajouter aux flux de travail Git existants plutôt que de les remplacer. «Sa sortie est une branche git ordinaire que votre révision de code existante, votre CI et votre révision humaine peuvent inspecter directement», a déclaré Jin. Seuls les gains vérifiés sont fusionnés dans un tronc par exécution, laissant le référentiel principal intact jusqu’à ce qu’un développeur choisisse manuellement de promouvoir le code.
Cependant, le déploiement d’Arbor s’accompagne de compromis spécifiques. Jin souligne que le plus gros problème est le coût symbolique, car le maintien d’un coordinateur de longue durée qui gère en permanence l’arbre et envoie des exécuteurs testamentaires constitue la dépense dominante. L’exécution simultanée de plusieurs arbres de travail isolés nécessite également de véritables ressources de calcul et de disque pour traiter des expériences réelles.
Alors, où est le point idéal d’Arbour ? Selon Jin, il excelle dans les tâches avec une métrique claire et fiable, une tolérance sur un horizon temporel long et un véritable espace de recherche avec plusieurs directions plausibles, telles que l’optimisation du pipeline, la qualité de la synthèse des données et le réglage des recettes de formation des modèles.
À l’inverse, les équipes doivent explicitement éviter d’utiliser Arbor pour des tâches de latence en temps réel, des correctifs évidents sur une seule ligne ou lorsque la métrique d’évaluation sous-jacente est défectueuse. Le plafond de qualité de l’ensemble du parcours est strictement limité par la qualité de l’évaluateur. «Si la métrique n’est pas fiable, Arbour optimisera simplement plus rapidement vers un résultat non fiable», a déclaré Jin.
Jin voit la prochaine évolution aller au-delà des mesures scalaires uniques. «Une évolution naturelle consiste à ce que l’artefact de chaque nœud porte un vecteur – précision, latence, coût – au lieu d’un score unique», a déclaré Jin. «Passer d’une recherche Pareto unique à une recherche Pareto multi-objectifs est une extension très naturelle du cadre.»
Imaginez que votre équipe d’ingénierie vient de déployer un agent IA pour rechercher dans les documents internes de l’entreprise et répondre aux questions des employés. Cela fonctionne parfaitement en développement, mais en production, il hallucine systématiquement ou manque des contraintes clés. Résoudre ce problème est rarement un simple correctif. Cela nécessite un processus fastidieux d’essais et d’erreurs pour peaufiner simultanément les stratégies de regroupement, les méthodes de récupération et les invites du système. Parce que ces ajustements sont intriqués, il devient presque impossible de déterminer quel ajustement spécifique a réellement résolu le problème.
Pour relever ce défi, des chercheurs de l’Université Renmin de Chine et de Microsoft Research ont introduit Arbour, un cadre qui met à niveau la recherche et l’optimisation basées sur l’IA, passant d’une séquence d’essais et d’erreurs à un processus d’apprentissage cumulatif. Arbour organise des hypothèses, des expériences et des informations dans un arbre qui aide le système à tirer les leçons des échecs antérieurs pour apporter des améliorations plus intelligentes et vérifiées au fil du temps.
Lors de tests pratiques, Arbor a généré des gains de performances vérifiables plus de 2,5 fois supérieurs à ceux des agents de codage d’IA standard dans des tâches d’ingénierie réelles, tout en fonctionnant avec le même budget de ressources.
Pour l’IA d’entreprise, cette technique se traduit directement par l’automatisation de l’amélioration continue de systèmes d’ingénierie complexes et réels.
Comprendre le goulot d’étranglement de l’optimisation autonome
À mesure que les grands modèles de langage et les systèmes d’IA deviennent plus performants, ils devraient effectuer des opérations plus complexes telles que l’optimisation autonome (AO) de systèmes logiciels tels que les harnais d’agents ou les algorithmes de formation de modèles.
AO capture la boucle fondamentale de la recherche autonome. Un agent IA commence par un artefact mutable initial, tel qu’une base de code d’apprentissage automatique ou un pipeline de données, et un objectif spécifique. L’objectif de l’agent est d’améliorer cet artefact de manière itérative grâce à un retour d’expérience sans supervision humaine étape par étape.
Le principal défi de l’AO est souvent mal compris. De nombreuses équipes d’ingénierie estiment que le simple fait de donner plus de temps ou de calcul à un agent de codage pour optimiser une base de code ne conduit pas à de meilleurs résultats. «L’automatisation peut faire fonctionner une IA pendant très longtemps, mais une boucle n’est pas la même chose qu’un progrès», a déclaré Jiajie Jin, co-auteur de l’article, à VentureBeat. «Si l’objectif est vague ou si la métrique est facile à pirater, l’automatisation de longue durée ne fait souvent que produire des «améliorations» plus rapides que personne ne souhaite réellement.»
Jin explique que les tâches complexes nécessitent de nombreuses tentatives pour être réussies et que les architectures d’agents standard ne disposent pas de la structure de données critique pour maintenir l’état. « Comment pouvez-vous vous assurer que les connaissances et l’expérience de chaque tentative s’accumulent réellement, au lieu de se perdre dans un tampon de défilement ? » dit-il. Sans cette structure, les agents répètent simplement les mêmes erreurs.
Les systèmes d’agents actuels peuvent exécuter des expériences pendant plusieurs heures sur des objectifs bien spécifiés : modifier du code, appeler des outils, exécuter des tests de manière autonome. Mais ils traitent chaque tentative de manière isolée, manquant les mécanismes structurels qui leur permettraient d’accumuler et d’agir sur la base de ce qu’ils ont appris.
Ils n’ont pas la capacité de maintenir et de comparer simultanément plusieurs directions de recherche concurrentes. Sans cela, ils ne peuvent pas interpréter à la fois les succès et les échecs pour remodeler leur exploration future, qui est le mécanisme central qui rend la recherche humaine cumulative.
Les agents de codage général s’appuient généralement sur les transcriptions des conversations pour leur mémoire. Étant donné que les tâches AO s’étendent sur des centaines de tours et dépassent facilement les limites de la fenêtre contextuelle, ces agents ont du mal à préserver et à réutiliser les preuves factuelles sur de longues périodes. En conséquence, ils perdent la structure globale du processus de recherche et ont tendance à stagner en cas d’échecs précoces ou à courir après des oscillations d’évaluation bruyantes. Le système a besoin d’une mémoire structurée et durable qui enregistre les orientations essayées, les preuves factuelles produites et la manière dont chaque résultat modifie l’espace des hypothèses futures.
Les frameworks existants sont également susceptibles de récompenser le piratage et le surajustement des métriques de développement. Cela leur donne l’illusion d’un progrès sans produire d’améliorations transférables aux performances du monde réel.
Enfin, les agents de codage à usage général enchaînent généralement leurs appels d’outils sur une seule arborescence de travail partagée. Cette limitation architecturale les empêche de tester des hypothèses parallèles dans des environnements isolés sans corrompre la base de code principale ni masquer quelle hypothèse a provoqué un résultat spécifique.
Le cadre Arbour
Arbour résout les défis de l’AO avec un cadre qui automatise la boucle à long terme d’exploration, d’expérimentation et d’abstraction qui caractérise la recherche humaine. Arbour sépare l’orientation stratégique de la recherche des tâches de codage au niveau du terrain avec deux éléments clés :
Le coordinateur : Un agent d’IA de longue durée qui agit comme un enquêteur principal. Il ne modifie jamais directement la base de code cible. Au lieu de cela, il possède l’état général de la recherche d’optimisation, observe les preuves accumulées, propose de nouvelles hypothèses et directions à explorer et décide quoi faire des résultats des expériences.
Exécuteurs testamentaires : Agents d’IA éphémères et hautement ciblés. Lorsque le coordinateur souhaite tester une idée, il lance un exécuteur et le place dans un environnement isolé, essentiellement un nouvel arbre de travail git. Chaque exécuteur se voit remettre une hypothèse. Il met en œuvre l’idée assignée, exécute des évaluations, débogue les erreurs et rend compte au coordinateur avec les résultats et les artefacts créés.
Ces deux composants collaborent via un mécanisme que les chercheurs appellent « Hypothesis Tree Refinement » (HTR). HTR représente l’ensemble du processus de recherche comme un arbre persistant et ramifié où chaque nœud relie quatre éléments : une hypothèse, l’artefact exécutable, les preuves factuelles produites et un aperçu distillé. Cela signifie que le coordinateur peut explorer plusieurs directions concurrentes en même temps sans perdre sa place.
Le coordinateur construit l’arbre en plaçant les idées générales près de la racine, tandis que les améliorations concrètes se ramifient sous forme de feuilles. Cela permet à Arbour d’explorer simultanément et en toute sécurité plusieurs hypothèses concurrentes. Si l’expérience d’un exécuteur échoue, l’arbre enregistre la raison de son échec sous forme de contrainte négative, garantissant ainsi que le système ne répète pas sans cesse la même erreur.
Pour comprendre pourquoi l’isolement d’Arbor est important, envisagez un scénario d’entreprise courant : l’optimisation d’un pipeline de génération augmentée par récupération (RAG) pour un assistant d’IA interne. «Lorsque vous demandez à un seul agent comme Claude Code ou Codex d'»améliorer la précision», cela change généralement un tas de choses en un seul passage : le regroupement, l’invite, la méthode de récupération», a déclaré Jin. Cela enchevêtre les changements, ce qui rend impossible de déterminer lequel a réellement aidé. Il mute également directement le référentiel sans isolation.
Arbour résout ce problème en traitant chaque levier comme une hypothèse distincte. Le découpage devient une branche, la récupération une autre et l’invite une autre – chacune étant implémentée et évaluée dans son propre arbre de travail git isolé. «Vous obtenez donc une attribution claire : ‘la décomposition des contraintes du côté de la récupération a donné +X ; la recherche en largeur d’abord a fait mal'», a déclaré Jin.
Lorsqu’un exécuteur renvoie un rapport, le coordinateur écrit les preuves dans l’arborescence et rétropropage les informations vers le haut vers les nœuds parents. Cela signifie qu’une observation locale devient une contrainte généralisée qui façonne la future génération d’idées du coordinateur.
Pour empêcher le piratage des récompenses ou le surajustement des données de développement, HTR applique une « porte de fusion » stricte. Même si un exécuteur rapporte un score de développement fantastique, le coordinateur lancera un arbre de travail isolé pour tester le candidat par rapport à un évaluateur de test retenu. L’artefact n’est fusionné dans le meilleur tronc actuel que s’il améliore manifestement le score du test, vérifiant ainsi que les progrès sont réels.
Arbor relève généralement du concept d’« ingénierie de boucle », popularisé par des personnalités de l’industrie comme le créateur d’OpenClaw, Peter Steinberger, et le responsable de Claude Code, Boris Cherny. L’idée est d’aller au-delà des simples invites pour concevoir des cycles itératifs (observer, raisonner, agir, vérifier) qui pilotent les agents autonomes. Cependant, comme le souligne Jin, « une boucle peut se remplir de tentatives désordonnées et introuvables, et vous vous retrouvez sans rien à montrer ni aucun moyen de reconstruire ce qui a changé. »
Tonnelle en action
Les chercheurs ont évalué Arbor sur une suite de tâches d’optimisation autonome construite à partir de paramètres de recherche réels et du benchmark d’ingénierie d’apprentissage automatique MLE-Bench Lite. La suite AO présentait des tâches provenant de différents domaines du développement de l’IA, notamment la formation de modèles, l’ingénierie des harnais et la synthèse de données.
Les chercheurs ont utilisé différents modèles de base pour les agents coordonnateurs et exécuteurs, notamment Claude Opus 4.6, GPT-5.5 et Gemini-3-Flash. Ils ont testé Arbor contre les agents de codage les plus puissants, Codex et Claude Code. Arbor et les lignes de base ont reçu les mêmes ressources. Pour les tâches MLE-Bench Lite, Arbour a également été comparé à des systèmes de recherche agentique de premier plan tels que AI-Scientist, ML-Master et AIDE.
Arbour a constamment surperformé les lignes de base. Il a obtenu le meilleur résultat de test de tenue sur toutes les tâches, atteignant plus de 2,5 fois le gain relatif moyen du Codex et de Claude Code. Dans le cadre de la tâche BrowseComp, qui consiste à optimiser un agent de recherche, Arbour a amélioré la précision du système, passant d’une base de référence de 45,33 % à 67,67 %. Pendant ce temps, Codex et Claude Code stagnent respectivement à 50 % et 53,33 %. Sur MLE-Bench Lite, lorsqu’il est équipé de GPT-5.5, Arbor a obtenu le meilleur résultat parmi tous les systèmes de référence.
Arbor s’est avéré résistant au surajustement. Par exemple, lors des expériences de tâches Terminal-Bench 2.0, Claude Code a obtenu un score de développement élevé de 75, mais son score est tombé à 71 sur les données retenues. Arbour a obtenu un score de développement inférieur de 72,22, mais a obtenu le score le plus élevé de 77,36, garantissant ainsi le transfert de ses résultats vers des applications du monde réel.
Arbour a également montré une généralisation dans une expérience de transfert entre tâches. Une fois qu’Arbor a fini d’optimiser le faisceau de recherche pour la tâche BrowseComp, les chercheurs ont pris la base de code optimisée et l’ont testée sur deux tâches d’agent de recherche non liées, HLE et DeepSearchQA. La base de code optimisée d’Arbor a également amélioré considérablement les performances sur ces tâches invisibles.
Déploiement d’Arbor : points forts et coûts cachés
Pour les responsables de l’ingénierie qui cherchent à intégrer Arbor dans leur pile technologique existante, le cadre est conçu pour s’ajouter aux flux de travail Git existants plutôt que de les remplacer. «Sa sortie est une branche git ordinaire que votre révision de code existante, votre CI et votre révision humaine peuvent inspecter directement», a déclaré Jin. Seuls les gains vérifiés sont fusionnés dans un tronc par exécution, laissant le référentiel principal intact jusqu’à ce qu’un développeur choisisse manuellement de promouvoir le code.
Cependant, le déploiement d’Arbor s’accompagne de compromis spécifiques. Jin souligne que le plus gros problème est le coût symbolique, car le maintien d’un coordinateur de longue durée qui gère en permanence l’arbre et envoie des exécuteurs testamentaires constitue la dépense dominante. L’exécution simultanée de plusieurs arbres de travail isolés nécessite également de véritables ressources de calcul et de disque pour traiter des expériences réelles.
Alors, où est le point idéal d’Arbour ? Selon Jin, il excelle dans les tâches avec une métrique claire et fiable, une tolérance sur un horizon temporel long et un véritable espace de recherche avec plusieurs directions plausibles, telles que l’optimisation du pipeline, la qualité de la synthèse des données et le réglage des recettes de formation des modèles.
À l’inverse, les équipes doivent explicitement éviter d’utiliser Arbor pour des tâches de latence en temps réel, des correctifs évidents sur une seule ligne ou lorsque la métrique d’évaluation sous-jacente est défectueuse. Le plafond de qualité de l’ensemble du parcours est strictement limité par la qualité de l’évaluateur. «Si la métrique n’est pas fiable, Arbour optimisera simplement plus rapidement vers un résultat non fiable», a déclaré Jin.
Jin voit la prochaine évolution aller au-delà des mesures scalaires uniques. «Une évolution naturelle consiste à ce que l’artefact de chaque nœud porte un vecteur – précision, latence, coût – au lieu d’un score unique», a déclaré Jin. «Passer d’une recherche Pareto unique à une recherche Pareto multi-objectifs est une extension très naturelle du cadre.»
Imaginez que votre équipe d’ingénierie vient de déployer un agent IA pour rechercher dans les documents internes de l’entreprise et répondre aux questions des employés. Cela fonctionne parfaitement en développement, mais en production, il hallucine systématiquement ou manque des contraintes clés. Résoudre ce problème est rarement un simple correctif. Cela nécessite un processus fastidieux d’essais et d’erreurs pour peaufiner simultanément les stratégies de regroupement, les méthodes de récupération et les invites du système. Parce que ces ajustements sont intriqués, il devient presque impossible de déterminer quel ajustement spécifique a réellement résolu le problème.
Pour relever ce défi, des chercheurs de l’Université Renmin de Chine et de Microsoft Research ont introduit Arbour, un cadre qui met à niveau la recherche et l’optimisation basées sur l’IA, passant d’une séquence d’essais et d’erreurs à un processus d’apprentissage cumulatif. Arbour organise des hypothèses, des expériences et des informations dans un arbre qui aide le système à tirer les leçons des échecs antérieurs pour apporter des améliorations plus intelligentes et vérifiées au fil du temps.
Lors de tests pratiques, Arbor a généré des gains de performances vérifiables plus de 2,5 fois supérieurs à ceux des agents de codage d’IA standard dans des tâches d’ingénierie réelles, tout en fonctionnant avec le même budget de ressources.
Pour l’IA d’entreprise, cette technique se traduit directement par l’automatisation de l’amélioration continue de systèmes d’ingénierie complexes et réels.
Comprendre le goulot d’étranglement de l’optimisation autonome
À mesure que les grands modèles de langage et les systèmes d’IA deviennent plus performants, ils devraient effectuer des opérations plus complexes telles que l’optimisation autonome (AO) de systèmes logiciels tels que les harnais d’agents ou les algorithmes de formation de modèles.
AO capture la boucle fondamentale de la recherche autonome. Un agent IA commence par un artefact mutable initial, tel qu’une base de code d’apprentissage automatique ou un pipeline de données, et un objectif spécifique. L’objectif de l’agent est d’améliorer cet artefact de manière itérative grâce à un retour d’expérience sans supervision humaine étape par étape.
Le principal défi de l’AO est souvent mal compris. De nombreuses équipes d’ingénierie estiment que le simple fait de donner plus de temps ou de calcul à un agent de codage pour optimiser une base de code ne conduit pas à de meilleurs résultats. «L’automatisation peut faire fonctionner une IA pendant très longtemps, mais une boucle n’est pas la même chose qu’un progrès», a déclaré Jiajie Jin, co-auteur de l’article, à VentureBeat. «Si l’objectif est vague ou si la métrique est facile à pirater, l’automatisation de longue durée ne fait souvent que produire des «améliorations» plus rapides que personne ne souhaite réellement.»
Jin explique que les tâches complexes nécessitent de nombreuses tentatives pour être réussies et que les architectures d’agents standard ne disposent pas de la structure de données critique pour maintenir l’état. « Comment pouvez-vous vous assurer que les connaissances et l’expérience de chaque tentative s’accumulent réellement, au lieu de se perdre dans un tampon de défilement ? » dit-il. Sans cette structure, les agents répètent simplement les mêmes erreurs.
Les systèmes d’agents actuels peuvent exécuter des expériences pendant plusieurs heures sur des objectifs bien spécifiés : modifier du code, appeler des outils, exécuter des tests de manière autonome. Mais ils traitent chaque tentative de manière isolée, manquant les mécanismes structurels qui leur permettraient d’accumuler et d’agir sur la base de ce qu’ils ont appris.
Ils n’ont pas la capacité de maintenir et de comparer simultanément plusieurs directions de recherche concurrentes. Sans cela, ils ne peuvent pas interpréter à la fois les succès et les échecs pour remodeler leur exploration future, qui est le mécanisme central qui rend la recherche humaine cumulative.
Les agents de codage général s’appuient généralement sur les transcriptions des conversations pour leur mémoire. Étant donné que les tâches AO s’étendent sur des centaines de tours et dépassent facilement les limites de la fenêtre contextuelle, ces agents ont du mal à préserver et à réutiliser les preuves factuelles sur de longues périodes. En conséquence, ils perdent la structure globale du processus de recherche et ont tendance à stagner en cas d’échecs précoces ou à courir après des oscillations d’évaluation bruyantes. Le système a besoin d’une mémoire structurée et durable qui enregistre les orientations essayées, les preuves factuelles produites et la manière dont chaque résultat modifie l’espace des hypothèses futures.
Les frameworks existants sont également susceptibles de récompenser le piratage et le surajustement des métriques de développement. Cela leur donne l’illusion d’un progrès sans produire d’améliorations transférables aux performances du monde réel.
Enfin, les agents de codage à usage général enchaînent généralement leurs appels d’outils sur une seule arborescence de travail partagée. Cette limitation architecturale les empêche de tester des hypothèses parallèles dans des environnements isolés sans corrompre la base de code principale ni masquer quelle hypothèse a provoqué un résultat spécifique.
Le cadre Arbour
Arbour résout les défis de l’AO avec un cadre qui automatise la boucle à long terme d’exploration, d’expérimentation et d’abstraction qui caractérise la recherche humaine. Arbour sépare l’orientation stratégique de la recherche des tâches de codage au niveau du terrain avec deux éléments clés :
Le coordinateur : Un agent d’IA de longue durée qui agit comme un enquêteur principal. Il ne modifie jamais directement la base de code cible. Au lieu de cela, il possède l’état général de la recherche d’optimisation, observe les preuves accumulées, propose de nouvelles hypothèses et directions à explorer et décide quoi faire des résultats des expériences.
Exécuteurs testamentaires : Agents d’IA éphémères et hautement ciblés. Lorsque le coordinateur souhaite tester une idée, il lance un exécuteur et le place dans un environnement isolé, essentiellement un nouvel arbre de travail git. Chaque exécuteur se voit remettre une hypothèse. Il met en œuvre l’idée assignée, exécute des évaluations, débogue les erreurs et rend compte au coordinateur avec les résultats et les artefacts créés.
Ces deux composants collaborent via un mécanisme que les chercheurs appellent « Hypothesis Tree Refinement » (HTR). HTR représente l’ensemble du processus de recherche comme un arbre persistant et ramifié où chaque nœud relie quatre éléments : une hypothèse, l’artefact exécutable, les preuves factuelles produites et un aperçu distillé. Cela signifie que le coordinateur peut explorer plusieurs directions concurrentes en même temps sans perdre sa place.
Le coordinateur construit l’arbre en plaçant les idées générales près de la racine, tandis que les améliorations concrètes se ramifient sous forme de feuilles. Cela permet à Arbour d’explorer simultanément et en toute sécurité plusieurs hypothèses concurrentes. Si l’expérience d’un exécuteur échoue, l’arbre enregistre la raison de son échec sous forme de contrainte négative, garantissant ainsi que le système ne répète pas sans cesse la même erreur.
Pour comprendre pourquoi l’isolement d’Arbor est important, envisagez un scénario d’entreprise courant : l’optimisation d’un pipeline de génération augmentée par récupération (RAG) pour un assistant d’IA interne. «Lorsque vous demandez à un seul agent comme Claude Code ou Codex d'»améliorer la précision», cela change généralement un tas de choses en un seul passage : le regroupement, l’invite, la méthode de récupération», a déclaré Jin. Cela enchevêtre les changements, ce qui rend impossible de déterminer lequel a réellement aidé. Il mute également directement le référentiel sans isolation.
Arbour résout ce problème en traitant chaque levier comme une hypothèse distincte. Le découpage devient une branche, la récupération une autre et l’invite une autre – chacune étant implémentée et évaluée dans son propre arbre de travail git isolé. «Vous obtenez donc une attribution claire : ‘la décomposition des contraintes du côté de la récupération a donné +X ; la recherche en largeur d’abord a fait mal'», a déclaré Jin.
Lorsqu’un exécuteur renvoie un rapport, le coordinateur écrit les preuves dans l’arborescence et rétropropage les informations vers le haut vers les nœuds parents. Cela signifie qu’une observation locale devient une contrainte généralisée qui façonne la future génération d’idées du coordinateur.
Pour empêcher le piratage des récompenses ou le surajustement des données de développement, HTR applique une « porte de fusion » stricte. Même si un exécuteur rapporte un score de développement fantastique, le coordinateur lancera un arbre de travail isolé pour tester le candidat par rapport à un évaluateur de test retenu. L’artefact n’est fusionné dans le meilleur tronc actuel que s’il améliore manifestement le score du test, vérifiant ainsi que les progrès sont réels.
Arbor relève généralement du concept d’« ingénierie de boucle », popularisé par des personnalités de l’industrie comme le créateur d’OpenClaw, Peter Steinberger, et le responsable de Claude Code, Boris Cherny. L’idée est d’aller au-delà des simples invites pour concevoir des cycles itératifs (observer, raisonner, agir, vérifier) qui pilotent les agents autonomes. Cependant, comme le souligne Jin, « une boucle peut se remplir de tentatives désordonnées et introuvables, et vous vous retrouvez sans rien à montrer ni aucun moyen de reconstruire ce qui a changé. »
Tonnelle en action
Les chercheurs ont évalué Arbor sur une suite de tâches d’optimisation autonome construite à partir de paramètres de recherche réels et du benchmark d’ingénierie d’apprentissage automatique MLE-Bench Lite. La suite AO présentait des tâches provenant de différents domaines du développement de l’IA, notamment la formation de modèles, l’ingénierie des harnais et la synthèse de données.
Les chercheurs ont utilisé différents modèles de base pour les agents coordonnateurs et exécuteurs, notamment Claude Opus 4.6, GPT-5.5 et Gemini-3-Flash. Ils ont testé Arbor contre les agents de codage les plus puissants, Codex et Claude Code. Arbor et les lignes de base ont reçu les mêmes ressources. Pour les tâches MLE-Bench Lite, Arbour a également été comparé à des systèmes de recherche agentique de premier plan tels que AI-Scientist, ML-Master et AIDE.
Arbour a constamment surperformé les lignes de base. Il a obtenu le meilleur résultat de test de tenue sur toutes les tâches, atteignant plus de 2,5 fois le gain relatif moyen du Codex et de Claude Code. Dans le cadre de la tâche BrowseComp, qui consiste à optimiser un agent de recherche, Arbour a amélioré la précision du système, passant d’une base de référence de 45,33 % à 67,67 %. Pendant ce temps, Codex et Claude Code stagnent respectivement à 50 % et 53,33 %. Sur MLE-Bench Lite, lorsqu’il est équipé de GPT-5.5, Arbor a obtenu le meilleur résultat parmi tous les systèmes de référence.
Arbor s’est avéré résistant au surajustement. Par exemple, lors des expériences de tâches Terminal-Bench 2.0, Claude Code a obtenu un score de développement élevé de 75, mais son score est tombé à 71 sur les données retenues. Arbour a obtenu un score de développement inférieur de 72,22, mais a obtenu le score le plus élevé de 77,36, garantissant ainsi le transfert de ses résultats vers des applications du monde réel.
Arbour a également montré une généralisation dans une expérience de transfert entre tâches. Une fois qu’Arbor a fini d’optimiser le faisceau de recherche pour la tâche BrowseComp, les chercheurs ont pris la base de code optimisée et l’ont testée sur deux tâches d’agent de recherche non liées, HLE et DeepSearchQA. La base de code optimisée d’Arbor a également amélioré considérablement les performances sur ces tâches invisibles.
Déploiement d’Arbor : points forts et coûts cachés
Pour les responsables de l’ingénierie qui cherchent à intégrer Arbor dans leur pile technologique existante, le cadre est conçu pour s’ajouter aux flux de travail Git existants plutôt que de les remplacer. «Sa sortie est une branche git ordinaire que votre révision de code existante, votre CI et votre révision humaine peuvent inspecter directement», a déclaré Jin. Seuls les gains vérifiés sont fusionnés dans un tronc par exécution, laissant le référentiel principal intact jusqu’à ce qu’un développeur choisisse manuellement de promouvoir le code.
Cependant, le déploiement d’Arbor s’accompagne de compromis spécifiques. Jin souligne que le plus gros problème est le coût symbolique, car le maintien d’un coordinateur de longue durée qui gère en permanence l’arbre et envoie des exécuteurs testamentaires constitue la dépense dominante. L’exécution simultanée de plusieurs arbres de travail isolés nécessite également de véritables ressources de calcul et de disque pour traiter des expériences réelles.
Alors, où est le point idéal d’Arbour ? Selon Jin, il excelle dans les tâches avec une métrique claire et fiable, une tolérance sur un horizon temporel long et un véritable espace de recherche avec plusieurs directions plausibles, telles que l’optimisation du pipeline, la qualité de la synthèse des données et le réglage des recettes de formation des modèles.
À l’inverse, les équipes doivent explicitement éviter d’utiliser Arbor pour des tâches de latence en temps réel, des correctifs évidents sur une seule ligne ou lorsque la métrique d’évaluation sous-jacente est défectueuse. Le plafond de qualité de l’ensemble du parcours est strictement limité par la qualité de l’évaluateur. «Si la métrique n’est pas fiable, Arbour optimisera simplement plus rapidement vers un résultat non fiable», a déclaré Jin.
Jin voit la prochaine évolution aller au-delà des mesures scalaires uniques. «Une évolution naturelle consiste à ce que l’artefact de chaque nœud porte un vecteur – précision, latence, coût – au lieu d’un score unique», a déclaré Jin. «Passer d’une recherche Pareto unique à une recherche Pareto multi-objectifs est une extension très naturelle du cadre.»