








Permettre aux LLM d’acquérir de nouvelles connaissances après la formation reste un obstacle majeur pour l’IA d’entreprise : les solutions actuelles sont soit trop coûteuses, soit trop lentes, soit limitées par les limites de la fenêtre contextuelle.
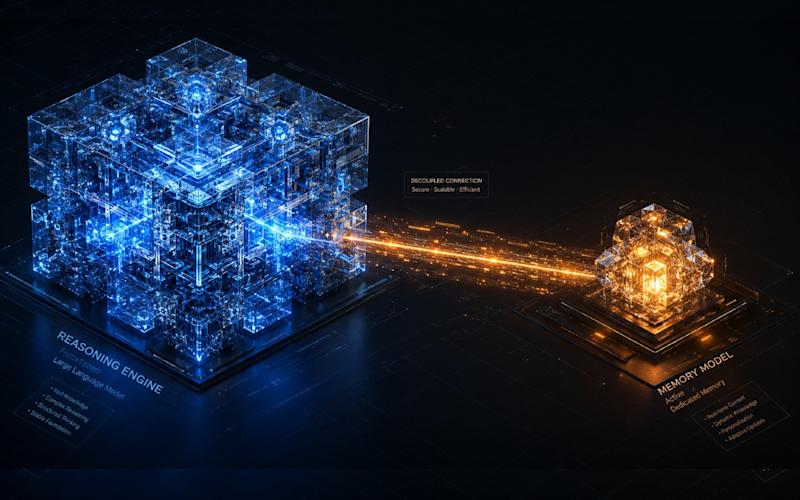
MeMo, un cadre élaboré par des chercheurs de plusieurs universités, code les nouvelles connaissances dans un modèle de mémoire dédié plus petit qui fonctionne séparément du LLM principal.
L’architecture modulaire fonctionne avec les modèles open source et fermés et évite la complexité des pipelines RAG et le recyclage complet des modèles.
Les expériences montrent que MeMo gère les requêtes complexes de manière fiable, même lorsque les pipelines de récupération sont bruyants. Il évite l’oubli catastrophique associé à un réglage fin direct et offre une voie rentable pour une mise à jour continue des connaissances.
Le défi de la mise à jour de la mémoire LLM
Les grands modèles de langage sont gelés après la formation et leurs connaissances internes restent statiques jusqu’à ce qu’ils subissent des mises à jour ultérieures et massives.
Actuellement, les développeurs s’appuient sur trois approches principales pour intégrer des connaissances externes dans un LLM, chacune présentant des inconvénients distincts :
Méthodes non paramétriquescomme la génération augmentée par récupération (RAG) et apprentissage en contexterécupérez les documents pertinents à partir d’une base de données externe et insérez-les directement dans l’invite du modèle. Bien que populaires, ces méthodes sont limitées par la taille des fenêtres contextuelles.
Comme Armando Solar-Lezama, co-auteur de l’article, l’a déclaré à VentureBeat, « les bases de données vectorielles ont une tâche fondamentalement difficile consistant à encoder la sémantique complète d’un morceau de texte dans un seul vecteur, puis à faire correspondre ce vecteur à une requête, même lorsque la pertinence du morceau… ne peut être apparente que dans le contexte d’autres morceaux. »

Les chercheurs notent que la similitude sémantique des intégrations ne correspond souvent pas à ce que nécessite réellement la requête d’un utilisateur. Le traitement de milliers de jetons récupérés crée également une surcharge de calcul et une latence d’inférence substantielles. Le plus problématique est que les systèmes RAG sont très sensibles au bruit. Les passages non pertinents ou mal récupérés dégradent souvent la réponse finale du modèle.
Méthodes paramétriquescomme la pré-formation continue ou le perfectionnement supervisé, tentent d’intérioriser de nouvelles connaissances directement dans les pondérations du LLM. La mise à jour de LLM modernes et massifs est d’un coût prohibitif et généralement impossible pour les modèles propriétaires à source fermée cachés derrière les API. Le réglage fin est également susceptible de provoquer oubli catastrophique. Forcer le modèle à s’adapter aux nouvelles données de l’entreprise érode souvent ses capacités de raisonnement et ses garde-fous de sécurité précédemment acquis.
Méthodes de mémoire latentecomme la compression de contexte, offrent un juste milieu. Ils compressent les connaissances en « jetons logiciels » compacts ou en représentations qui sont ajoutées au contexte du modèle lors de l’inférence. Le défaut fatal ici est le « couplage de représentation ». La mémoire compressée est strictement liée à l’architecture modèle qui l’a produite ; vous ne pouvez pas transférer une mémoire latente entraînée sur un modèle open source vers un modèle fermé.
Comment fonctionne MeMo
Le framework MeMo (Memory as a Model) introduit une architecture modulaire comportant deux composants distincts. Le modèle MEMORY est un petit modèle de langage formé spécifiquement pour coder de nouvelles connaissances dans ses paramètres. Le modèle EXECUTIVE est un LLM figé et disponible dans le commerce qui fonctionne comme un moteur de raisonnement. Lorsqu’un utilisateur pose une question, le modèle EXECUTIVE traite le modèle MEMORY comme un oracle externe, émettant des sous-requêtes ciblées pour rassembler des faits et synthétisant ces faits dans une réponse finale.

Le principe de conception fondamental qui anime MeMo est le concept de « réflexions ». Les réflexions sont des paires de questions-réponses (AQ) ciblées conçues pour capturer tous les angles possibles d’un corpus de connaissances. Plutôt que de forcer l’IA à traiter un corpus de documents massif et non structuré pendant la formation, MeMo utilise un modèle GENERATOR pour distiller le texte brut en milliers de paires d’assurance qualité ciblées. Le modèle MEMORY est ensuite affiné sur cet ensemble de données pour répondre aux questions en utilisant uniquement ses connaissances paramétriques sans avoir besoin de lire le contexte récupéré.

Au moment de l’inférence, l’interaction entre les deux modèles suit un protocole structuré en trois étapes :
1. Le modèle EXECUTIVE décompose la requête complexe d’un utilisateur en un ensemble de sous-questions atomiques. Le modèle MEMORY répond à chacun indépendamment pour établir les faits de base.
Suscríbete y recibe las historias más importantes del día.
Al suscribirte aceptas nuestros términos y condiciones y política de privacidad.
2. À l’aide de ces indices initiaux, le modèle EXECUTIVE émet des requêtes de suivi pour affiner les entités candidates jusqu’à ce qu’elles convergent en toute confiance vers une cible spécifique.
3. Enfin, le modèle EXECUTIVE interroge le modèle MEMORY pour obtenir des faits à l’appui sur cette entité cible et synthétise les extraits récupérés en une réponse cohérente.
Cette architecture fusionne les atouts des trois paradigmes de mémoire d’IA existants tout en contournant leurs pièges. Il exploite des modèles frontières disponibles dans le commerce en séparant le stockage en mémoire du raisonnement, garantissant ainsi la compatibilité avec les modèles d’API ouverts et fermés. Il internalise les connaissances directement dans les paramètres, mais isole les mises à jour dans un modèle MEMORY plus petit et dédié pour protéger le moteur de raisonnement. Enfin, il crée un artefact de mémoire interrogeable qui n’est lié à aucun modèle spécifique et peut être utilisé avec différentes familles LLM.
Gérer les mises à jour continues des connaissances
La gestion de la mémoire d’une IA nécessite des mises à jour continues à mesure que les politiques de l’entreprise changent et que de nouveaux rapports sont publiés. Normalement, la mise à jour des paramètres d’un modèle nécessite de le recycler à partir de zéro sur les anciennes et les nouvelles données combinées. À mesure que la base de connaissances s’accroît, ce coût cumulatif de recyclage devient ingérable.
Pour gérer efficacement les mises à jour continues, MeMo s’appuie sur une technique appelée « fusion de modèles ». Au lieu d’une phase de recyclage commune massive, MeMo entraîne un nouveau modèle MEMORY indépendant exclusivement sur les documents nouvellement ajoutés. Le système dérive un « vecteur de tâches » représentant les changements de paramètres appris à partir des nouvelles données. Ces mises à jour sont ensuite fusionnées mathématiquement dans les poids du modèle MEMORY d’origine.
Cette approche réduit les heures de calcul nécessaires pour maintenir le système à jour tout en évitant les interférences qui provoquent des oublis catastrophiques.
Cette efficacité s’accompagne d’un compromis : la fusion de modèles entraîne une baisse de précision de 11 à 19 % par rapport à un recyclage complet, selon le modèle de raisonnement utilisé.
MeMo en action
Pour mesurer l’efficacité dans le monde réel, l’équipe de recherche a évalué MeMo par rapport à plusieurs références industrielles qui nécessitent un raisonnement complexe à plusieurs sauts sur plusieurs documents.
Les chercheurs ont utilisé Qwen2.5-32B-Instruct comme modèle GENERATOR pour distiller le texte brut en réflexions. Pour le modèle MEMORY principal, ils ont déployé Qwen2.5-14B-Instruct. Ils ont également validé l’approche sur des modèles de paramètres 1-2B plus petits sur différentes architectures, notamment Gemma3-1B.
Pour le modèle de raisonnement EXECUTIVE, ils ont testé à la fois le Qwen2.5-32B à poids ouvert et le Gemini 3 Flash propriétaire de Google.
Ils ont comparé MeMo à une limite supérieure de « récupération parfaite » (où les documents exacts corrects sont fournis manuellement) et à plusieurs systèmes de récupération avancés, notamment la recherche traditionnelle BM25, la récupération de vecteurs denses et le RAG de pointe basé sur des graphiques (HippoRAG2). Ils ont également testé les « Cartouches », une méthode récente qui charge un Cache KV formé sur le modèle pendant l’inférence.

MeMo dominait dans le raisonnement sur des documents longs. Sur le benchmark NarrativeQA, MeMo a atteint une précision de 53,58 % associé à Gemini 3 Flash, selon les chercheurs. HippoRAG2 a atteint un maximum de 23,21 %.
Les systèmes d’entreprise doivent souvent synthétiser des réponses complexes, par exemple en traversant des cadres réglementaires qui se chevauchent et rédigés indépendamment par différents organismes, ou en consolidant les informations à travers une énorme base de code et une documentation externe. Les systèmes RAG traditionnels échouent ici car ils atteignent les limites de la fenêtre contextuelle et ne parviennent pas à connecter des concepts s’étendant sur des centaines de pages. MeMo réussit parce que ces connexions sont cartographiées et internalisées dans le modèle MEMORY pendant la formation. C’est «comme avoir son propre Malcolm Gladwell qui peut relier l’histoire des Beatles à celle de Bill Gates pour argumenter sur la nature de l’expertise», a déclaré Solar-Lezama.
Les expériences ont révélé un autre avantage majeur : la mise à niveau du moteur de raisonnement ne nécessite aucun recyclage. Le simple fait de passer du modèle EXECUTIVE du Qwen open source au Gemini 3 Flash propriétaire a augmenté les performances de MeMo de 26,73 % sur NarrativeQA et de 11,90 % sur le benchmark MuSiQue. Pour les praticiens, cela signifie que vous pouvez entraîner un modèle MEMORY en toute sécurité sur vos données privées et le connecter instantanément aux dernières API commerciales, mettant ainsi à jour en permanence l’intelligence du système sans encourir de nouveaux coûts de formation.
L’équipe de recherche a décrit l’intégration comme ne nécessitant aucune configuration supplémentaire : «Le LLM de base (ou exécutif) que les équipes utilisent déjà dans RAG peut être configuré pour interroger directement le modèle de mémoire. Ces requêtes sont effectuées en langage naturel, de la même manière que l’envoi d’une demande de message à une API, sans configuration supplémentaire requise.»
MeMo gère également exceptionnellement bien les données bruyantes. Lorsque les chercheurs ont délibérément inondé l’ensemble de données de documents non pertinents (jusqu’à deux fois la quantité d’informations utiles), les performances d’HippoRAG2 ont chuté de 11,55 %. La performance de MeMo est restée relativement stable, en baisse de moins de 2 %. Les bases de connaissances des entreprises sont généralement désordonnées, remplies de documents en double et de politiques obsolètes. Les systèmes RAG standard ont du mal à gérer ce bruit, insérant des paragraphes incorrects dans l’invite et provoquant des hallucinations. Étant donné que le modèle EXECUTIVE de MeMo interagit avec un oracle synthétisé plutôt qu’avec des morceaux de documents bruts, il reste très robuste face aux données d’entreprise désorganisées.
Limites et compromis
Pour les équipes d’ingénierie souhaitant déployer MeMo, plusieurs limitations clés doivent être prises en compte.
Contrairement aux systèmes RAG traditionnels qui indexent rapidement les documents bruts dans une base de données vectorielle, MeMo nécessite un coût de formation initial pour chaque nouveau corpus. Le pipeline de génération de données utilisé pour synthétiser les réflexions de formation est coûteux en termes de calcul. Par exemple, l’équipe a noté que « la génération de l’ensemble de données d’assurance qualité de réflexion complète prenait environ 240 heures GPU sur les NVIDIA H200 », tandis que la formation d’un modèle MEMORY à paramètres 14B « prenait environ 180 heures GPU H200 ». Comme l’a dit Solar-Lezama, «La réduction du coût de la formation est l’un des problèmes de recherche ouverts les plus importants afin d’en faire une technique performante.»
Le modèle MEMORY étant un réseau neuronal de taille fixe, sa capacité à internaliser les connaissances est limitée par sa capacité de représentation. Bien que les chercheurs n’aient pas atteint de limite stricte lors de leur analyse comparative, ils émettent l’hypothèse que « des corpus suffisamment volumineux ou riches en informations dépasseront ce qu’un modèle MEMORY de taille fixe peut correctement compresser et représenter ».
Enfin, comme MeMo synthétise les réponses à partir de la mémoire paramétrique plutôt que de récupérer des extraits de texte exacts, il obscurcit la provenance des informations. Cela rend difficile l’attribution de revendications spécifiques aux documents sources originaux, ce qui pose un problème de conformité critique pour les applications d’entreprise nécessitant des pistes d’audit strictes.
Choisir entre MeMo et le RAG traditionnel se résume à une heuristique de « recherche ou synthèse », parallèlement à la volatilité des données. Les chercheurs conseillent que « le RAG traditionnel serait préféré lorsque les réponses se trouvent dans un seul document ou lorsqu’il existe une source bien définie… MeMo serait préféré lorsque la tâche passe de la recherche à la synthèse d’une réponse à partir d’informations dispersées sur plusieurs morceaux. » Si votre corpus de connaissances évolue rapidement (par exemple, flux quotidiens) et que vous avez besoin de citations exactes des sources, RAG reste la meilleure option en raison du coût de formation initial de MeMo. Si votre corpus est constitué de connaissances de domaine généralisées qui évoluent lentement par rapport à son volume, MeMo offre un raisonnement bien supérieur. Les équipes peuvent également adopter une architecture de routage hybride en production : envoi de requêtes de « recherche » vers une base de données vectorielle standard et de requêtes de « synthèse » vers le modèle MEMORY.
«En regardant plus loin, je m’attendrais à ce que les modèles de mémoire deviennent un composant architectural standard aux côtés de la récupération», a déclaré à VentureBeat Daniela Rus, co-auteur de l’article et directrice du laboratoire d’informatique et d’intelligence artificielle du MIT (CSAIL), «de la même manière que la mise en cache et l’indexation sont aujourd’hui des composants standards de tout système de données sérieux».