




































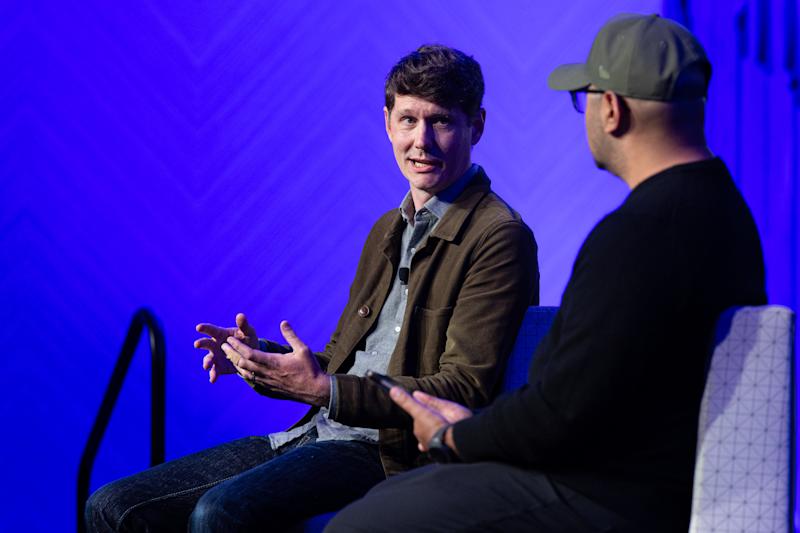
La industria de la IA empresarial tiene un problema matemático. Los datos de Cisco muestran que el 85% de las empresas están probando agentes de IA, pero sólo el 5% los ha puesto en producción. El martes en VB Transform 2026, Bryan Silverthorn, director de autonomía AGI en Amazon, explicó por qué esta brecha persiste y por qué la respuesta no está en mejores puntos de referencia.
Silverthorn, que se unió a Amazon cuando adquirió Adept AI y ahora dirige la capacitación de agentes multimodales en el AGI Lab de la compañía, argumentó que la confiabilidad debería dividirse en cuatro dimensiones distintas: consistencia, solidez, previsibilidad y seguridad, un marco que atribuye a la investigación de Princeton.
«Revela diferentes factores que veo entrelazados en casi todas las evaluaciones que he visto», dijo.
Por qué los agentes de IA aprueban las evaluaciones internas pero fracasan con los clientes de producción reales
El marco es importante porque los agentes pasan rutinariamente evaluaciones internas y luego se quedan en el aire. Silverthorn describió a un cliente que implementó un agente para el control de calidad del software que implicaba extraer números de serie de las pantallas. Funcionó perfectamente durante dos meses y luego empezó a leer números incorrectos de forma intermitente. El culpable: el codificador de visión subyacente se comportaba de manera diferente dependiendo de dónde aparecía el número de serie en la pantalla, y un cambio de software imperceptible para los humanos provocó la interrupción.
La lección, dijo Silverthorn, es acerca de la medición, no sólo de los modelos. «Los modelos necesitan ser mejores. Obviamente estamos trabajando duro para mejorarlos», afirmó. Pero lo más importante, añadió, es que los equipos deben identificar sus dimensiones de variabilidad y adaptar el rigor de las mediciones a los desafíos de la aplicación. La investigación patentada de VentureBeat, presentada antes de la sesión, refuerza este punto: la mitad de las empresas encuestadas enviaron agentes que aprobaron evaluaciones internas pero fracasaron con clientes reales, y la inmensa mayoría de las empresas rastrean la disponibilidad ignorando la precisión: tomando el pulso sin verificar el diagnóstico. Un hallazgo relacionado destacó cuán pocas barreras existen: la mayoría de las empresas confían por defecto en las propias evaluaciones de los modeladores y poco más, dejando su estrategia de prueba, como la describí en el escenario, una lucha entre confiar en el proveedor y no confiar en nada.
En el marco «interno» de Amazon para gestionar agentes autónomos de IA
La receta más memorable de Silverthorn fue cultural, no técnica. En el laboratorio AGI de Amazon, los investigadores literalmente llaman a sus agentes «pasantes», como en «Voy a pedirle a mi pasante que hable con el suyo». El chiste conlleva una filosofía operativa seria. Los agentes, al igual que los pasantes, son poderosos pero a veces despistados, capaces de realizar un trabajo increíble y descarrilamientos espectaculares.
Gestionarlos, afirma, requiere habilidades de gestión más que habilidades de software: preguntar qué podría salir mal, agregar copias de seguridad y capacidades de deshacer, y decidir conscientemente cuánto riesgo se puede aceptar. «Puedes preguntarle al pasante: ‘Oye, ¿qué podrías estar haciendo mal aquí?’ ¿Cómo podría mitigar sus resultados negativos? «, dijo. El laboratorio de Amazon adoptó este compromiso, aceptando que los agentes ocasionalmente realizarían el experimento equivocado a cambio de velocidad de investigación, incluido un agente que realiza experimentos las 24 horas del día según su propio plan de investigación de alto nivel.
Qué deberían hacer los líderes empresariales antes de implementar agentes a escala
Silverthorn ha sido franco acerca de las limitaciones de la tecnología actual. La IA de mejora personal sigue siendo “un término cargado”, afirmó: Amazon utiliza la IA para mejorar constantemente sus modelos, pero la mejora personal totalmente autónoma está muy lejos. El uso de computadoras sigue siendo fundamental para su laboratorio, y un cliente de transporte comercial ya utiliza la automatización del navegador para consolidar reclamos de garantía en sistemas fragmentados**, aunque enfatizó que ningún agente futuro dependerá únicamente del uso de la computadora: trabajará con MCP, API y otras herramientas para completar flujos de trabajo de extremo a extremo**. Y las técnicas de LLM como juez, aunque prometedoras, son sólo una de muchas estrategias para alinear las capacidades de los agentes con un riesgo aceptable.
Para las empresas atrapadas en el purgatorio piloto, el camino a seguir comienza con un cambio de mentalidad: deje de preguntarse si su agente puede hacer algo impresionante una vez y comience a preguntarse si puede hacerlo bien mil veces seguidas.
En otras palabras, las empresas que escapen del límite del 85% no serán aquellas que tengan los agentes más inteligentes. Serán ellos los que tengan mejores directivos.


Suscríbete y recibe las historias más importantes del día.
Al suscribirte aceptas nuestros términos y condiciones y política de privacidad.