







































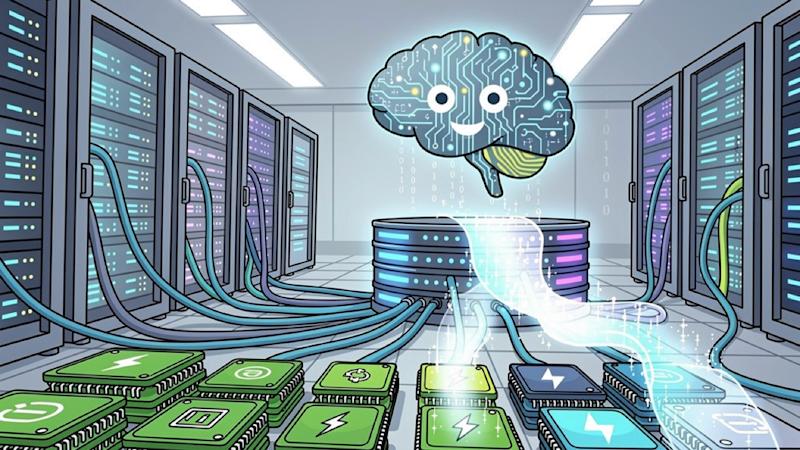
La memoria de la GPU es el recurso más caro en la producción de IA y también el que se agota más rápidamente.
Las ventanas de contexto prolongadas y las conversaciones de varios turnos obligan a los modelos de IA a recalcular repetidamente la información que ya han procesado, consumiendo memoria de GPU y computación que de otro modo podrían servir a usuarios adicionales o generar nuevas respuestas.
En lugar de tratar la memoria de la GPU como el recurso limitante, ¿por qué no ampliarla con tecnologías de almacenamiento mucho más económicas?
Wekapor su parte, cree que el almacenamiento flash barato puede cerrar esa brecha. La plataforma de software NeuralMesh 6 de la compañía, que se lanza junto con su primera línea de hardware de diseño propio, Wekapod 3, amplía lo que Weka llama Augmented Memory Grid, un enfoque que agrega flash NAND para que se comporte como memoria GPU a una fracción del costo.
Se trata de una categoría activa y cada vez más concurrida. Dell, NetApp, Pure Storage y VAST se han reposicionado hacia la infraestructura de IA en los últimos dos años y Weka es uno de varios proveedores que argumentan que está diseñada para este momento específico en lugar de adaptarse a él.
«Lo que estamos viendo ahora con los clientes es que están persiguiendo la disponibilidad de computación, y una vez que obtienen una nueva asignación de alguien, quieren poder tomarla y comenzar a ejecutarla de inmediato», dijo a VentureBeat el cofundador y director ejecutivo de Weka, Liran Zvibel.
La recompensa potencial es sencilla: una mejor utilización de las inversiones existentes en GPU, menores costos de inferencia y una implementación más rápida de nuevas cargas de trabajo de IA sin esperar meses para obtener capacidad adicional de GPU.
La tecnología es más relevante para las organizaciones que ya operan IA a escala o que esperan un rápido crecimiento en su uso, particularmente empresas que construyen copilotos internos, agentes de servicio al cliente, asistentes de ingeniería de software o sistemas de recuperación con ventanas de contexto largas. Las implementaciones más pequeñas pueden obtener menos beneficios inmediatos que las organizaciones donde la utilización de GPU ya se ha convertido en un factor limitante.
Dentro de NeuralMesh 6 de Weka
NeuralMesh 6 agrega cuatro capacidades dirigidas directamente a una brecha de funcionalidad que, según Zvibel, le ha costado acuerdos a Weka en evaluaciones competitivas.
Componible y multiinquilino virtual. Los clústeres componibles brindan a los inquilinos ancla un aislamiento total a nivel de hardware, CPU, memoria y almacenamiento dedicados. La multiinquilino virtual se ejecuta a través del tejido RDMA de Weka, lo que ofrece un aislamiento a nivel de red que supera los 1000 inquilinos por clúster, con aprovisionamiento en menos de 30 minutos. Combinado, un único clúster que ejecuta 50 clústeres componibles puede admitir hasta 50 000 inquilinos.
Almacenamiento unificado de archivos y objetos. La mayoría de los sistemas de almacenamiento mantienen dos rutas separadas: una ruta basada en archivos (la forma estándar en que los servidores y las aplicaciones leen y escriben archivos, que se utiliza mucho en el entrenamiento y el ajuste de canalizaciones) y una ruta basada en objetos (S3, la inferencia de formato y las herramientas nativas de la nube que normalmente se esperan). Normalmente, una puerta de enlace se traduce entre los dos, lo que significa que los datos existen efectivamente dos veces. La afirmación de Weka es que los mismos datos físicos en el disco se pueden leer directamente a través de cualquier ruta a la vez, sin capa de traducción ni segunda copia. Zvibel se dirige específicamente a las nubes de GPU que no son de AWS, nombrando Lambda, Nebius, G42 y CoreWeave, con lo que describió como un rendimiento aproximadamente dos órdenes de magnitud mayor que el S3 convencional y un modelo de precios basado en la capacidad en lugar de cargos por API.
Replicación de metadatos primero. Los entornos de destino se vuelven navegables antes de que llegue una copia completa de los datos, y los datos se hidratan solo cuando se accede a ellos.
«Tuvieron que esperar a que todo eso llegara al otro lado, y esto lleva días o semanas, en casos extremos un mes», dijo Zvibel. «Ahora permitimos a nuestros clientes obtener una asignación de nuevas GPU y ponerlas en funcionamiento en una hora».
AlloyFlash y reducción de datos Always-On. TLC y QLC son dos tipos de memoria flash NAND. TLC es más rápido y duradero, pero cuesta más por terabyte, mientras que QLC es más barato y contiene más datos por chip, pero es más lento. AlloyFlash combina ambos dentro de un solo clúster, enrutando automáticamente el trabajo sensible a la latencia a TLC mientras ejecuta cargas de trabajo de gran capacidad en QLC, lo que reduce el costo por terabyte sin una penalización de rendimiento en el trabajo que necesita velocidad. La reducción de datos ahora se ejecuta de forma predeterminada y no como una opción.
Resolver el problema contextual de la IA
El almacenamiento de objetos y el arrendamiento múltiple resuelven la forma en que las empresas y las neo nubes operan la plataforma en el día a día. Debajo se esconde un problema más difícil: a medida que crecen las ventanas de contexto y las interacciones de múltiples turnos, la GPU también calcula el trabajo de recálculo desperdiciado que un modelo ya ha realizado. Augmented Memory Grid, una función de NeuralMesh 6 creada específicamente para esto, es la respuesta de Weka.
Cada mensaje desencadena dos etapas. Prefill calcula la atención, el mecanismo central detrás de cómo los modelos de lenguaje grandes procesan la entrada, y es computacionalmente costoso. Decode convierte ese cálculo en resultados y es comparativamente liviano.
El costo se muestra más evidente en sesiones de varios turnos, como el chat o la codificación, donde cada nuevo turno se vuelve a activar para todo lo anterior, a menos que ese trabajo se haya almacenado en caché.
«Si tienes 10 turnos, puedes sobrecalcular 100 veces porque los estás rehaciendo todos. Si tienes 20, sobrecalcularás 400 veces», dijo Zvibel. «Puedes poner dos órdenes de magnitud más NAND de lo que podrías permitirte en la memoria compartida, y podemos almacenar en caché el 100% de los tokens precalculados, por lo que nunca tendrás que rehacerlo».
Dónde se sitúa Weka en términos competitivos
Los proveedores de almacenamiento han pasado el último año y medio reposicionándose en torno a la IA, y separar la capacidad genuina de la mensajería reposicionada es ahora un verdadero problema de evaluación para los compradores.
«El mundo del almacenamiento está cambiando su enfoque de servir bits a cargas de trabajo empresariales a administrar datos a la velocidad de la IA. Lo hemos visto más claramente en los últimos 18 meses con Dell, NetApp y Pure», dijo a VentureBeat Steve McDowell, analista jefe de NAND Research. «Lo interesante es que empresas como Weka y VAST son verdaderas empresas de datos nativos de IA y resuelven estos problemas desde el primer día».
McDowell destacó Augmented Memory Grid como el liderazgo técnico más claro de Weka.
«Weka sigue teniendo la implementación de caché KV con mayor capacidad técnica del mercado con su Augmented Memory Grid», afirmó. «Llegaron temprano con esta tecnología y continúan innovando. Esto es fundamental para la inferencia de IA, ya que permite un nivel de eficiencia de GPU que, sin lugar a dudas, ahorra dinero en GPU y memoria. Eso es clave para el mercado actual de memoria y GPU limitado».
También señaló que la garantía contractual de Weka sobre sus reclamaciones de reducción de datos está subestimada.
«Uno pasa desapercibido: Weka pone su dinero en garantías contractuales para sus promesas de reducción de datos», afirmó.
El consejo de McDowell a los compradores que evalúan las afirmaciones competitivas de Weka, VAST, Pure y NetApp por igual fue apuntar a que los compradores empresariales deberían analizar detenidamente lo que los proveedores prometen frente a lo que realmente ofrecen.
«Un comprador inteligente observará cómo los proveedores competidores están resolviendo hoy los problemas del mundo real», dijo McDowell. «Lo hacen hablando con organizaciones que ejecutan cargas de trabajo similares a una escala similar. Si un proveedor no puede señalar eso, entonces debería ser una señal de advertencia».


Suscríbete y recibe las historias más importantes del día.
Al suscribirte aceptas nuestros términos y condiciones y política de privacidad.