







Cuando el equipo de datos de Miro dirigió a los agentes de IA directamente a su entorno Snowflake, los agentes obtuvieron la respuesta incorrecta más del 65% de las veces. El problema no era el modelo, sino el contexto. Con más de 10.000 tablas y ninguna capa semántica para guiar el enrutamiento, los agentes no tenían forma de saber qué activos de datos correspondían a qué preguntas comerciales.
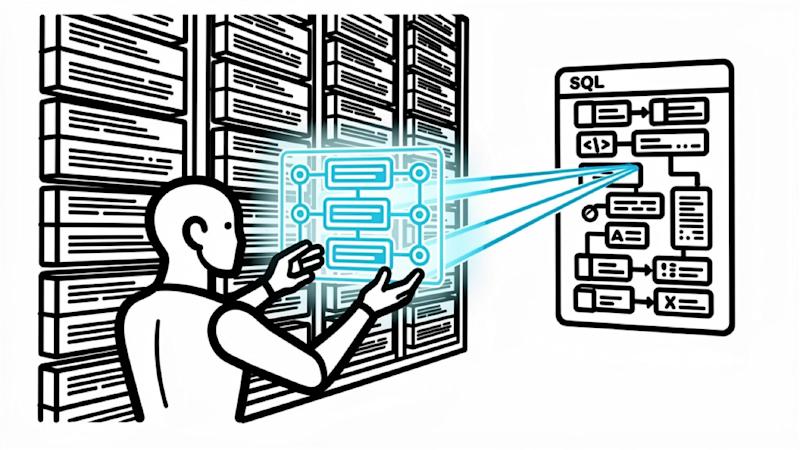
DataHub lanzará el jueves una capa de inteligencia contextual que aprovecha el historial de consultas SQL existente para crear un índice semántico y lo expone a los agentes a través de MCP, LangChain, Agent SDK de Google y CrewAI. La compañía lo llama Context Intelligence y se basa en la misma infraestructura de registro de consultas que DataHub ha utilizado para el seguimiento del linaje en implementaciones de producción en todo el mundo.
La empresa fue fundada por el equipo que creó DataHub como un proyecto de código abierto en LinkedIn, donde la cofundadora y directora de tecnología Shirshanka Das dirigió la infraestructura de datos durante casi 11 años. El proyecto de código abierto cuenta ahora con más de 15.000 contribuyentes y 3.000 implementaciones de producción en todo el mundo.
«Por primera vez, las empresas pueden convertir años de historial de consultas de analistas en una base de conocimiento viva y recuperable donde los agentes dejan de alucinar uniones porque tienen acceso a uniones que funcionaron antes, validadas por las personas que las administraron», dijo Shirshanka Das, cofundadora y CTO de DataHub, a VentureBeat en una entrevista exclusiva.
Por qué el historial de consultas supera al esquema sin formato para el enrutamiento de agentes
DataHub comenzó como un proyecto de gestión de metadatos en LinkedIn, diseñado para resolver dos problemas simultáneamente: hacer que los datos sean fáciles de encontrar y usar en toda la organización y, al mismo tiempo, garantizar que solo se utilicen por los motivos correctos. Das hizo que el proyecto fuera de código abierto a principios de 2020 después de casi seis años de desarrollo interno.
El principal caso de uso en los años posteriores ha sido el linaje: comprender cómo fluyen los datos desde los sistemas operativos a través de la infraestructura de transmisión hasta los almacenes y las herramientas comerciales. Las auditorías de cumplimiento normativo, la clasificación operativa y la incorporación de nuevos ingenieros dependen de este cuadro de linaje. Postgres es la fuente de base de implementación de DataHub más conectada del mundo, seguida de MySQL, Oracle y los principales almacenes en la nube, incluidos Snowflake y Google BigQuery. La plataforma admite más de 100 fuentes de metadatos conectadas.
Esta base implementada es importante para lo que publica DataHub. Las capacidades de extracción de registros de consultas y análisis de SQL que impulsan Context Intelligence se desarrollaron durante años de implementación en producción y no se diseñaron para esta versión. La misma infraestructura ahora sirve a agentes que consultan un índice semántico en tiempo de ejecución.
«La capa de consumo ha pasado de los humanos a los agentes», dijo Das.
Context Intelligence aprovecha el historial de consultas validado, no los registros sin procesar
Context Intelligence es una nueva capa de funcionalidad construida sobre la base de metadatos de código abierto existente de DataHub. La plataforma de código abierto lleva años extrayendo y analizando registros de consultas de almacenes conectados para realizar un seguimiento del linaje. Es en esta misma infraestructura que Context Intelligence se basa para construir el índice semántico. La habilidad es nueva. La plomería subyacente no lo es.
Filtrado de señales. Los registros de consultas del almacén contienen demasiado ruido para utilizarlos directamente. El motor de DataHub filtra lo que Das describe como «consultas doradas»: consultas de analistas de alta calidad y canalizaciones planificadas que representan una lógica empresarial comprobada.
Invierta SQL en definiciones semánticas. El motor extrae patrones de estas consultas y los traduce en definiciones de texto estructurado que DataHub llama anclajes semánticos. Estos anclajes forman la base de recuperación en la que confían los agentes antes de generar SQL. «Casi se puede pensar en esto como invertir texto en SQL», dijo Das.
Validación humana en la cima. Context Hub permite a los expertos en el dominio revisar el contexto proporcionado por la IA, resolver definiciones contradictorias y simular el impacto de los cambios antes de publicarlos. DataHub presenta casos en los que diferentes equipos calculan la misma métrica de manera diferente y la elevan a resolución humana.
Cómo Miro consiguió que agentes de IA trabajaran en 10.000 mesas Snowflake
Miro, la plataforma de colaboración digital, ya estaba utilizando DataHub para el seguimiento de linaje y el análisis de impacto cuando comenzó a probar agentes de análisis en su entorno Snowflake. Ronald Angel, gerente de producto de la plataforma de datos de Miro, dijo a VentureBeat que la escala del patrimonio de datos se convirtió inmediatamente en el problema. El envío de consultas en lenguaje natural directamente a MCP Snowflake produjo respuestas incorrectas más del 65% de las veces. Exponer más de 10.000 tablas directamente a los agentes causó demasiada confusión para un enrutamiento confiable.
Miro resolvió el problema organizando los datos en productos de datos bien definidos que limitan lo que los agentes pueden ver en lugar de exponer un esquema sin formato. La arquitectura de producción se ejecuta a partir de las solicitudes de los usuarios enviadas a través de Claude Chat o Claude Cowork a través de una capa contextual donde el MCP de DataHub asigna el lenguaje natural a los activos de datos apropiados y luego lo entrega al MCP de Snowflake para la generación de SQL.
Angel dijo que la capa de contexto extrae metadatos, relaciones entre entidades, historial de consultas e intención comercial para cada tabla de Snowflake, específicamente la pregunta comercial para la cual cada entidad está diseñada para responder. Estas señales semánticas permiten al agente identificar las entidades de base de datos correctas antes de escribir SQL en lugar de adivinar únicamente a partir del esquema.
Pinecone, Oracle, Redis, Microsoft: cómo DataHub se adapta a la pila de contexto
Los proveedores de datos, incluidos Pinecone, Oracle y Redis, tienen capacidades de memoria de contexto. En el lado de la plataforma, Microsoft construyó su Fabric IQ como una capa semántica para el contexto.
El argumento de DataHub no es la paridad de características. La empresa posiciona la capa de contexto como plataforma neutral, proporcionando contexto a los puntos finales existentes, como Snowflake Semantic Views y Microsoft Fabric IQ, en lugar de reemplazarlos.
«A menudo la gente quiere ser neutral en cuanto a la plataforma en lo que respecta a su capa de contexto», dijo Das.
Kevin Petrie, analista de BARC, dijo a VentureBeat que ve la capacidad de DataHub para integrar varios metadatos para objetos estructurados y no estructurados, incluidos documentos e imágenes, como una forma de diferenciarlos en el mercado.
«Muchos otros proveedores se centran más en tablas estructuradas, que proporcionan información confiable pero a menudo carecen del rico contexto de los objetos de texto», dijo.
Michael Ni, vicepresidente y analista principal de Constellation Research, dijo a VentureBeat que, para él, lo que destaca de la capa contextual de DataHub es su soporte para pasar de la catalogación pasiva a una inteligencia semántica continuamente actualizada. Ni describió la competencia por el contexto como la próxima gran guerra de plataformas, argumentando que quien controle el contexto en tiempo de ejecución controla la capa de decisión para los datos, los agentes, los flujos de trabajo y las decisiones.
«Los compradores deben tener cuidado, ya que muchos proveedores solo admiten una parte de las capacidades contextuales integrales necesarias para la inteligencia artificial y las soluciones de agentes», dijo Ni. «Los compradores deben tener claros sus requisitos de gestión del contexto porque la memoria vectorial no es significado comercial, el significado comercial no es gobernanza y la gobernanza no es ejecución».


Suscríbete y recibe las historias más importantes del día.
Al suscribirte aceptas nuestros términos y condiciones y política de privacidad.