




























Redis se hizo famoso como la capa de almacenamiento en caché que evitaba que las aplicaciones web colapsaran bajo carga. El problema al que se enfrenta ahora tiene la misma estructura, pero es más difícil de resolver: los agentes de producción de IA fallan no porque los modelos sean incorrectos, sino porque los datos que contienen están dispersos, obsoletos y estructurados para humanos en lugar de máquinas. Los canales de recuperación creados para consultas únicas no pueden absorber el volumen que generan los agentes.
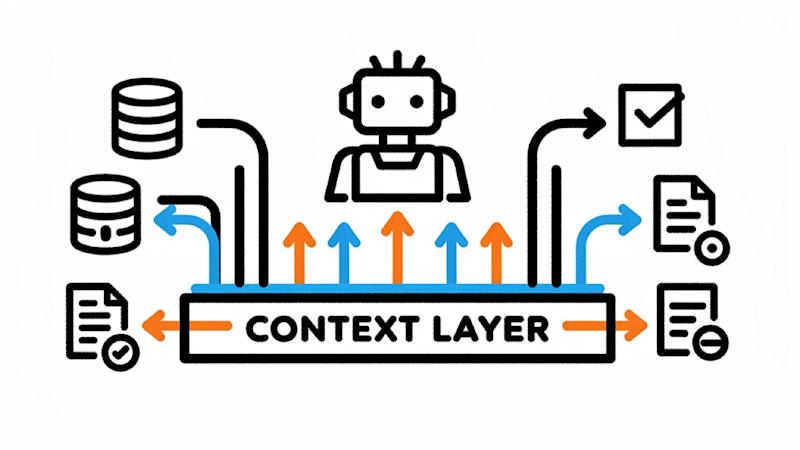
La brecha a la que se dirige Redis es estructural: los agentes realizan órdenes de magnitud más solicitudes de datos que los usuarios humanos, pero la mayoría de las capas de recuperación se construyeron para el problema a escala humana. Redis Iris, lanzado el lunes, es la respuesta de la compañía: una plataforma de contexto y memoria que se ubica entre un agente y los datos que necesita para actuar. La plataforma combina la ingesta de datos en tiempo real, una interfaz semántica que genera automáticamente herramientas MCP a partir de modelos de datos comerciales y un servidor de memoria de agente integrado en Redis Flex, un motor de almacenamiento reescrito que ejecuta el 99 % de los datos en flash a una décima parte del costo del almacenamiento en memoria por sí solo.
El anuncio llega cuando la infraestructura RAG empresarial se encuentra en transición activa. VB Pulse del primer trimestre de 2026 de VentureBeat RAG Infrastructure Market Tracker descubrió que la intención de los compradores de adoptar la recuperación híbrida se triplicó del 10,3% al 33,3% entre enero y marzo. La optimización de la recuperación superó por primera vez la evaluación como principal prioridad de inversión empresarial. Las pilas de recuperación internas personalizadas aumentaron del 24,1% al 35,6% a medida que las empresas superaron las opciones disponibles en el mercado. Redis no es el único proveedor de infraestructura que lee esas señales: varios proveedores de plataformas de datos se han reposicionado alrededor de las capas de contexto de los agentes en las últimas semanas.
El desajuste de escala es el argumento estructural detrás del lanzamiento. «Las empresas tendrán muchos más agentes que seres humanos», dijo Rowan Trollope, director ejecutivo de Redis. VentureBeat. «Órdenes de magnitud más agentes que seres humanos significan órdenes de magnitud más carga en los sistemas back-end».
Del caché al contexto
Trollope rastrea el paralelo hasta la era móvil: cuando los backends heredados creados para los cajeros de las sucursales de repente tuvieron que atender a un millón de usuarios de teléfonos inteligentes, Redis se convirtió en la capa de almacenamiento en caché que absorbió la carga sin una reconstrucción completa.
La diferencia esta vez es que los agentes no pueden escribir su propio middleware. En la era móvil, un desarrollador se sentaba con un administrador de base de datos, identificaba las consultas que necesitaba una aplicación y codificaba la lógica de almacenamiento en caché en una capa de middleware. Los agentes no pueden hacer eso. Necesitan encontrar los datos correctos en tiempo de ejecución, a través de interfaces creadas para ellos de antemano, o se estancarán.
«Esto es como la analogía del supermercado en el refrigerador», dijo. «Si cada vez que tienes que ir a preparar tu sándwich, tienes que correr al supermercado para conseguir la comida, eso no es muy eficiente. Pones un refrigerador en cada casa, guardas un poco de comida allí. Y ahí es donde todavía tendemos a existir en la pila de infraestructura».
Qué incluye Redis Iris
Iris incluye cinco componentes que en conjunto cubren la ingesta de datos, el acceso semántico, la memoria y el almacenamiento en caché.
Integración de datos de Redis. Ahora en disponibilidad general. RDI utiliza canalizaciones de captura de datos modificados para sincronizar datos de bases de datos relacionales, almacenes y almacenes de documentos en Redis de forma continua, con conectores para Oracle, Snowflake, Databricks y Postgres.
Recuperador de contexto. Ahora en vista previa. Los desarrolladores definen un modelo semántico de datos comerciales utilizando modelos pydantic y Redis genera automáticamente herramientas MCP que los agentes usan para consultarlos directamente, con controles de acceso a nivel de fila aplicados en el lado del servidor. Trollope describe el cambio del RAG clásico como una inversión direccional. «Es simplemente un giro permitir que el agente extraiga los datos en lugar de presuponerlos y meterlos en el proceso», dijo.
Memoria del agente. Ahora en vista previa. Almacena el estado a corto y largo plazo en todas las sesiones para que los agentes lleven el contexto sin volver a derivarlo en cada turno.
Redis Flex. Un motor de almacenamiento reescrito que ejecuta el 99 % de los datos en SSD y el 1 % en RAM, lo que ofrece una recuperación a escala de petabytes con latencias inferiores a milisegundos.
Búsqueda de Redis y LangCache. La columna vertebral de recuperación y almacenamiento en caché semántico debajo de la plataforma. LangCache reduce las llamadas de modelo redundantes al almacenar en caché las respuestas rápidas.
Lo que dicen los analistas
La industria de los datos va ahora en general en la misma dirección. Todos los principales proveedores de bases de datos están presentando un argumento sobre la capa de contexto.
Proveedores de bases de datos tradicionales incluyendo oráculo están integrando capas de contexto y memoria para llevar las bases de datos relacionales a la era de la IA agente. Proveedores de bases de datos vectoriales especialmente diseñadas, incluidos Piña están haciendo lo mismo, construyendo una nueva capa de conocimiento para el contexto de IA agente. Capas de contexto independientes como Comprensión retrospectiva también son parte del panorama emergente.
Trollope enmarca la posición de Redis como estructuralmente diferente de esa competencia.
«Para que nosotros ganemos, nadie más tiene que perder», afirmó. Muchas implementaciones de Redis ya ejecutan MongoDB u Oracle como sistema de registro backend. Iris refleja y almacena en caché esos sistemas en lugar de desplazarlos. Redis está lanzando Iris en el mercado Snowflake con conectores nativos.
Stephanie Walter, líder de práctica de AI Stack en HyperFRAME Research, explica claramente el contexto del mercado. «El mercado está convergiendo en la misma conclusión: los agentes no sólo necesitan más tokens o mejores modelos. Necesitan un contexto gobernado, actual y de baja latencia», dijo Walter.
Su lectura sobre la diferenciación de Redis se centra en dónde ya se encuentra Redis en la pila, que está cerca del tiempo de ejecución, el estado operativo sensible a la latencia y los datos en tiempo real.
«El discurso no es ‘mejor RAG’ sino que ‘los agentes necesitan contexto vivo, memoria y recuperación rápida mientras están trabajando», dijo.
Ya sea Redis u otro proveedor, cada tecnología de capa de contexto enfrentará un desafío de gobernanza para tener éxito.
«La IA agente no escalará en la empresa si cada agente se convierte en un nuevo centro de costos, un nuevo riesgo de acceso a los datos y una nueva excepción de gobernanza», afirmó. «Las capas de contexto ganadoras serán aquellas que hagan que los agentes sean más rápidos, más baratos y más seguros de ejecutar».
Para la IA clínica en tiempo real, equivocarse en el contexto no es una opción
Mangoes.ai es una empresa que ya ha tenido que responder esas preguntas en producción, en condiciones en las que el costo de entender mal el contexto se mide en los resultados de los pacientes.
Amit Lamba, fundador y director ejecutivo de Mangoes.ai, administra una plataforma de inteligencia artificial de voz en tiempo real implementada en grandes instalaciones de atención médica donde los pacientes y los médicos hacen preguntas en vivo sobre el tratamiento, la programación y el historial del caso. Mangoes.ai construyó su pila de forma nativa en Redis desde el principio.
«La recuperación, la memoria y el estado de la sesión se ejecutan a través de Redis, por lo que no unimos herramientas separadas y esperamos que se comuniquen entre sí», dijo Lamba.
El problema que aborda la capacidad de memoria dinámica de Iris es lo que sucede en una sesión compleja.
«Piense en una sesión de terapia grupal de una hora», dijo Lamba. «Es necesario saber quién dijo qué, cuándo y poder ofrecerle al terapeuta la información correcta en el momento. Ese no es un simple problema de recuperación».
La plataforma ejecuta múltiples agentes especializados en paralelo, uno para la identificación de entidades, otro para el razonamiento de relaciones y otro para integrar el historial de casos. «La capacidad de la memoria dinámica se adapta casi perfectamente al problema que estamos resolviendo», dijo Lamba.
Qué significa esto para las empresas
Para las empresas que construyeron su pila de IA en torno a RAG, la capa de recuperación que las llevó a producción ya no es suficiente para mantenerlas allí.
La era RAG está dando paso a la arquitectura contextual. El modelo RAG clásico insertaba datos en el agente antes de llamar al modelo. Las implementaciones de producción están cambiando eso: los agentes extraen lo que necesitan en tiempo de ejecución a través de llamadas a herramientas, tratando la capa de datos como un recurso en vivo en lugar de una carga útil precargada. Los equipos que aún optimizan los oleoductos RAG están resolviendo el problema del año pasado.
La capa semántica es ahora la infraestructura de producción. El modelo que define las entidades comerciales, sus relaciones y las reglas de acceso entre ellas debe construirse, versionarse y mantenerse con la misma disciplina que un canal de datos. La mayoría de las organizaciones no cuentan con personal ni estructura para ese trabajo. Las empresas que definen su arquitectura contextual ahora son las que no tendrán que reconstruirla cuando las cargas de trabajo de los agentes aumenten.
El presupuesto ya se está moviendo. Los datos de VB Pulse Q1 2026 muestran que la inversión en optimización de la recuperación aumentó del 19% al 28,9% durante el trimestre, superando el gasto en evaluación por primera vez. Las organizaciones que dedicaron el año anterior a medir la calidad de su recuperación ahora están invirtiendo en arreglarlo. La capa de contexto es una decisión de adquisición activa, no un elemento de la hoja de ruta.
«La primera pregunta del comprador no debería ser ‘¿Necesito una base de datos vectorial, un contexto largo, memoria o un motor de contexto?’ Debería ser ‘¿Qué necesita saber este agente, qué tan actualizado debe ser ese conocimiento, quién puede acceder a él y cuánto cuesta cada recuperación?'», dijo Walter.


Suscríbete y recibe las historias más importantes del día.
Al suscribirte aceptas nuestros términos y condiciones y política de privacidad.