






En este momento, todos los laboratorios de inteligencia artificial de vanguardia están racionando dos cosas: electricidad y computación. La mayoría de ellos compra su computadora para la capacitación de modelos al mismo proveedor, con márgenes brutos elevados que han convertido a Nvidia en una de las empresas más valiosas del mundo. Google no lo hace.
El martes por la noche, dentro de una reunión privada en F1 Plaza en Las Vegas, Google presentó una vista previa de sus Unidades de Procesamiento Tensor de octava generación. El argumento: dos diseños de silicio personalizados que se lanzarán a finales de este año, cada uno de ellos diseñado específicamente para una mitad diferente de la carga de trabajo de IA moderna. TPU 8t apunta al entrenamiento para modelos de frontera, y TPU 8i apunta al mundo de la inferencia agente y el muestreo en tiempo real, de baja latencia y ávido de memoria.
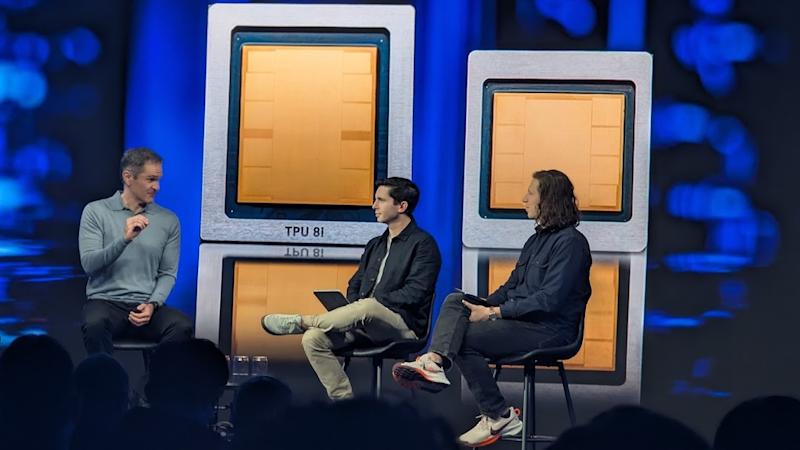
Amin Vahdat, vicepresidente senior y tecnólogo jefe de IA e infraestructura de Google (en la foto arriba a la izquierda), usó su tiempo en el escenario para resaltar un punto que importa más a los compradores empresariales que cualquier especificación individual: Google diseña cada capa de su pila de IA de extremo a extremo, y esa integración vertical está comenzando a aparecer en la economía de costo por token que Google dice que sus rivales no pueden igualar.
«Un chip al año no era suficiente»: Dentro de la apuesta de Google para 2024 por una hoja de ruta de dos chips
La historia más interesante detrás de v8t y v8i es cuando se tomó la decisión de dividir la hoja de ruta. La llamada se produjo en 2024, según Vahdat, un año antes de que la industria en general girara hacia los modelos de razonamiento, los agentes y el aprendizaje por refuerzo como la carga de trabajo de frontera dominante.
En ese momento, era una lectura contraria. «Hace dos años nos dimos cuenta de que un chip al año no sería suficiente», dijo Vahdat durante la charla informal. «Esta es nuestra primera oportunidad de utilizar dos chips especializados de súper alta potencia».
Para los compradores empresariales, las implicaciones son concretas. Clientes que realizan ajustes o capacitación a gran escala en Google Cloud y clientes que atienden a agentes de producción en IA de vértice Han estado alquilando los mismos aceleradores y comiéndose la ineficiencia. V8 es la primera generación en la que el silicio mismo los trata como problemas diferentes con dos conjuntos de chips.
TPU 8t: un tejido de entrenamiento que escala hasta un millón de chips
Sobre el papel, el TPU 8t es un paso generacional agresivo. Según Google, 8t ofrece 2,8 veces los EFlops FP4 por pod (121 frente a 42,5) frente a Ironwood, el TPU de séptima generación que se lanzó en 2025, duplica el ancho de banda de ampliación bidireccional a 19,2 Tb/s por chip y cuadruplica la red de ampliación a 400 Gb/s por chip. El tamaño del pod crece modestamente de 9.216 a 9.600 chips, mantenidos unidos por la topología 3D Torus de Google.
El número que más importa a los líderes de TI que evalúan dónde ejecutar la capacitación a escala de frontera: los clústeres de 8t (Superpods) pueden escalar más de 1 millón de chips TPU en un solo trabajo de capacitación a través de una nueva interconexión que Google llama red Virgo.
8t también presenta TPU Direct Storage, que mueve datos desde el nivel de almacenamiento administrado de Google directamente a HBM sin los saltos habituales mediados por la CPU. Para ejecuciones de entrenamiento largas donde el tiempo del reloj de pared es el factor que genera costos, colapsar esa ruta de datos reduce la cantidad de horas de pod necesarias para finalizar cada época.
TPU 8i y Boardfly: Reingeniería de la red para agentes
Si 8t es un paso evolutivo, TPU 8i es el chip con mayor interés arquitectónico. También es donde la historia para los compradores de TI se vuelve más convincente.
Los saltos en las especificaciones año tras año son, como dijo Vahdat, «impresionantes». Según Google, 8i ofrece 9,8 veces los EFlops FP8 por pod (11,6 frente a 1,2), 6,8 veces la capacidad de HBM por pod (331,8 TB frente a 49,2) y un tamaño de pod que crece 4,5 veces de 256 a 1152 chips.
Lo que impulsó esas cifras es un replanteamiento de la propia red. Vahdat explicó la idea directamente: la forma predeterminada de Google de conectar chips admitía el ancho de banda sobre la latencia, lo que es bueno para mover grandes cantidades de datos, no diseñado para el tiempo mínimo que toma una respuesta para regresar. Ese perfil sirve para entrenar. Para los agentes, no es así. En asociación con Google DeepMind, el equipo de TPU creó lo que Google llama topología Boardfly específicamente para reducir el diámetro de la red, reduciendo la cantidad de saltos entre dos chips cualesquiera en un pod. Junto con un motor de aceleración colectiva y lo que Google describe como SRAM en chip muy grande, 8i ofrece una mejora de 5 veces la latencia para el muestreo LLM en tiempo real y el aprendizaje por refuerzo.
El foso de la integración vertical: por qué Google no paga el «impuesto Nvidia»
El subtexto de la presentación de Vahdat fue un diagrama de seis capas que Google llama su pila de IA: energía en la base, luego terreno y recintos del centro de datos, hardware de infraestructura de IA, software de infraestructura de IA, modelos (Gemini 3) y servicios en la parte superior. Vahdat señaló que diseñar cada capa de forma aislada te obliga a utilizar el mínimo común denominador para cada capa. Google los diseña juntos.
Aquí es donde cristaliza la historia competitiva para los compradores y analistas de TI. OpenAI, Anthropic, xAI y Meta dependen en gran medida del silicio de Nvidia para entrenar sus modelos de frontera. Cada GPU H200 y Blackwell que compran conlleva el margen bruto del centro de datos de Nvidia: el «impuesto Nvidia» informal que los analistas de la industria han señalado durante dos años consecutivos como una desventaja de costos estructurales para cualquiera que alquile en lugar de diseñar. Google paga costos de fabricación, embalaje e ingeniería por sus TPU. No paga ese margen.

Qué significa v8 para la carrera informática: una nueva lista de verificación de evaluación para líderes de TI
Para los equipos de adquisiciones e infraestructura, TPUv8 replantea la evaluación de la nube 2026-2027 de manera concreta.
Los equipos que entrenan grandes modelos propietarios deben considerar las ventanas de disponibilidad de 8t, el acceso a la red Virgo y los SLA de buen rendimiento, no solo los EFlops principales. Los equipos que atienden a agentes o cargas de trabajo de razonamiento deben evaluar la disponibilidad de 8i en Vertex AI, los puntos de referencia de latencia independientes a medida que surgen y si el tamaño de HBM por módulo se ajusta a sus ventanas de contexto. Los equipos que consumen Gemini a través de Gemini Enterprise deberían heredar el 8i lift y deberían esperar que el límite de lo que pueden implementar en producción aumente significativamente hasta 2026.
Las advertencias son reales. La disponibilidad general aún es «más adelante en 2026». La versión 8 es una señal de hoja de ruta, no una decisión de adquisición actual. Los puntos de referencia de Google son autoinformados; Sin duda, durante los próximos dos trimestres las cifras independientes provendrán de los primeros clientes de la nube y de evaluadores externos. Y la portabilidad entre JAX/XLA y el ecosistema CUDA/PyTorch sigue siendo un costo de fricción en el que vale la pena pensar al negociar cualquier compromiso de varios años.
Mirando más allá, Vahdat hizo dos predicciones dignas de mención. En primer lugar, las CPU de uso general resurgirán dentro de los sistemas de IA, no como aceleradores, sino como computación de orquestación para entornos aislados de agentes, máquinas virtuales y ejecución de herramientas. En segundo lugar, la especialización, enmarcada explícitamente como una predicción de la industria en lugar de una vista previa de la hoja de ruta de Google, también sigue siendo fuerte. A medida que las CPU de uso general se estabilizan en un pequeño porcentaje anual, las cargas de trabajo importantes exigirán silicio diseñado específicamente. «Dos chips podrían convertirse en más», dijo Vahdat, sin especificar si «más» significaría futuras variantes de TPU u otras clases de aceleradores especializados.
La carrera informática fronteriza solía ser una cuestión de quién podía comprar más H100. Ahora es una cuestión de quién controla la pila. La lista corta de empresas que realmente lo hacen es, por el momento, dos: Google y Nvidia.


Suscríbete y recibe las historias más importantes del día.
Al suscribirte aceptas nuestros términos y condiciones y política de privacidad.