






































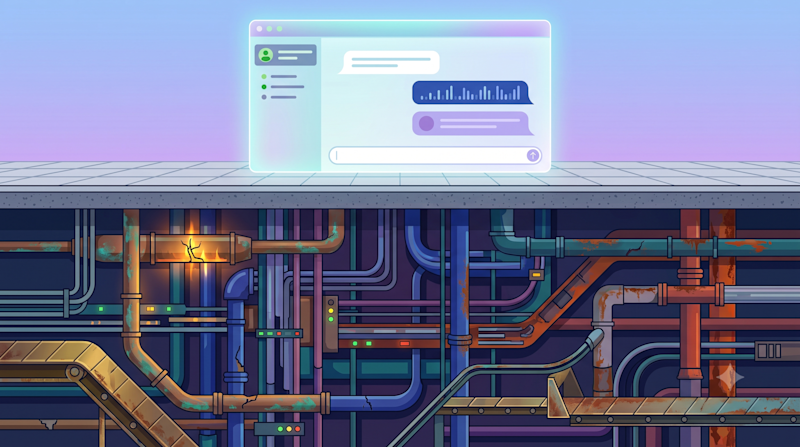
Pasas semanas ajustando un chatbot de IA. Las respuestas son precisas. Las partes interesadas lo aprueban y usted lo envía. Tres meses después, el sistema se equivoca con seguridad en aproximadamente un tercio de lo que preguntan los usuarios. Nadie cambió el modelo y nadie tocó las indicaciones. El mundo se movió, los precios cambiaron, una política se actualizó, una especificación de producto envió una nueva versión y el almacén de conocimientos subyacente no se movió con ello.
Esto no es hipotético. Es uno de los modos de falla de producción más comunes en la IA empresarial en este momento, y la mayoría de los equipos de ingeniería de datos no tienen las herramientas adecuadas para detectarlo, independientemente de cómo el sistema de IA recupere los datos.
El fracaso que no parece un fracaso
A una aplicación de IA no le importa si la recuperación se realiza desde un almacén de vectores, un índice de documentos o una llamada API. Cualquiera que sea el mecanismo, nada en un proceso de recuperación estándar verifica si lo que está sirviendo sigue siendo correcto. Un documento de precios obsoleto se recupera con tanta confianza como uno actual, porque el sistema califica la relevancia o la disponibilidad, no la exactitud. Un registro al que le falta un campo silenciosamente pasa tan limpiamente como uno completo, por la misma razón.
Entonces el fallo es invisible por diseño. Los datos desactualizados o incompletos aún obtienen una alta relevancia en términos de relevancia o pasan todas las comprobaciones para las que se creó una canalización de datos. El modelo responde con total confianza porque el contexto recuperado parece autorizado. Todos los paneles que estás viendo permanecen en verde. El sistema parece estar funcionando. Simplemente está mal.
He visto suceder una versión similar de esto fuera del contexto de la IA, en un canal de tecnología financiera. Un sistema ascendente cambió un campo sin notificar a los usuarios intermedios. El oleoducto no falló; simplemente propagó valores incorrectos en los paneles porque el sistema solo verificaba si el trabajo se había completado, no si los datos seguían siendo correctos. El problema surgió sólo cuando un cliente notó algo inconsistente. Para entonces, los datos erróneos ya se habían trasladado hacia abajo.
Ya sea que se trate de un documento obsoleto o de un campo que ha desaparecido silenciosamente, la forma del fallo es la misma: la ausencia de un error no es la presencia de corrección y, sin crear capas de validación adecuadas, nada en el proceso podría identificar el problema.
Por qué esto es un problema de ingeniería de datos
Los equipos que sufren este fallo tienden a diagnosticarlo erróneamente y tienden a hacerlo dos veces.
Culpar al modelo: El primer instinto es culpar al modelo, probar con un LLM diferente y ajustar el mensaje. El verdadero problema radica más arriba, en la capa de ingeniería de datos, el mismo instinto detrás del fracaso de las fintech mencionado anteriormente: el monitoreo creado para el oleoducto, no para los datos.
Culpar a la capa de recuperación: Una vez que se descarta el modelo, el siguiente instinto es culpar a la capa de recuperación o contexto y comprar uno mejor. El momento no es una coincidencia: a medida que las empresas introducen estos sistemas en el mundo de la producción real, esta brecha es exactamente lo que está empezando a surgir, y la respuesta de los proveedores ha estado en todas partes.
-
AWS solo entró en la carrera de la «capa de contexto» con un gráfico de conocimiento que aprende del uso de los agentes.
-
Los nuevos Horizon Context y Cortex Sense de Snowflake se dirigen al síntoma exacto esta pieza abrió con: agentes que dan respuestas equivocadas y seguras porque nada gobierna la lógica empresarial subyacente.
Ambas son respuestas reales a un problema real, pero se encuentran en una capa por encima de él; un gráfico de conocimiento todavía depende de lo que lo alimenta.
El verdadero problema se encuentra más arriba, en la capa de ingeniería de datos. Los equipos verifican si un trabajo se ejecutó, no si los datos que movió siguen siendo ciertos, un instinto que precede a la IA por años. El monitoreo está diseñado para el proceso, no para los datos.
Lo que realmente falta: observabilidad de los datos
La observabilidad de los datos es un concepto bien conocido que no recibe suficiente atención en cuanto a cómo se implementa realmente. La métrica relevante no es un porcentaje, sino la cobertura: qué fracción de conjuntos de datos críticos tienen un linaje que es realmente consultable, en lugar de vivir solo en la cabeza de alguien.
Uber construyó un plataforma dedicada a la calidad y observabilidad de los datos mucho antes de que existiera la generación de recuperación aumentada. Su plataforma Unified Data Quality admite más de 2000 conjuntos de datos críticos y detecta alrededor del 90 % de los incidentes de calidad de los datos antes de que lleguen a los consumidores intermedios.
Netflix resolvió una parte diferente del mismo problema, construir un sistema de linaje de datos para toda la empresa para que cualquiera pudiera responder de dónde vino un conjunto de datos y qué lo tocó en el camino. Asigna dependencias entre temas de Kafka, modelos de aprendizaje automático y experimentación, no solo tablas de almacén. Al igual que Uber, la plataforma fue construida para humanos y ahora se ha vuelto más importante con el aumento de las aplicaciones de IA/LLM.
Entre ellos, Uber y Netflix cubren dos de las cuatro cosas por las que vale la pena construir. En la práctica, lo considero como cuatro dimensiones, cada una de las cuales se puede medir en sus propios términos.
Exactitud: ¿Cada registro se ajusta a la forma y las reglas que se supone, tipos de campo correctos, sin valores nulos inesperados, valores dentro del rango? Herramientas como Grandes expectativas y Soda maneje esto bien: validación automatizada a nivel de filas y columnas en lugar de verificaciones manuales después de que algo se rompa. Realice un seguimiento del porcentaje de registros que pasan la validación por ejecución.
Frescura: ¿Están los datos todavía actualizados en relación con su fuente, no solo actualizados desde su última verificación? Realice un seguimiento del tiempo desde la última actualización exitosa por fuente, con un SLA por conjunto de datos en lugar de un umbral general, ya que algunas fuentes necesitan una actualización cada hora y otras no.
Consistencia: ¿El mismo hecho se lee de la misma manera en todos los lugares donde está almacenado o indexado? Esto falla silenciosamente, sólo aparece cuando dos sistemas alimentados por la misma fuente comienzan a no estar de acuerdo. Una verificación cruzada periódica entre los destinos posteriores, que señale la tasa de desajuste por encima de un umbral, es suficiente para detectarlo temprano.
Linaje: ¿Puedes rastrear cualquier salida hasta su fuente y cada transformación por la que pasó? La misma pregunta para la que Netflix construyó su sistema.
Nada de esto requiere una infraestructura que la mayoría de los equipos de datos no tengan ya. Lo sé porque lo he construido, no sólo lo he defendido.
En segurolos datos del cliente llegaron en cualquier forma que el cliente quisiera enviarlos y, en ocasiones, silenciosamente mal. El desafío era construir un sistema donde se pudieran identificar datos incorrectos antes de que se propagaran hacia abajo. Se aplicaron los mismos principios: validar lo que llegó, comprender de dónde vino y evitar que los datos incorrectos se conviertan en el problema de otra persona.
Great Expectations se convirtió en parte de esa base: validación de esquemas y rangos en el momento de la ingesta, acuerdos de nivel de servicio por fuente para la actualización, comprobaciones entre sistemas para garantizar la coherencia y linaje a nivel de archivos. Todo ello estaba detrás de un escribir-auditar-publicar El patrón, donde los datos llegaron a la etapa de preparación, se validó y solo se movió hacia abajo si pasó las verificaciones requeridas.
El resultado se mostró en el futuro: mayor precisión en todos los ámbitos, en los informes, en los modelos de aprendizaje automático y en la recuperación de IA basada en esos mismos datos.
Qué hacer el lunes por la mañana
Si está ejecutando sistemas de IA basados en recuperación en producción, la pregunta de diagnóstico no es qué modelo probar a continuación o a qué arquitectura de recuperación migrar. Son cuatro preguntas más específicas:
-
¿Los datos subyacentes están validados según los estándares requeridos por sus consumidores?
-
¿Cuál es el contenido más antiguo que se ofrece actualmente con alta confianza?
-
¿Dos fragmentos de la misma fuente alguna vez discreparían entre sí en el mismo resultado de recuperación?
-
¿Podrías rastrear de dónde vino si resultase incorrecto?
Si no puede responder esas preguntas, entonces la brecha se encuentra en la tubería entre sus sistemas fuente y lo que sea que lea su agente. Se trata de una solución de ingeniería de datos, no de un cambio de modelo ni de una migración de proveedores.
Ya sea que esté creando canales de informes, sistemas de aprendizaje automático o agentes de inteligencia artificial, la corrección, la actualidad, la coherencia y el linaje son los que hacen que los datos sean confiables. La IA simplemente expone las debilidades que han existido en la ingeniería de datos desde siempre.


Suscríbete y recibe las historias más importantes del día.
Al suscribirte aceptas nuestros términos y condiciones y política de privacidad.